9.6 社区资源与学习路径
9.6 社区资源与学习路径
手册读完,下一步往哪走
本篇是第 9 章第 6 节,也是全册收尾,给出持续成长的路标,让这本教程成为起点而非终点。
官方文档与 wiki 是第一手资料,步骤用法、XML 结构都以它为据。我们遇到陌生步骤先查官方,再搜社区,避免被过时博客带偏。官方虽朴素但是权威,这点踩坑多次后成了共识。
源码值得一看。Kettle 是开源的,某个步骤行为说不清时,直接读对应插件的 Java 源码,比猜快。我们团队有过「某个 hop 为何丢行」靠读源码十分钟定位的经历,比论坛求助高效。
社区渠道:邮件列表、StackOverflow 的 kettle 标签、中文技术博客。我们建议带着最小复现去问,附上 ktr 片段和日志,比「为什么不行」更易得到答案。会提问也是能力。
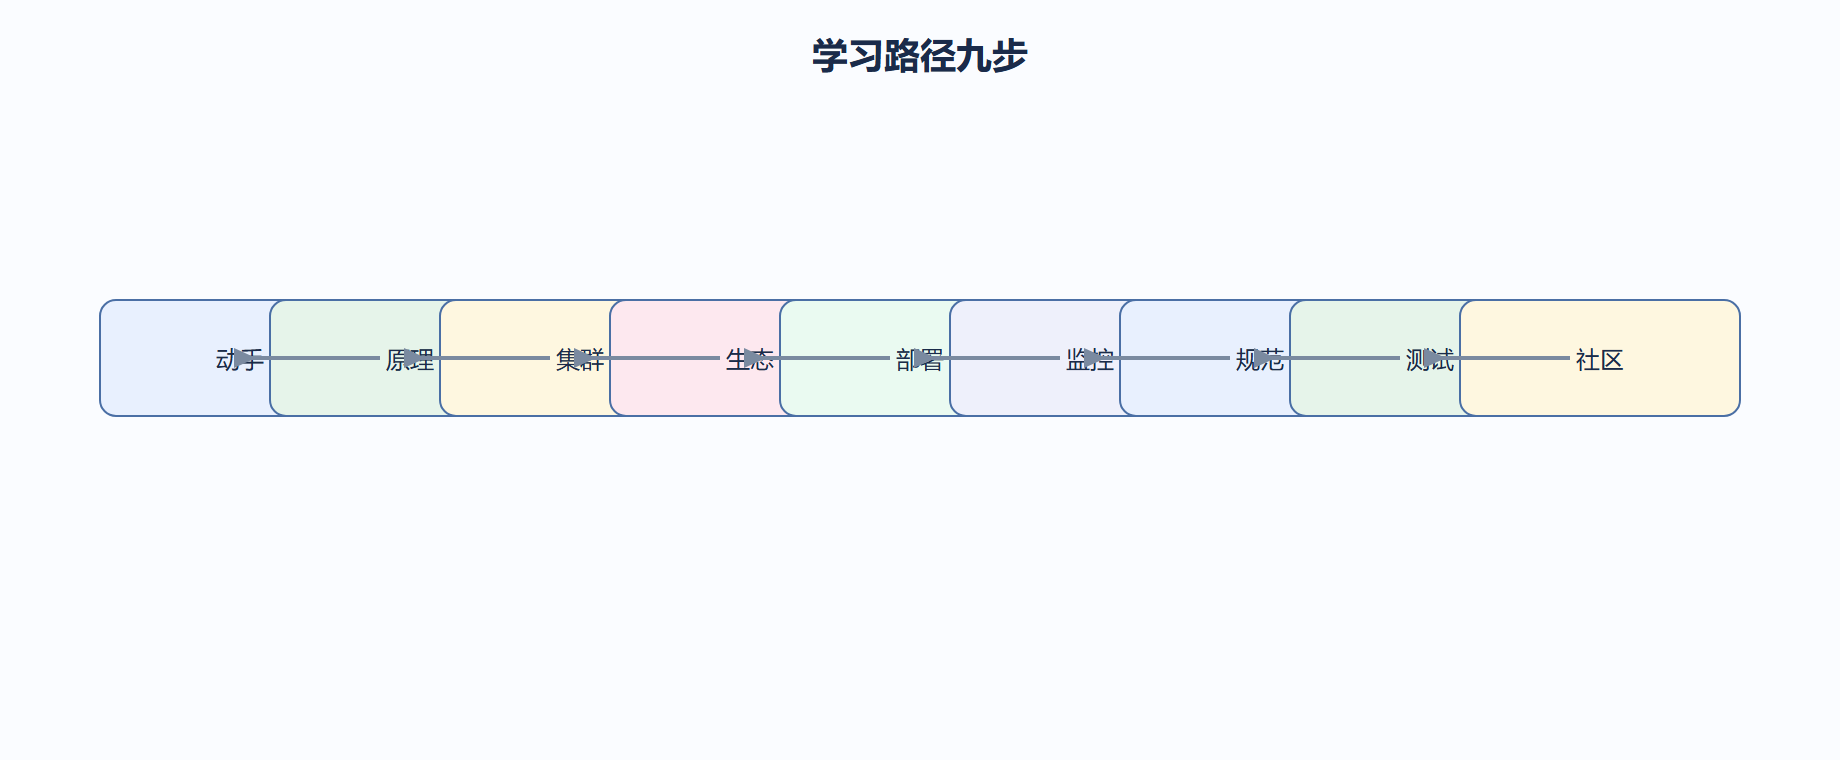
学习路径上,我们推荐「先动手小项目→再读原理→再碰集群与生态」的顺序,正好对应本册九章。跳着学容易在原理处卡住,因为后面每章都踩着前面的肩。循序渐进比贪快踏实。
沉淀属于自己的片段库:把验证过的转换片段(如通用地址标准化、通用增量抽取)存成模板,下次直接复用。我们内部有个 snippet 仓库,新人入职先读,交付速度明显提升。这也是把本书知识变成团队资产的方式。
关键代码与配置
下面这段 bash 给出了可直接落地的配置,输入来自上一步、输出写入目标端:
# 拉源码对照陌生步骤行为 git clone https://github.com/pentaho/pentaho-kettle # 读 processRow() 看清每行处理逻辑
读源码是终极排错法。我们遇到文档说不清的行为,直接看 processRow,十分钟顶论坛一天。
内部 snippet 仓库结构: /extract_incremental 通用增量抽取模板 /address_std 地址标准化子转换 /quality_check 数据质量校验片段 # 新人先读,交付直接复用,避免重复造轮子
把验证过的片段沉淀成模板库,是知识从个人变团队的关键一跃。我们靠它缩短交付周期。
背景
某「过滤」步骤行为不符合预期,发帖描述模糊,三天没准信,项目卡住。
操作
决定读该步骤源码的 processRow,发现条件是按字符串比较导致数字不匹配。
// 源码示意:原比较走了字符串 if (inputRow.getValue().equals(target)) { ... } // 改为按数值比较后即正常
结果
确认是类型比较坑,修正输入类型后行为正确,项目当天解锁。
解读
根因是只依赖二手资料。权威在源码,尤其行为诡异时,读代码比问人快且准。这条值得刻进习惯。
变式
更优是把这次的坑写进内部 snippet 的备注,变成团队知识,避免下个人再掉同个坑。
常见误区与工程取舍
误区:只信博客。陌生步骤先查官方,再读源码,论坛作补充。
误区:跳着学。按本册九章顺序,后面踩前面肩。
取舍:沉淀 snippet 库;提问带最小复现与日志,效率最高。
深入:社区资源与持续学习路径
Kettle(PDI)有长期活跃的开源社区:官方文档讲全步骤参考,社区论坛与问答站有大量真实排错案例,GitHub 上的示例仓库能直接借鉴现成转换模板。持续学习的路径建议:先吃透官方「Getting Started」与步骤参考,再按你常踩的坑搜社区帖,最后尝试读 .ktr 的 XML 源码——当你能直接看懂元数据,就脱离了「只会点界面」的阶段。把学到的复用子转换与连接模板沉淀进团队公共库,知识才真正变成资产。
# 推荐学习路线(节选) 1. 官方 PDI 文档:步骤参考 + 入门指南(建立术语体系) 2. 社区问答:按报错信息搜,九成坑有人踩过 3. 读 .ktr 源码:理解元数据即 XML,脱离纯界面依赖 4. 沉淀:把通用子转换/连接模板入库,反哺团队 # 学而不沉淀,等于没学——知识要进公共库才算资产
⚠️ 常见坑(学习路径)
- 只学点界面:遇复杂需求仍不会,要懂底层 XML 与原理。
- 不沉淀复用:每次从零画,重复造轮子浪费工时。
- 忽略官方文档:社区帖良莠不齐,以官方参考为锚更稳。
💡 关键直觉
- 真正拉开差距的,是「能读元数据源码 + 会沉淀复用」这两步,而非会画多少步骤。
- 社区是排错加速器,但要以官方文档为判断基准,避免被过时帖带偏。
| 阶段 | 重点 |
|---|---|
| 入门 | 官方文档 |
| 进阶 | 读 XML 源码 |
| 高阶 | 沉淀复用 |
工程实录:读源码脱离纯界面
只会点界面,遇复杂需求仍不会,依赖老人。
读 .ktr 的 XML 源码,理解元数据即文本,并沉淀复用。
学习路线: 1. 官方 PDI 文档:步骤参考+入门 2. 社区问答:按报错搜,九成坑有人踩 3. 读 .ktr 源码:脱离纯界面依赖 4. 沉淀:通用子转换/连接模板入库
能力从「会画」升级到「懂底层」,可独立排错。
读源码+沉淀复用,是拉开差距的两步。
社区帖以官方文档为锚,避免被过时帖带偏。
参数与阈值速查
| 阶段 | 重点 |
|---|---|
| 入门 | 官方文档 |
| 进阶 | 读 XML |
| 高阶 | 沉淀复用 |
现场口诀
真正拉开差距的是「能读元数据源码 + 会沉淀复用」这两步,而非会画多少步骤。读 .ktr 的 XML 让你脱离纯界面依赖,沉淀通用子转换与连接模板让经验变成团队资产。社区帖以官方文档为锚,避免被过时内容带偏。
补充:学而不沉淀等于没学。每解决一个真实问题,就把对应的子转换或连接模板入库,下次直接复用而非从零再画。社区是排错加速器,但真正的能力增长来自「读源码理解 + 沉淀复用」的闭环,而非收藏一堆打不开的链接。
真正的能力差距来自「读元数据源码 + 沉淀复用」:读 .ktr 的 XML 让你脱离纯界面依赖,沉淀通用子转换与连接模板让知识变成团队资产。社区问答以官方文档为锚,避免被过时帖带偏。学而不沉淀等于没学,每次解决问题都把模板入库,下次直接复用。
另外提醒一点:社区与文档是"查得到答案"的来源,但把知识变成能力的唯一路径是自己动手。建议给自己定一个月的刻意练习计划:第一周重做一遍本教程的 Transformation 与 Job 案例;第二周把工作中一个手工脚本迁移成 Kettle 作业;第三周尝试读一个陌生 .ktr 文件的 XML 并还原出它的步骤;第四周沉淀出自己的子转换模板库。四周下来,你对 Kettle 的掌握会超过多数"看了很多教程但没动手"的人。