第一章:LEANN概述与核心概念
第一章:LEANN概述与核心概念
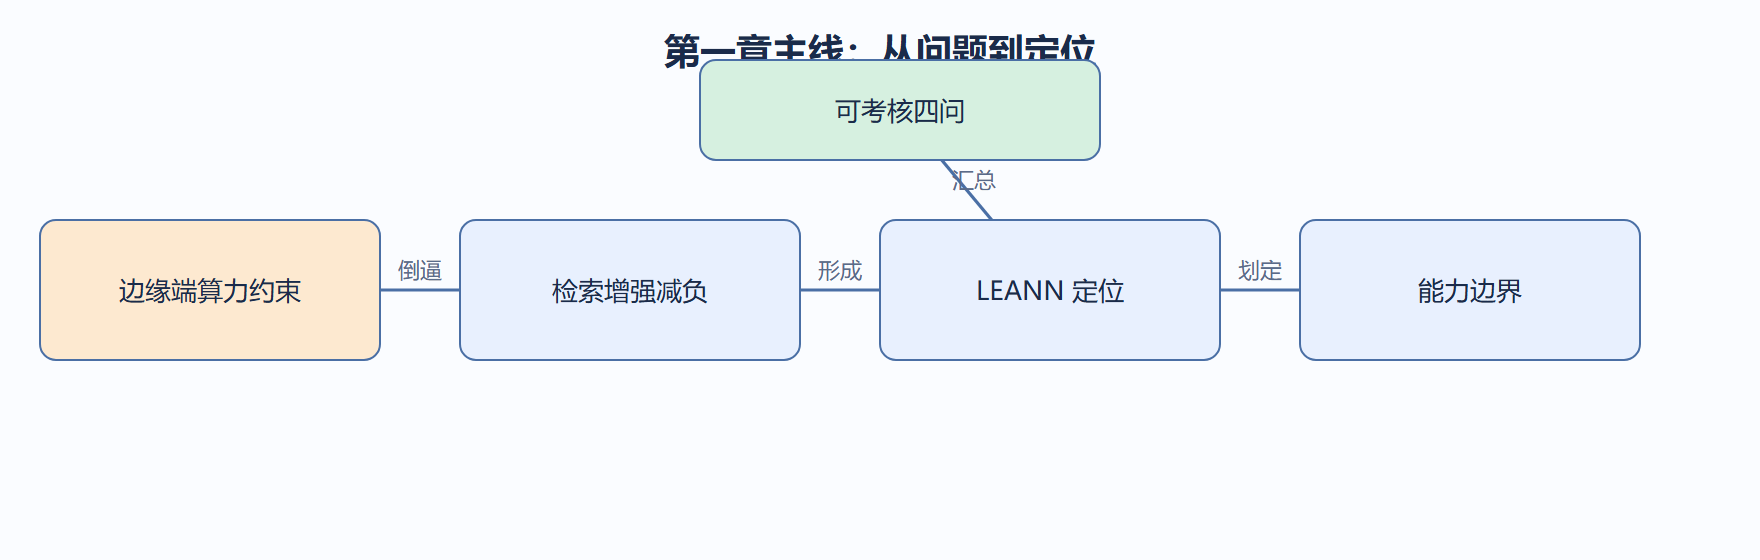
本章跟着一条线走:先问「为什么边缘设备需要轻量神经架构」,再看检索增强如何给小模型减负,接着定位 LEANN 的角色与能力边界,最后落到四个可以考核的知识点。
我们先把「轻量」和「神经架构」拆开理解。轻量指的是参数量、显存占用、推理延迟都受约束;神经架构指的是系统里确实有一段可训练的网络,负责把检索回来的候选做语义重排,而不是简单按相似度排序。两者合起来,LEANN 的灵魂是「小网络 + 外部记忆」的分工。
本章不写代码,先把三个判断装进脑子。第一,LEANN 不是把大模型缩小,而是换了一种智能的组织方式。第二,它的强项在「知识密集但可检索」的任务,弱项在「需要长链条推理且不可检索」的任务。第三,它的工程价值来自可控:内存上限、延迟上限都能提前算出来。
读完本章你应该能回答四个问题:LEANN 的定义与目标是什么;它的发展历程和开源生态怎样;它的核心特性相比纯向量库好在哪;哪些场景它真正合适。这四个问题就是本章的可考核知识点。
四节是怎么安排的
- 1.1 定义与目标:先立定义,把「检索增强」与「轻量级」两个限定词拆开,各讲清解决什么约束,再给一个用 numpy 写的最小重排头,让你直观看到「网络只负责重排、知识留在外部」的分工长什么样。
- 1.2 发展历程与开源生态:讲清 LEANN 是从哪一类工程需求里长出来的,和已有的向量库、嵌入模型生态是什么关系,帮你判断它的成熟度与可借鉴对象。
- 1.3 核心特性与优势:把它与「纯向量检索」逐项对比,说清多了什么、少了什么、代价在哪,避免把它当成包打天下的工具。
- 1.4 典型应用场景:给一把「长尾 × 可检索」两轴判定尺,配真实剖面案例,让你能对着自己的业务做可行性预检。
学本章前要确认的几件事
- 会用 Python 基础语法,能读懂 numpy 数组运算即可,本章不涉及嵌入式知识。
- 知道向量是什么、余弦相似度的大致含义,不需要会推导公式。
- 不用提前准备硬件,本章全部结论在普通电脑上就能验证。
- 如果你在边缘设备上做过任何部署,哪怕只是跑通一个 demo,理解本章会快得多。
常见的三个认知偏差
- 把 LEANN 当成「压缩版大模型」:它不是,它是「小网络 + 外部记忆」的结构性分工,不是参数缩减。
- 以为检索增强只在云端有价值:恰恰相反,它的主战场正是算力受限的边缘端,云端只是它的验证场之一。
- 跳过 1.4 直接进入第二章:场景判断决定你该不该学下去,先花十分钟对照自己的业务过一遍,再决定投入多少。
章节间的依赖关系
- 第一章是纯概念层,不依赖后续任何章节,可以先读后放,不影响主线。
- 第二章的嵌入、索引、检索、重排四模块,正是第三章动手时你要真刀真枪跑起来的对象,概念先在这里对齐。
- 第四章的混合检索会用到第二章的相似度概念;第五章的性能调优要基于第三章的 API 才能测量,所以建议按顺序推进。
- 若时间紧,可先精读 1.1 与 1.4,中间两节放到读完第二、三章后再回补,不会断掉主线。
本章的学习目标再收敛
第一章的四个知识点不是并列的,而是递进的:先接受定义,再知道来历,接着对比优势,最后判断场景。递进的意义在于——只有走完四步,你才具备「对业务说清楚 LEANN 该不该用」的能力,这正是后续章节所有工程动作的前提。建议学完后用一句话向同事复述定义,如果一句话讲不清,回 1.1 再看一遍。
知识地图:读完本章你的脑子里该有的结构
- 一个定义:检索增强为骨架、轻量网络为决策头的架构范式。
- 两条轴:长尾与可检索,用来判断场景。
- 三个判断:不是缩小大模型、强项在可检索任务、工程价值在可控。
- 四个问题:定义、历程、特性、场景,即本章可考核点。
这张地图就是本章的压缩版,也是你进入第二章前该有的全部认知。
下一章我们会掀开盖子,看这套分工在内部到底由哪些模块组成、数据怎么流动。
评论区
(0)
U