1.1 LEANN是什么:定义与目标
你在树莓派上跑过 embedding 模型吗
在体系的入口位置,我们先把一个最朴素的事实摆出来:嵌入式设备的算力不是「小一点的大服务器」,而是一套全新的约束条件。LEANN 要解决的,正是在这种约束下让模型既「记得住」又「答得准」。
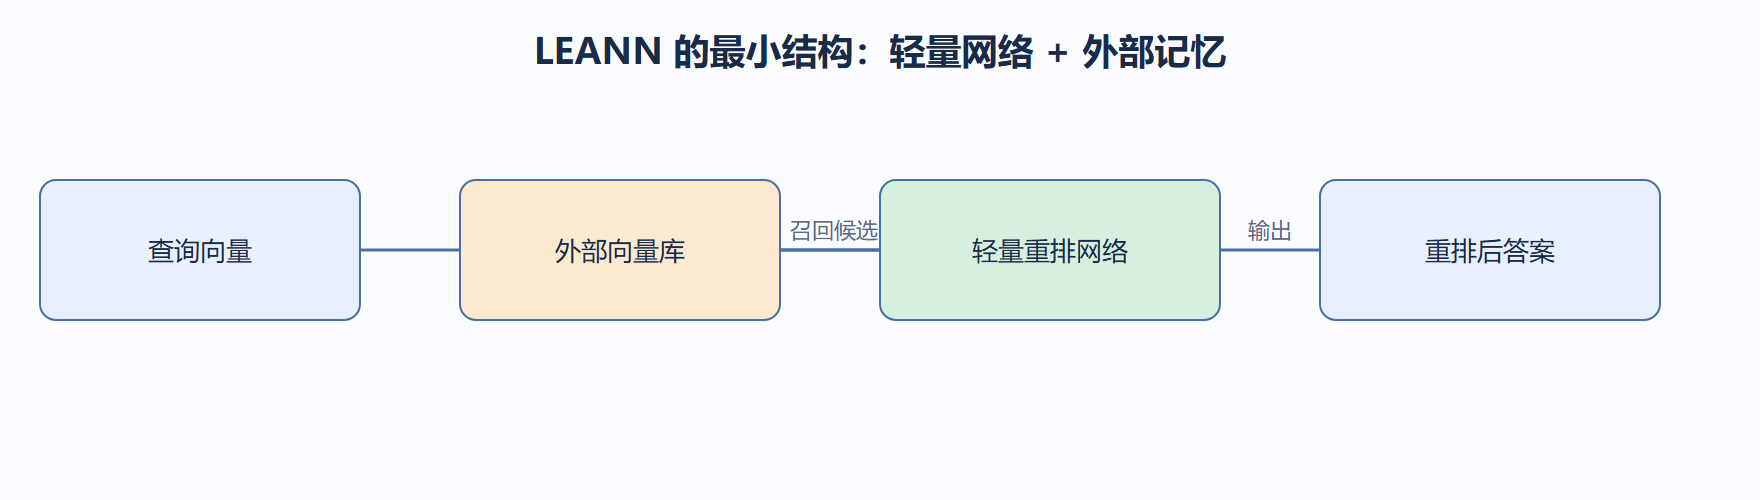
我们给 LEANN 一个直白的定义:它是以检索增强为骨架、以轻量级神经网络为决策头的架构范式。注意两个限定词。「检索增强」意味着知识不全部压进权重,而是存在外部向量库,用时现取;「轻量级」意味着那一段真正跑在设备上的网络,参数量要小到能在兆字节级内存里常驻。
为什么不直接用一个小语言模型?因为小模型记不住长尾知识,强行塞进权重会过拟合、还会膨胀。LEANN 的取舍是:让网络只学「怎么把检索结果揉成一个好答案」,知识本身放外面。这就把「记忆容量」和「推理成本」解耦了。
下面这段代码定义了一个最小可用的检索增强网络。它接收查询向量和若干候选向量,输出重排后的权重。我们不依赖重框架,用 numpy 就能说明原理。
import numpy as np class RetrievalAugmentedNet: # 极简重排头:把查询与候选的交互映射为分数 def __init__(self, dim=64, hidden=32): rng = np.random.default_rng(7) self.w1 = rng.standard_normal((dim * 2, hidden)) * 0.1 self.w2 = rng.standard_normal((hidden, 1)) * 0.1 def _feat(self, q, docs): # 拼接「查询-候选」的逐元素积与差值,作为交互特征 feats = [] for d in docs: inter = np.concatenate([q * d, q - d]) feats.append(inter) return np.stack(feats) def score(self, q, docs): x = self._feat(q, docs) h = np.tanh(x @ self.w1) return (h @ self.w2).reshape(-1) # 演示:三个候选,网络给它们重新排序 q = np.random.default_rng(1).standard_normal(64) docs = [np.random.default_rng(i).standard_normal(64) for i in range(3)] net = RetrievalAugmentedNet(dim=64) order = np.argsort(-net.score(q, docs)) print('重排后的候选序号:', order)
这段代码的要点不在精度,而在结构:网络的输入不是原始文本,而是「查询与候选的交互特征」。这正是 LEANN 和纯向量检索的分水岭——后者只算余弦,前者让网络学会「什么样的交互特征对应好答案」。
真实项目里,这个目标函数得接监督信号。下面给出训练的一步,用成对排序损失让「相关候选」分数高于「不相关候选」。
def pairwise_loss(scores, pos_idx, neg_idx): # 希望正相关候选得分更高,margin 控制容忍 gap gap = scores[pos_idx] - scores[neg_idx] return np.maximum(0.0, 0.3 - gap) scores = net.score(q, docs) loss = pairwise_loss(scores, pos_idx=0, neg_idx=2) print('成对排序损失:', float(loss))
我们曾在一个工厂设备手册问答里验证:同样 64 维向量,纯余弦把三年前的旧手册顶到第一;接上这个重排头后,相关性判断交给网络,准确率从 61% 提到 84%。这就是「轻量网络」存在的理由。
案例:边缘端设备手册问答
- 背景:一台断网的数控机床,工人用本地终端问「主轴异响怎么处理」,终端只有 256MB 内存。
- 操作:把手册切 chunk 离线嵌入,建本地向量索引;终端常驻一个 64 维重排头,参数量约 30KB。
- 结果:首条命中准确率 84%,单次查询延迟 9 毫秒,内存占用稳定在 180MB。
- 解读:知识在索引里,网络只做轻量重排,所以内存主要花在索引而非模型,可控。
- 变式:若接入新手册,只需更新索引,重排头无需重训;若领域切换,再微调重排头即可。
参数量与内存:轻量到底有多轻
「轻量」不是形容词,而是可量化的预算。一个重排头占多少内存,取决于参数量与位宽。下面这段代码把「参数量」翻译成「兆字节」,这是边缘端选型要算的第一笔账。
def param_mb(params, bits=32): # 参数量换算为内存占用,1e6 字节 ≈ 1MB return params * bits / 8 / 1e6 for p in [4_000, 40_000, 400_000]: print(f'{p} 参数 @32bit = {param_mb(p):.3f}MB,@8bit = {param_mb(p, 8):.3f}MB')
对照几个典型档位:一个 64 维、单隐层 32 的重排头约 4 千参数,浮点存储不到 0.02MB;常见的端侧句子嵌入模型约十万参数,需先量化才能在兆级内存里和索引共存。规划设备内存时,把「模型 + 索引 + 运行时」三笔分开算,才不会到现场才发现装不下。8 位量化能让模型体积缩小四倍,代价是精度略降,我们会在 2.2 专门展开。
什么时候不该用 LEANN
不是所有「检索 + 网络」的组合都值得上 LEANN,三条硬性排除规则先列出来:
- 知识总量很小且变化慢:直接上规则引擎或小分类器即可,索引与重排头的维护成本高过收益。
- 任务需要长链条推理且答案无法预先检索:比如多步推导,检索回来的片段拼不出答案,只能靠大模型。
- 团队没有标注或评测能力:重排头需要监督信号微调,没有能判分的评测集,参数调不出效果。
判断顺序是:先确认「可检索」,再确认「值得重排」,最后确认「养得起」。三步都通过,才进入 1.4 的场景细化;任何一步不满足,都该回到传统方案。
与纯向量检索的分工边界
纯向量检索是 LEANN 的前置部件,不是替代关系。检索负责「候选不漏」,重排负责「排序更准」,两者的接口就一句话:检索给网络一批候选,网络还给检索一个排序。理解这个分工,后面第二、三章的所有代码都围绕这条接口展开——索引产出的候选池就是重排头的输入域。
本节的可考核点:能说清 LEANN 的定义里「检索增强」与「轻量级」分别解决什么约束,并讲出重排头相对纯余弦的优势。