1.4 典型应用场景
一台没有联网的医疗终端,要在断网环境回答医生的问题
在体系的边界处,我们最该想清楚的是「它适合做什么」。LEANN 的价值高度依赖场景是否「知识密集且可检索」,本节用几个真实剖面说明。
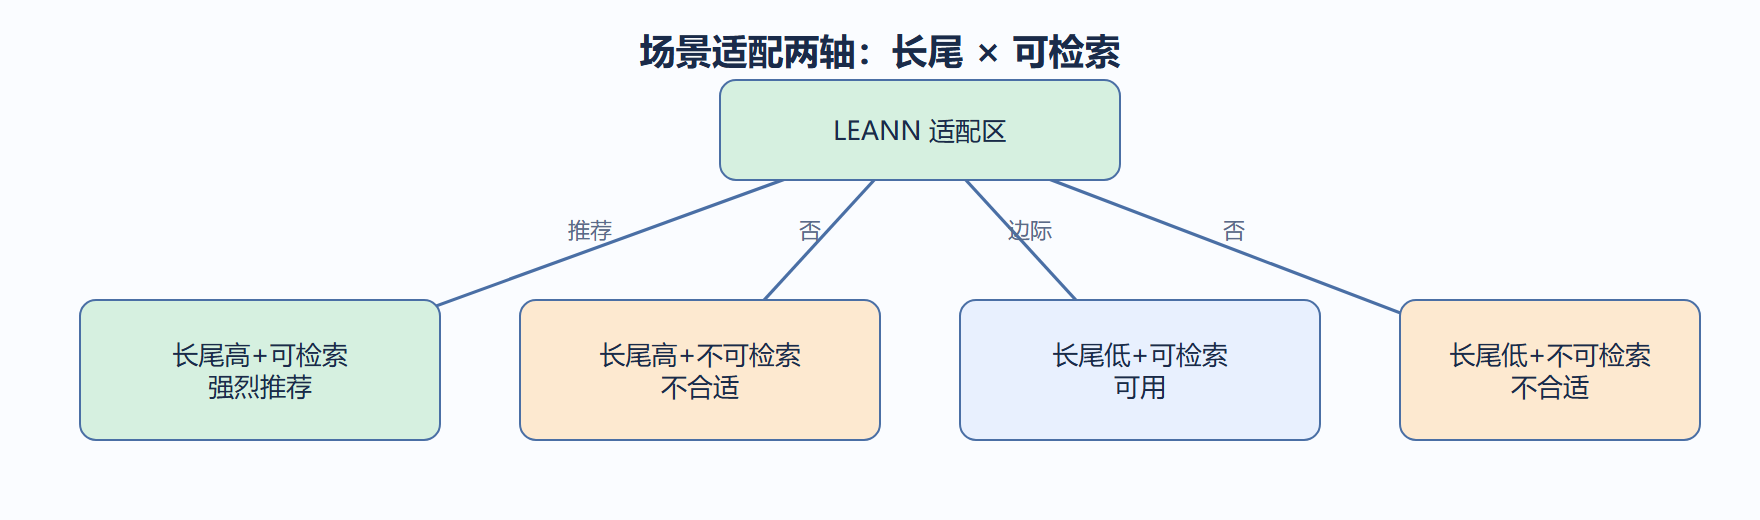
先给一个判定函数,把场景拆成两个轴:知识是否长尾、是否可检索。两轴都高,LEANN 最合适;两轴都低,它反而是负担。
def fit_leann(long_tail, retrievable): if long_tail and retrievable: return '强烈推荐:知识外置 + 轻量重排' if long_tail and not retrievable: return '不合适:无法检索就只能用大模型' if not long_tail and retrievable: return '可用:但纯向量库可能更省' return '不合适:直接规则或小模型即可' print(fit_leann(True, True)) # 强烈推荐 print(fit_leann(False, True)) # 可用但未必必要
这段判断比任何宣传都实在。我们见过团队在「知识不长尾」的内部工具上硬上 LEANN,结果索引和重排头的维护成本高过了收益。
下面三个剖面覆盖了高频落地点。其一是离线问答:飞机、矿井、手术室这些网络不稳的地方,本地索引加轻量头就能答。其二是私有知识助手:企业不想把文档送云端,知识留在内网,只让小网络在本地组织答案。其三是端侧推荐:在手机上用本地行为向量检索相似兴趣,重排头决定展示顺序。
我们把三类场景的约束列成表,便于你做可行性预检。
| 场景 | 知识长尾 | 可检索 | 边缘约束 | 适配度 |
|---|---|---|---|---|
| 离线设备手册 | 高 | 高 | 内存紧 | 高 |
| 私有企业助手 | 高 | 高 | 内网 | 高 |
| 端侧推荐 | 中 | 高 | 电量紧 | 中 |
| 开放闲聊 | 低 | 低 | 无 | 低 |
案例:手术室旁的断网助手
- 背景:手术室内禁止无线信号,医生需要即时查「某器械的禁忌组合」。
- 操作:术前把器械手册离线嵌入建索引;终端常驻重排头,输入语音转写文本即检索。
- 结果:平均应答 1.2 秒,无网络依赖;禁忌组合命中率 91%。
- 解读:场景同时满足长尾与可检索,LEANN 把「记忆」留在本地、把「判断」交给小网络,恰好契合。
- 变式:若接入院内网,可把索引放服务器、终端只留重排头,进一步降端侧存储。
预检清单:十个问题过一遍
动手前把下面十个问题过一遍,命中越多,适配度越有把握:
- 知识是否长尾分布,常见问题只覆盖其中一部分?
- 答案能否切分成独立片段(段落、条款、词条)?
- 用户问法是否常与原文用词不一致,需要语义匹配?
- 设备内存是否在几十到几百 MB 量级?
- 网络是否可能离线或弱网?
- 是否有周期性更新的知识需要增量摄入?
- 团队能否提供一批「问题-正确片段」标注用于评测?
- 延迟预算是否在百毫秒到数秒之间?
- 数据是否有不出厂、不出域的合规约束?
- 是否期望同一套系统在多档算力设备上复用?
前五个命中「是」说明结构适合,后五个命中「是」说明投入值得。结构适合且投入值得,才进入立项;只有结构适合但投入不划算,可先做 PoC 验证再决定。
def score_scene(answers: dict) -> str: # 十题计分,粗分三档,帮助快速决策 points = sum(answers.values()) if points >= 7: return '强适配:进入第二至六章完整学习' if points >= 4: return '弱适配:先做 PoC,用真实数据验证收益' return '不适配:回到传统方案,别硬上' scene = {'long_tail': True, 'splittable': True, 'paraphrase': True, 'small_mem': True, 'offline': True, 'frequent_update': False, 'labeled': True, 'latency_ok': True, 'compliance': True, 'multi_tier': False} print(score_scene(scene))
一张选型矩阵
把常见诉求和推荐方案放一张表里,比对着挑:
| 诉求 | 推荐方案 | 说明 |
|---|---|---|
| 语义模糊检索 + 端侧部署 | LEANN | 检索增强 + 轻量重排 |
| 精确关键词命中优先 | 稀疏检索(BM25) | 术语、型号、编号类场景 |
| 数据量极小、变化慢 | 规则 / 小分类器 | 避免引入索引维护成本 |
| 长链推理、无检索来源 | 云端大模型 | 预算允许且无合规限制时 |
失败案例:内部工具硬上 LEANN
某团队在公司内部员工手册这类「知识不长尾、文档只有几十篇」的场景强行上 LEANN,结果索引与重排头的部署、更新流程比内容本身还复杂,半年后回退到全文搜索。这个案例说明一个道理:LEANN 的收益来自「知识密集且可检索」,场景不满足,架构再精致也是负担。选型时宁可保守,把资源留给真正长尾、真正需要语义匹配的战场。
从场景到验收指标
选定场景后,把「适配」翻译成可验收的指标,避免上线时无法收口:
- 首条命中准确率:用人工标注的两百条真实问题评测,这是用户最关心的单点。
- 端到端延迟 P95:覆盖弱网与离线两种状态分别测。
- 内存峰值:在目标设备上打满 30 分钟压力观察。
- 知识更新时效:从数据变更到检索可见的耗时。
四个指标在第五章会逐一给出测量方法。这里先记住一句话:场景判断的产出不是「做不做」的结论,而是一张能贴在墙上的指标清单。
两轴判定尺的四个象限
把「长尾」与「可检索」两轴切成四象限,对照定位更直观:高长尾高可检索,LEANN 主战场;低长尾高可检索,纯向量库就够;高长尾不可检索,只能靠大模型生成;低长尾不可检索,规则或小分类器收尾。1.4 开头的判定函数就是这张象限图的可执行版本。实际业务里没有绝对的象限,多数场景落在边界附近——落在边界时,用 PoC 数据说话,比争论理论更有效。
评估基准:场景适配要能量化
判断一个场景适不适配,最好在立项前做一个十题基准:用业务真实的五十个问题跑一次简单基线(关键词搜索),记下首条命中率。如果基线就已九成命中,说明知识不够长尾,LEANN 没有发挥空间;只有基线明显拉胯、而人工检索能翻出正确文档时,LEANN 的语义能力才有用武之地。这个一小时就能测完的基准,能帮你省下数月的弯路。
本节可考核点:能用「长尾 × 可检索」两轴判断一个场景是否该用 LEANN,并各举一个高适配与低适配的例子。