第二章:技术架构与核心原理
第二章:技术架构与核心原理
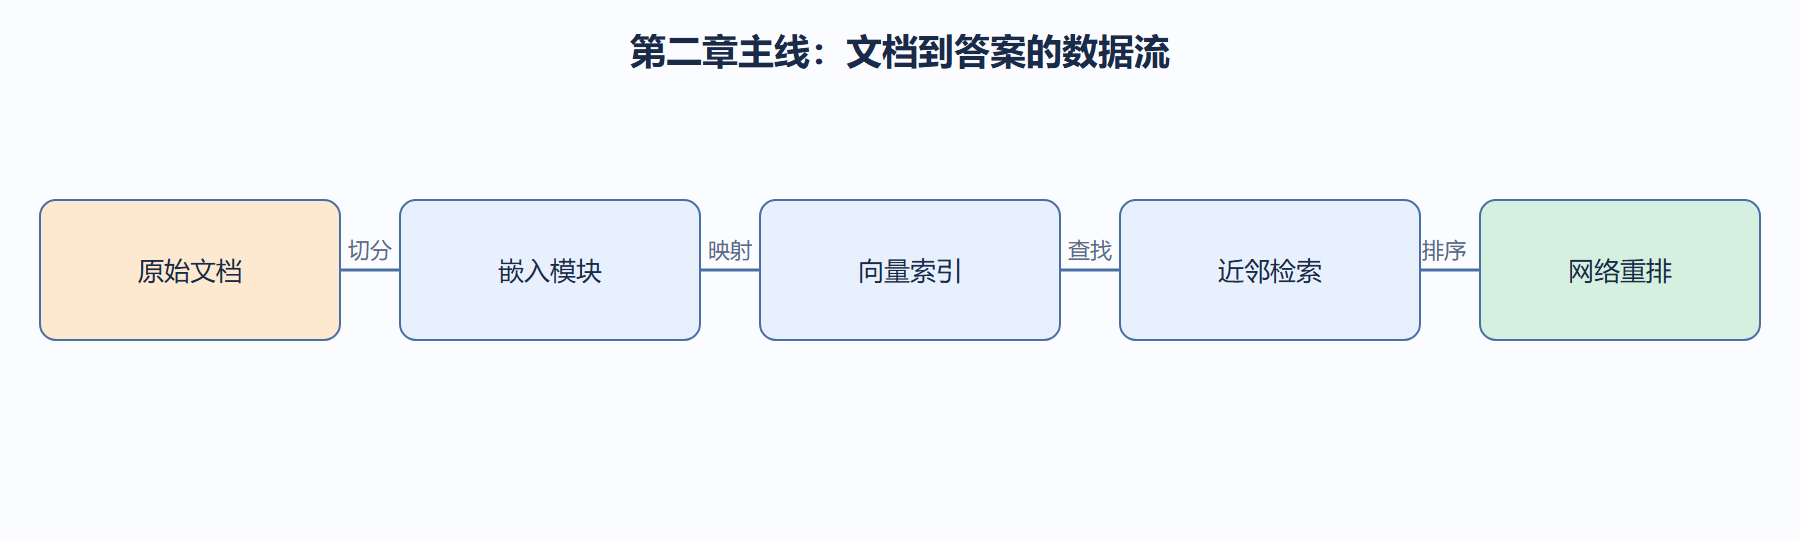
本章跟着一条线走:从一份原始文档进入系统,经过嵌入、建索引、检索、重排,最后吐出答案。沿途每一站我们都讲清它解决什么工程问题,拐点在于「为什么检索不能只靠暴力扫描」。
LEANN 的内部可以拆成四块:嵌入模块把文本变成向量;索引模块把向量组织成可快速查找的结构;检索模块在索引里找近邻;重排模块用轻量网络把候选排序。前三者是「记忆系统」,最后一个是「决策头」,分工明确。
这一章的硬骨头是索引与检索。很多人以为检索就是「算一遍余弦」,但十亿向量全量扫描在边缘端根本不可行,所以才有分层图、倒排、量化编码这些结构。我们会在 2.3 和 2.4 把它们的代价讲透。
读完本章你能考核四件事:整体架构由哪些模块组成、向量嵌入如何与模型集成、索引如何构建与存储、检索算法与相似度怎么算。下一章我们就动手把这些模块跑起来。
四节是怎么安排的
- 2.1 整体架构设计:先纠正「模块清单等于架构」的误解,用数据流向串起嵌入、索引、检索、重排四块,并讲清查询流与文档流为何要分开规划内存。
- 2.2 向量嵌入与模型集成:谈嵌入如何把语义压进向量空间,以及「检索与重排共用同一套空间」这条铁律,再落到量化带来的体积与代价。
- 2.3 索引构建与存储机制:从 flat 讲到 HNSW,把「空间换时间」的账算清楚——图结构的邻居表常被漏算,是边缘端 OOM 的常见来源。
- 2.4 检索算法与相似度计算:回答「检索时到底比什么」,讲清余弦、内积、欧氏三者的适用条件,以及 ef_search 这类旋钮怎么拨。
模块、旋钮与对应节的对照
| 模块 | 职责 | 关键旋钮 | 对应节 |
|---|---|---|---|
| 嵌入 | 把文本压成向量 | 维度、归一化、量化位宽 | 2.2 |
| 索引 | 组织向量供快速查找 | 索引类型、邻居数 m | 2.3 |
| 检索 | 从索引召回候选 | nprobe、ef_search | 2.4 |
| 重排 | 用轻量网络精排 | 网络规模、权重位宽 | 2.1 |
这张表可以当目录用:学完后能填出每个模块的旋钮,说明本章主线已经打通。
难点提示:把两笔账算清楚
本章真正的硬骨头是索引与检索。很多人以为检索就是「算一遍余弦」,但十亿向量全量扫描在边缘端根本不成立,所以才需要分层图、倒排、量化编码这些结构。读 2.3 与 2.4 时请带着两个问题:这个结构用空间换来了什么,代价是什么。能把「时间账」与「空间账」都讲清楚,这一章就算学透了。
学完自检清单
- 能否画出查询流与文档流的分叉-汇合点,并解释为何两段内存峰值不能简单相加。
- 能否解释「检索与重排共用嵌入空间」的必要性,以及量化换来的体积与精度代价。
- 能否估算百万向量、64 维、8 位量化下的索引内存(含图结构邻居表)。
- 能否根据向量是否归一化,在「内积」与「余弦」之间做出正确选择。
与前后章节的衔接
- 本章的嵌入与索引概念是第四章「高级检索」的地基,混合检索、过滤聚合都在这套结构上叠加。
- 第三章会把本章的设计落成可运行代码,建议学完第三章后回看本章的接线图,理解会加深一层。
- 第五章的性能调优会直接引用本章的 ef、nprobe、量化位宽等参数,现在记住这些旋钮的位置,后面调参不迷路。
建议的阅读节奏
本章适合一次专注的两小时:先读 2.1 的接线图建立全局,再依次啃 2.2、2.3,把 2.4 的相似度选型留到最后对照复习。若中途卡在 HNSW 的分层结构上,先跳过去看 2.3 末尾的案例,回头再补原理,不要在一个小节上耗太久。
下一章进入实践:环境怎么搭、CLI 怎么用、API 怎么写、配置怎么管。
评论区
(0)
U