2.3 索引构建与存储机制
很多人以为索引就是一张大表,结果十亿向量全量扫描
在架构的第三站,我们直面索引:它是 LEANN 能在边缘端「记得住」的根本。索引的本质是用空间换时间——用额外的结构避免每次都和全部向量比一遍。
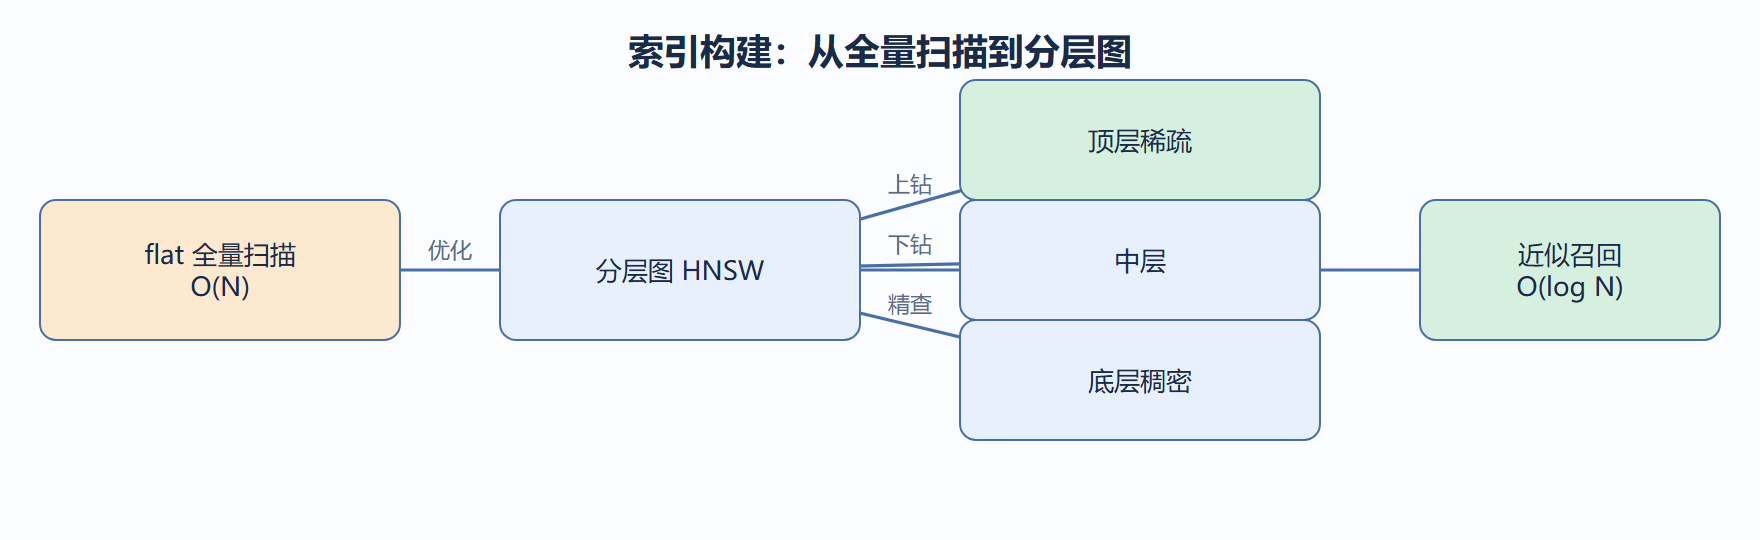
最朴素的是平面(flat)索引:检索时逐个算距离,准确但随规模线性变慢。HNSW(分层可导航小世界)则是用图结构做近似:上层稀疏、下层稠密,查询像走楼梯一样逐层下钻。下面用一段简化的建图逻辑说明它的取舍。
import numpy as np def build_hnsw_layers(vecs, m=8): # 极简示意:按层随机分配,真实实现会用近邻链接 rng = np.random.default_rng(0) layers = [] for i, v in enumerate(vecs): level = int(rng.integers(0, 3)) # 层数越高节点越稀 while len(layers) <= level: layers.append([]) layers[level].append(i) print(f'建成 {len(layers)} 层,每层节点数:', [len(l) for l in layers]) return layers build_hnsw_layers([np.zeros(4) for _ in range(20)], m=8)
这段代码的要点在「分层」:查询从最稀疏的顶层进入,快速逼近目标区域,再下钻到稠密层精细查找。相比 flat 的全量扫描,它把复杂度从 O(N) 降到接近 O(log N),代价是建索引更慢、占更多内存存图。
存储上,边缘端要算清三笔账:原始向量、图结构(邻居表)、以及可选的量化编码。下面给出存储估算函数。
def index_storage(n, dim, quant_bits=8, avg_links=16): vec_bytes = n * dim * (quant_bits // 8) # 量化后向量 graph_bytes = n * avg_links * 4 # 邻居用 int32 索引 return {'vectors_MB': vec_bytes / 1e6, 'graph_MB': graph_bytes / 1e6} print(index_storage(n=1_000_000, dim=64, quant_bits=8))
这张存储账告诉我们:图结构的邻居表不可忽视,百万向量、平均 16 个邻居就要约 64MB。所以「索引很小」是错觉,规划时必须把图也算进去。
案例:图结构撑爆内存
- 背景:某项目按「向量本身 120MB」申请设备,上线即 OOM。
- 操作:用上面的存储函数重算,加上邻居表后实际 190MB。
- 结果:把平均邻居数从 24 降到 12,图缩到约 100MB,总占用回到 160MB。
- 解读:邻居数 m 是 HNSW 内存与召回的主旋钮,调小能省内存但略降召回。
- 变式:若召回优先,可升 m 但改用量化编码压向量,平衡内存与质量。
四种索引怎么选
| 类型 | 原理 | 复杂度 | 内存 | 适用 |
|---|---|---|---|---|
| flat | 全量扫描 | O(N) | 低 | 小规模、要求 100% 召回 |
| IVF | 聚类分桶 | 亚线性 | 低 | 中等规模、速度优先 |
| HNSW | 分层图 | 近 O(logN) | 高 | 大规模、精度与速度平衡 |
| PQ | 向量压缩 | 低 | 最低 | 内存极限场景 |
选择规则:文档数十万以内且内存不紧张,flat 也可以用;十万到百万级用 IVF 或 HNSW;设备内存真扛不住时,PQ 压缩向量是最后手段,但它需要重训码本,成本不低。边缘端最常见的是 HNSW 加量化编码的组合,2.3 末尾的案例就是围绕这个组合展开的。
建索引的参数:m 与 ef_construction
HNSW 建图时两个参数决定图质量:m 是每节点邻居数,ef_construction 是构建期搜索宽度。m 越大图越密、召回越好、内存越大;ef_construction 越大构建越慢但图更接近最优。经验起点是 m=16、ef_construction=200,再按召回率和内存实测调整。
| 参数 | 作用 | 调大影响 | 调小影响 | 起点 |
|---|---|---|---|---|
| m | 每节点邻居数 | 召回↑ 内存↑ | 召回↓ 内存↓ | 16 |
| ef_construction | 建图搜索宽度 | 图更好 构建慢 | 图粗糙 | 200 |
| 量化位宽 | 向量压缩比 | 精度↑ 体积↑ | 精度↓ 体积↓ | 8 |
三个参数联动,别只调一个:m 调大后若内存超限,通常配合降低量化位宽找回平衡。
增量插入的隐藏成本
HNSW 支持增量插入,但插入顺序会影响图质量。真实业务里新文档通常按时间到达,连续插入会让同时间窗口的节点在图里扎堆,长尾空间被挤占。缓解办法是周期性重建:每攒够一定量就整图重排一次。没有这条纪律,索引会悄悄变差,而你不会立刻察觉。
def maybe_rebuild(index, added_since_rebuild, limit=50_000): # 增量插入攒够量即触发重建,防止图质量劣化 if added_since_rebuild >= limit: index.rebuild() return 0 return added_since_rebuild
一张内存预算清单
边缘端规划索引时,按下面清单逐项填数再加总:
- 向量本体:数量 × 维度 × 量化位宽。
- 图结构邻居表:数量 × 平均邻居数 m × 4 字节(int32 索引)。
- 原文或元数据指针:每篇一条指针,通常可忽略。
- 构建期临时区:建索引时的候选队列,按 ef_construction 估算,构建完释放。
其中邻居表最容易被漏。常见的错误是只按向量本体申请内存,上线即 OOM——2.3 末尾的案例就是这个错误的真实版本。把预算清单贴在团队文档里,选设备时逐项勾选,能省掉大量现场排障。
建索引的时序与临时内存
建索引不是瞬时完成的,构建期临时内存常被忽略:HNSW 建图时要维护候选队列与邻居更新,峰值可能达到最终索引的两到三倍。规划顺序是:先算最终体积,再预留构建期临时区,构建完成后立刻释放。设备内存紧张时,宁可分批构建、分段释放,也别让构建期峰值直接压爆上限。
本节可考核点:能说清 flat 与 HNSW 在复杂度与内存上的取舍,并解释为何索引存储要同时算向量和图。