2.2 向量嵌入与模型集成
embedding 是把语义压进向量空间的投影仪
在架构的第二站,我们谈嵌入:它决定了「相似」在计算机眼里到底是什么。LEANN 的轻量取向,要求嵌入模型本身也要小、要快。
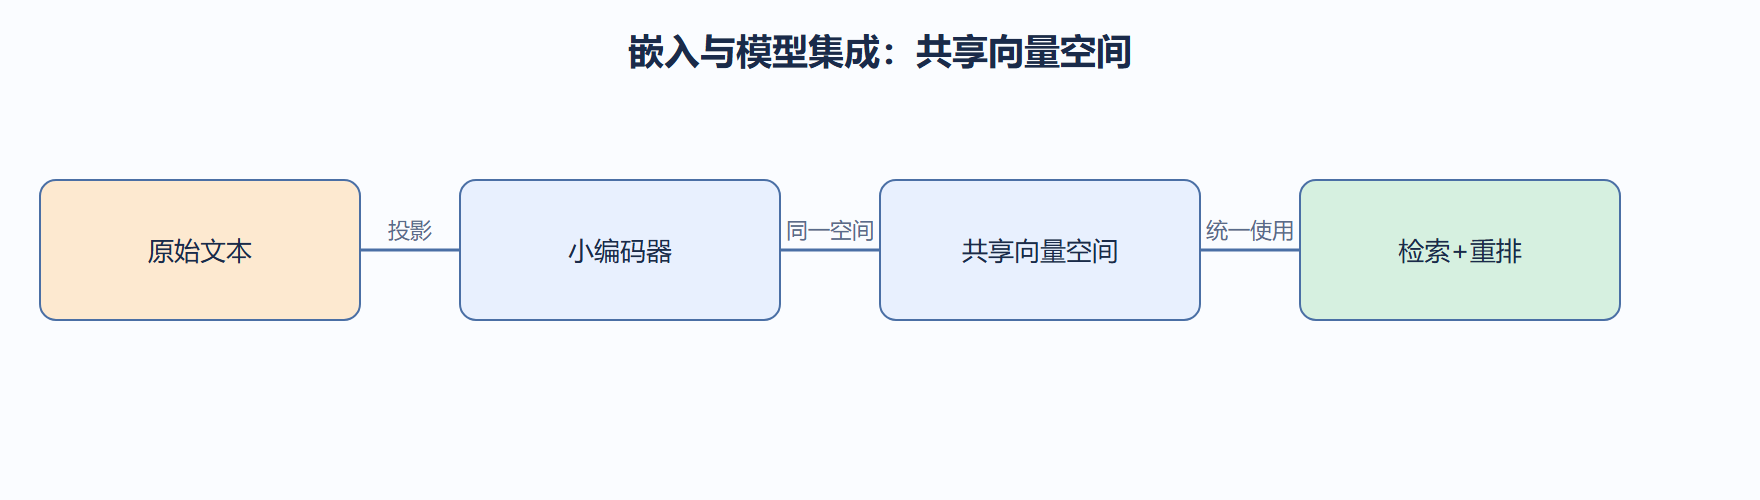
我们主张:嵌入模型和重排头应使用同一套向量空间,否则检索回来的候选在重排头眼里是「另一种语言」。下面用一段最小实现演示如何用一个共享的小编码器同时服务检索与重排。
import numpy as np class TinyEmbedder: # 用一个低秩矩阵模拟小编码器,真实场景可换句子模型 def __init__(self, in_dim=128, out_dim=64, rank=16): rng = np.random.default_rng(3) self.U = rng.standard_normal((in_dim, rank)) * 0.1 self.V = rng.standard_normal((rank, out_dim)) * 0.1 def encode(self, x): h = x @ self.U # 压到隐空间 return np.tanh(h @ self.V) # 两段文本用 one-hot 近似表示,仅演示投影一致性 a = np.eye(128)[5] b = np.eye(128)[5] + np.eye(128)[6] * 0.3 emb = TinyEmbedder(128, 64) print('同义近似向量夹角余弦:', float(np.dot(emb.encode(a), emb.encode(b)) / (np.linalg.norm(emb.encode(a)) * np.linalg.norm(emb.encode(b)))))
要点在 encode:无论查询还是文档,都过同一个 U@V 投影,保证落在同一空间。工程上很多人栽在「检索用 A 模型、重排用 B 模型」,结果是检索召回的候选重排头根本排不准。
嵌入之后还要考虑量化。边缘端内存紧,把 32 位浮点压成 8 位整型能省四倍空间,代价是轻微精度损失。下面给出标量量化片段。
def scalar_quantize(vec, bits=8): lo, hi = vec.min(), vec.max() scale = (hi - lo) / (2**bits - 1) q = np.round((vec - lo) / scale).astype(np.int32) return q, (lo, scale) # 存下标度,推理时反量化 v = np.random.default_rng(0).standard_normal(64).astype(np.float32) q, meta = scalar_quantize(v) print('量化后字节数:', q.nbytes, '原浮点字节数:', v.nbytes)
案例:车载 POI 嵌入量化
- 背景:车端要给五十万 POI 做语义检索,原始浮点索引 150MB,超预算。
- 操作:嵌入统一到 64 维,再用上面标量量化压到 8 位,索引缩到约 40MB。
- 结果:检索准确率仅降 1.5 个点,内存回到预算内。
- 解读:量化是边缘端标配,关键是嵌入与重排头都用同一量化方案,推理时同步反量化。
- 变式:若准确率敏感,可对 top 候选做「粗量化召回 + 浮点精排」两段式。
维度是嵌入的第一笔预算
嵌入维度直接决定索引体积和检索开销。维度翻倍,向量存储翻倍,距离计算量也翻倍;但维度太低又会损失语义区分度。工程上的做法是:先按语料复杂度选初始维度,再做一次扫描验证。
def dim_memory(n_docs, dim, quant_bits=8): return n_docs * dim * quant_bits / 8 / 1e6 # 索引向量体积,单位 MB for d in [32, 64, 128, 256]: print(f'dim={d:>3},50万文档 @8bit 索引向量占 {dim_memory(500_000, d):.1f} MB')
选维度的经验法则:通用文本 64 到 128 维足够;领域术语密集(法律、医疗)可考虑 128 到 256 维;低于 32 维通常区分度不足,召回会先崩。维度一旦选定轻易别改——索引要重建、重排头要重训,切换成本很高。
嵌入模型选型的四个维度
| 维度 | 问法 | 边缘端偏好 |
|---|---|---|
| 体积 | 模型多大,能否与索引共存 | 十万参数以内,可量化 |
| 延迟 | 单条编码耗时 | 设备 CPU 上毫秒级 |
| 对齐 | 与重排头是否同一空间 | 同一模型族,避免混用 |
| 领域 | 通用还是垂直更准 | 垂直场景优先领域适配版 |
这张表回答的其实是一件事:嵌入模型在目标设备上「跑得动、接得上、够得准」。三个「是」才值得做 POC,任何一项不满足都要先解决再谈上线。
量化与归一化的顺序
量化和归一化是两件不同的事:归一化统一向量方向(范数变为 1),量化改变数值存储精度。推荐的顺序是先归一化、再量化。原因:归一化后的值域已知(-1 到 1),量化时的 scale 计算更稳;反过来先量化再归一化,反量化误差会被放大。把顺序写进团队规范,推理时就不会踩精度坑。
反量化:推理时不能忘的一步
量化后的向量在索引里是整型,查询向量通常还是浮点。推理时要么把索引向量反量化回浮点,要么把查询向量也量化到同一刻度,两条路必须二选一并保持一致。最隐蔽的 bug 是「检索用量化索引,重排却拿原始浮点向量」——两者刻度不同,重排分数全乱。规则只有一条:检索与重排看到的向量,必须来自同一量化策略。
def dequantize(q, lo, scale): return lo + q.astype(np.float32) * scale # 与 scalar_quantize 配套的反量化 v = np.random.default_rng(0).standard_normal(64) q8, (lo, scale) = scalar_quantize(v) v_restored = dequantize(q8, lo, scale) print('反量化误差量级:', float(np.abs(v - v_restored).max()))
本节可考核点:能解释「检索与重排共用嵌入空间」的必要性,并说清标量量化换来了什么、代价是什么。