第四章:高级检索与数据管理
第四章:高级检索与数据管理
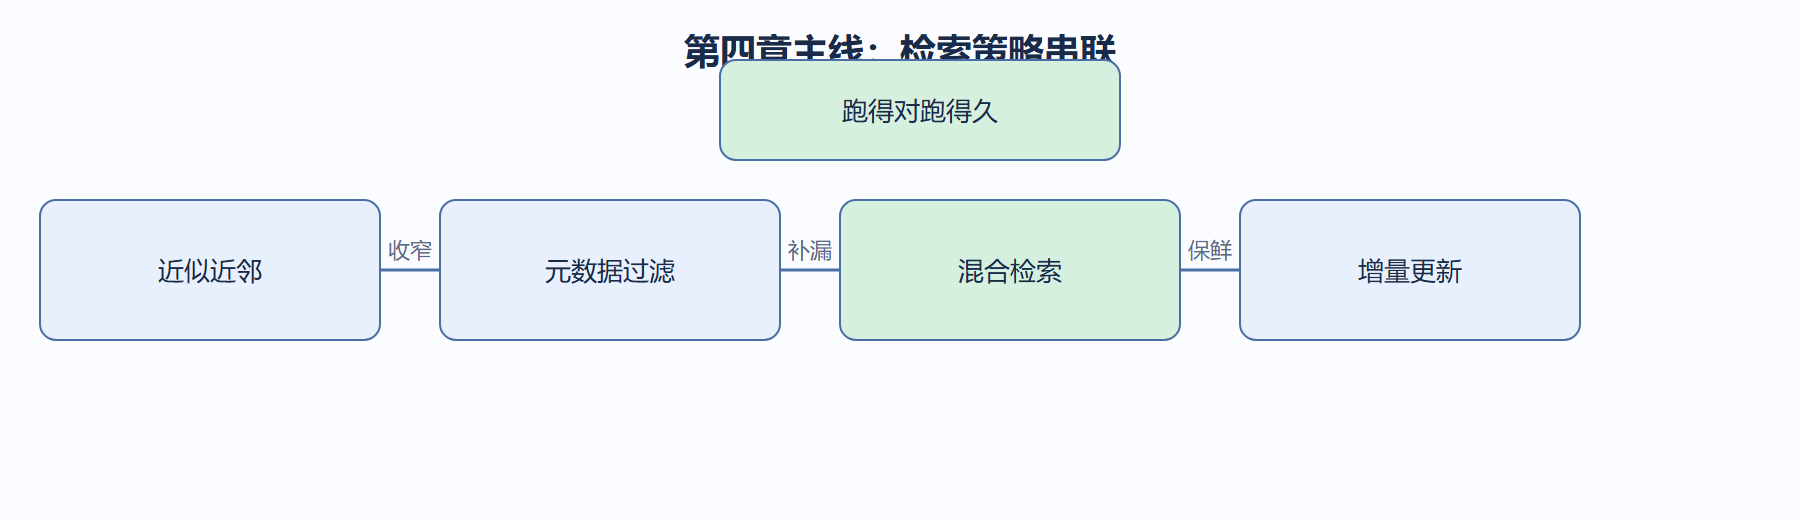
本章跟着一条线走:原始向量先做近似最近邻粗排,再用元数据过滤收窄,接着用稠密加稀疏的混合策略补漏,最后让数据能增量更新而不停服。
如果说前面章节是「能跑」,这一章是「跑得对、跑得久」。LEANN 的检索不是单点算法,而是一串可以组合的策略:ANN 解决规模,过滤解决约束,混合解决召回盲区,增量解决时效。
这一章最容易被轻视的是「过滤」与「混合」。很多人以为相似度最高就是最好,结果把已下架商品、过期文档顶到前面;也有人只用稠密检索,漏掉关键词精确匹配的需求。我们会在 4.2、4.3 把这两个坑填平。
读完本章你能考核四件事:ANN 搜索为何近似、过滤与聚合怎么用、混合检索如何融合分数、数据摄取与索引怎样增量更新。下一章进入性能与合规的硬仗。
四节是怎么安排的
- 4.1 近似最近邻(ANN)搜索:从「为什么要近似」的账算起,讲清 HNSW、IVF 这类结构如何在精度与速度之间拨旋钮。
- 4.2 过滤与聚合搜索:在检索结果上叠加元数据约束,解决「相似但不该出现」的问题。
- 4.3 混合检索策略:让稠密语义与稀疏关键词互补,用 RRF 这类免训练融合把两个分数合起来。
- 4.4 数据摄取与索引更新:让索引跟得上业务节奏,增量摄取、标记删除、周期合并,做到零停服。
学本章前要确认的几件事
- 已完成第二章的索引与相似度概念,知道 HNSW、余弦、内积这些词。
- 已有第三章建好的一份索引,本章的过滤、混合、更新都在这份索引上验证。
- 知道召回率的大致含义:检索出的正确候选占全部正确候选的比例。
本章的主线:从「能跑」到「跑得对、跑得久」
前几章解决能不能检索,本章解决检索得对不对、数据变了索引跟不跟得上。四个能力是组合拳不是单选题:规模大用 ANN,要约束用过滤,有盲区用混合,数据动用增量。读完本章,你应该能根据业务特征,把四招组合成一条检索管线。
常见误区
- 以为相似度最高就该排在前面:已下架商品、过期文档再相似也不能上,这正是 4.2 过滤存在的理由。
- 只用稠密检索不用稀疏:专业术语场景里,稠密常把「善意取得」与「取得」混在一起,4.3 的混合就是补这个盲区。
- 把全量重建当更新手段:数据每天在变,重建意味着停服窗口,4.4 的增量更新把不可用时间压到零。
学完自检清单
- 能否解释 ANN 为何必须近似,并说出 nprobe 或 ef_search 的作用。
- 能否说清过滤应该在检索前还是检索后做,为什么。
- 能否解释 RRF 为何不用分数标准化,它比加权融合好在哪。
- 能否讲清「标记删除」与「物理删除」的区别和各自的代价。
建议的节奏
本章建议带着自己的语料同步练:读完 4.1 把索引的 nprobe 调两档看召回变化;读完 4.2 给检索加一个过滤条件;读完 4.3 接入稀疏路与融合;读完 4.4 手动删一条文档观察标记删除与合并。每一步都动手,本章才真正变成你的能力。
本章结束时你手里应该有的东西
- 一条可调旋钮的检索管线:ANN 加过滤加混合。
- 一份能增量更新、标记删除、周期合并的索引维护流程。
- 一组自己在语料上测出的召回率数字,作为后续优化的基线。
与前后章节的衔接
第四章的混合检索依赖第二章的相似度概念,增量更新会调用第三章的 API;本章产出的检索管线正是第五章性能调优的测量对象。读完本章,你应该已经能独立搭出一条带过滤、带混合、能更新的完整检索链路。
下一章是性能调优、监控、合规与行业案例。
评论区
(0)
U