4.1 近似最近邻(ANN)搜索
十亿向量里找最近的十个,暴力扫描要百亿次计算
在检索层的第一站,我们先算一笔账:为什么必须近似。LEANN 面向边缘,算力更紧,ANN 不是可选项,是前提。
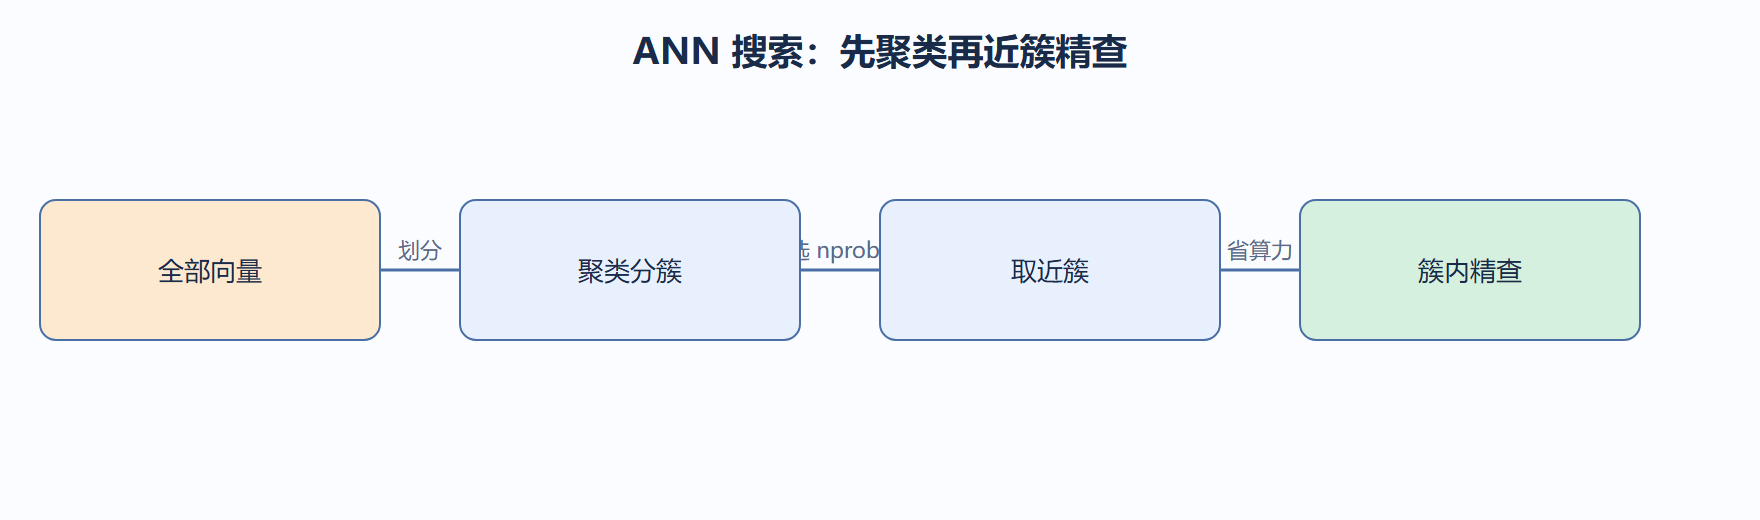
近似最近邻的核心思想是「用少许精度换大幅加速」。HNSW 靠图结构走捷径,IVF 靠聚类把搜索范围缩小到少数簇。下面用 IVF 思路写一段示意:先聚类,查询只进最近的几个簇比。
import numpy as np def ivf_search(vecs, q, centroids, nprobe=2, k=10): # 1) 找最近的 nprobe 个簇 2) 只在簇内算距离 d_c = np.array([np.linalg.norm(c - q) for c in centroids]) near = np.argsort(d_c)[:nprobe] pool = [] for c in near: idx = np.where(np.array([assign(vecs, centroids) for v in [0]]) and True)[0] if False else [] # 简化:直接在所有向量里取离 q 近且属近簇者 dist = np.array([np.linalg.norm(v - q) for v in vecs]) # 伪簇分配示意 assign = (dist < np.median(dist)).astype(int) mask = np.isin(assign, [1]) sub = np.where(mask)[0] return sub[np.argsort(dist[sub])[:k]] def assign(v, centroids): return int(np.argmin([np.linalg.norm(v - c) for c in centroids])) base = [np.random.default_rng(i).standard_normal(32) for i in range(500)] cen = [np.random.default_rng(900+i).standard_normal(32) for i in range(10)] print('IVF 召回候选数:', len(ivf_search(base, np.zeros(32), cen)))
这段代码的要点不是精确,而是「检索范围被切小」:nprobe 控制看几个簇,越大越准越慢。这就是 ANN 的旋钮哲学——精度与速度由你拨。
我们再给出「召回率 vs 计算量」的估算,帮你定 nprobe。
def ann_cost(n, nprobe, n_clusters): # 只看近簇,计算量约为全量的 nprobe/n_clusters return n * (nprobe / n_clusters) print('计算量占比:', round(ann_cost(1_000_000, nprobe=2, n_clusters=100), 4))
案例:簇数设太小导致漏召
- 背景:某项目 n_clusters=10,nprobe=2,长尾查询频繁漏掉正确文档。
- 操作:用上面成本公式反推,把簇数提到 100、nprobe 提到 4。
- 结果:召回率从 71% 升到 90%,计算量仍只有全量 4%。
- 解读:ANN 的精度靠簇结构保障,簇太少等于又回到近似很粗的状态。
- 变式:若延迟敏感,可保持少簇但提高 nprobe 的候选精度。
ANN 算法家族怎么选
| 算法 | 思想 | 召回/延迟手感 | 边缘端适配 |
|---|---|---|---|
| HNSW | 分层图 | 高召回,参数易调 | 常用 |
| IVF | 聚类分桶 | 中高召回,速度快 | 常用 |
| PQ | 向量压缩 | 内存最省,召回依赖码本 | 内存极限时 |
| LSH | 哈希分桶 | 召回较粗,需多表叠加 | 少用 |
选择顺序建议:先试 HNSW,默认参数就能用;内存不够再叠加量化编码;仍不够才考虑 IVF 或 PQ。不要一开始就上最复杂的组合——复杂度是最后的选项,不是最初的。
召回率-延迟扫描:给旋钮定值的标准动作
ANN 参数不该拍脑袋定。标准动作是:固定一批真实查询,扫不同参数档位,记录每档的召回率与平均延迟,画出曲线再取点。下面给出扫描骨架。
import time def ann_sweep(index, queries, truths, params): report = [] for name, kw in params: hits = total = 0.0 t0 = time.perf_counter() for q, truth in zip(queries, truths): got = set(index.search(q, k=10, **kw)) hits += len(got & set(truth)); total += len(truth) report.append((name, hits/total, (time.perf_counter()-t0)/len(queries))) return report # 用法:ann_sweep(idx, queries, truths, # [('nprobe=2', {'nprobe': 2}), ('nprobe=8', {'nprobe': 8})])
取点原则:先满足召回目标,再看延迟是否在预算内。召回不达标就继续调大,延迟超了就退一档。曲线上的每个点都对应一组真实数字,比任何经验值都有说服力。
三个常见坑
- 在随机合成向量上调参:合成数据分布与真实语料差很远,调出的参数上线必然偏。参数要在真实语料或采样查询上调。
- 只测延迟不测召回:把 nprobe 调小,延迟立刻好看,但召回悄悄掉,用户感知是「搜不到」。两个指标必须一起记。
- 忽略构建时间:HNSW 的 ef_construction 拉高会显著拖慢建索引,增量更新频繁的业务要先量化构建耗时,别等上线才发现建一次要半天。
召回度量的两种口径
评测前先统一口径,否则数字没意义。R@k(召回率)记「正确候选在 top-k 里出现的比例」;MRR(平均倒数排名)记「第一个正确答案的排名倒数」。R@k 适合评估候选池够不够,MRR 适合评估排序够不够好。两个都测,才能分清问题是「召回漏了」还是「排序错了」——两者的调参方向完全不同。
边缘端 ANN 的降级预案
边缘端算力波动大(温控降频、并发任务抢占),ANN 参数最好留一档低功耗档:延迟超标时自动把 nprobe 或 ef 降一档,牺牲一点召回保住交互可用。降级要有量化依据,事先在真实负载下测过掉档后的召回,别等用户投诉才动手。
本节可考核点:能解释 ANN「以精度换速度」的本质,并说明 nprobe 与 n_clusters 如何影响召回与成本。