4.3 混合检索策略
混合检索是 dense 与 sparse 两手并用的检索
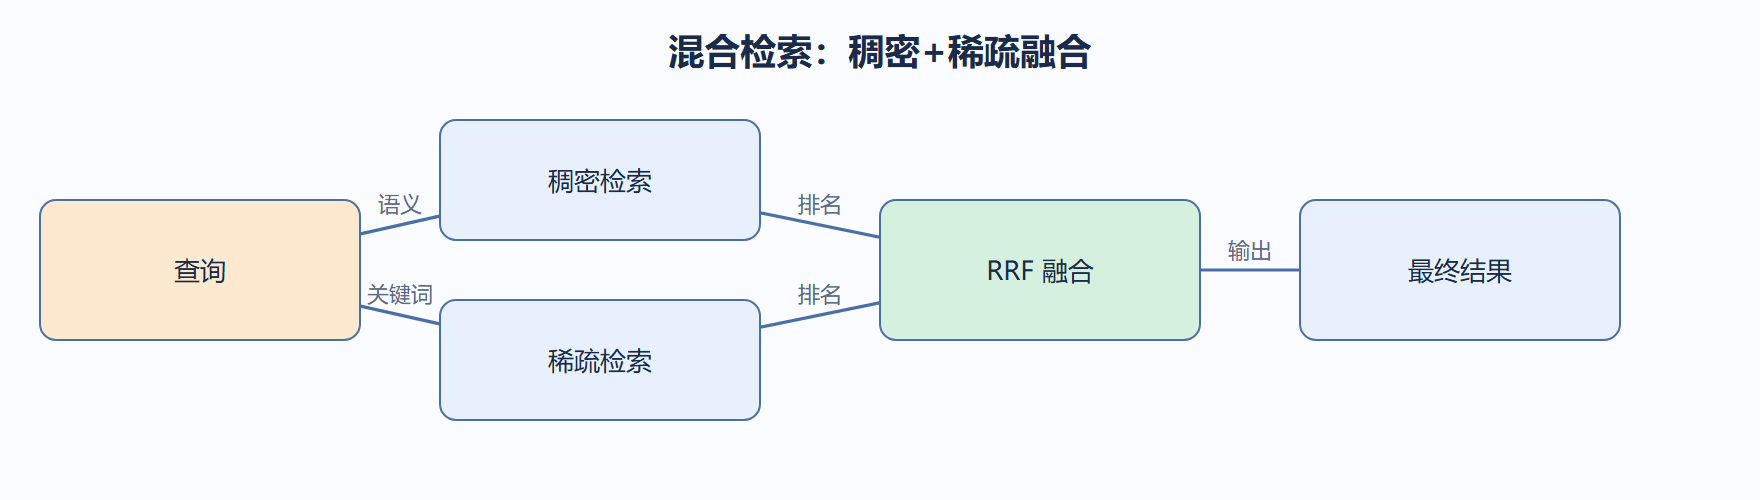
在检索层的第三站,我们补上稠密检索的盲区。语义向量擅长「理解意思」,却常漏掉精确关键词;稀疏检索(如 BM25)正好反过来。混合检索把两手分数融起来。
下面给出最经典的「倒数排名融合」(RRF),它不要求两个分数同量纲,只看各自的排名位次。
def rrf(dense_rank, sparse_rank, k=60): # 两路各给排名(从1开始),按 1/(k+rank) 求和 fused = {} for doc, r in list(dense_rank.items()) + list(sparse_rank.items()): fused[doc] = fused.get(doc, 0.0) + 1.0 / (k + r) return dict(sorted(fused.items(), key=lambda x: -x[1])) dense = {'A': 1, 'B': 2, 'C': 3} sparse = {'C': 1, 'A': 2, 'D': 3} print('融合排名:', rrf(dense, sparse))
RRF 的好处是无须把余弦和 BM25 分数标准化,工程上极省心。我们倾向在边缘端用 RRF,因为它没有额外训练成本。
下面把混合检索的整体流程画成 mermaid,这是本章主线在策略层的展开。
融合之后还可以接重排头做精排,但要注意顺序:混合负责「广撒网不漏」,重排负责「把好答案顶上来」。
def hybrid_then_rerank(fused, reranker, top_m=20): # 先混合取较宽候选,再交给轻量网络精排 wide = sorted(fused, key=lambda d: -fused[d])[:top_m] return reranker(wide) print('混合+重排候选数:', hybrid_then_rerank(rrf(dense, sparse), lambda x: x, top_m=2))
案例:专业术语召回失败
- 背景:法律检索里「善意取得」这类术语,稠密向量把它和「取得」混淆,漏掉精确条款。
- 操作:接入稀疏检索补关键词,再用 RRF 融合两路。
- 结果:精确条款召回率从 66% 升到 89%,且无需重训嵌入。
- 解读:稠密与稀疏互补,混合检索用最低成本补上语义向量的盲区。
- 变式:若算力允许,可把混合结果再送重排头,进一步提精排质量。
稠密与稀疏:两种互补的检索
| 维度 | 稠密检索 | 稀疏检索 |
|---|---|---|
| 原理 | 语义向量相似 | 词项精确匹配 |
| 强项 | 理解意思、同义改写 | 术语、编号、专名 |
| 弱项 | 精确词漂移 | 无共用词就召回不了 |
| 开销 | 需要嵌入模型 | 需要倒排索引 |
两者不是谁替代谁,而是各自漏掉对方能接住的场景。判断要不要上混合,就看业务里「精确词命中」是否重要——法律条款、设备型号、零件编号这类场景几乎必上混合。
三种融合方式怎么选
- 倒数排名融合(RRF):只看位次,无需标准化,零训练成本,工程最省心,适合边缘端。
- 加权分数融合:把两路分数各乘权重再相加,需要先统一量纲,权重靠调或靠学。
- 学习型融合:用模型学「两路分数怎么配」,效果上限最高,但要训练数据和算力。
下面的代码给出加权融合的归一化写法,权重 w 从 0 到 1 扫描即可。
def weighted_fusion(dense, sparse, w=0.6): # 两路分数先 min-max 归一化再加权,w 偏向稠密路 d_max = max(dense.values(), default=1) s_max = max(sparse.values(), default=1) merged = {} for doc in set(dense) | set(sparse): d = dense.get(doc, 0) / d_max s = sparse.get(doc, 0) / s_max merged[doc] = w * d + (1 - w) * s return dict(sorted(merged.items(), key=lambda x: -x[1]))
何时不要上混合
混合不是免费的:多一路检索就多一份索引、一份延迟、一份维护。两类情况不值得混合——只靠语义就能满足且从未收到「搜不到精确词」的反馈;或语料里没有「必须精确命中的字段」。先翻一个月的检索日志看有没有精确词漏召回,再决定要不要上,比拍脑袋稳。
RRF 的 k 值手感
RRF 里的 k 是平滑常数,默认 60。k 越小,排名靠前的候选权重差越大,高排名更突出;k 越大,融合结果越趋于平均。工程经验:k 在 30 到 100 之间对结果影响有限,默认 60 即可。真正影响大的是两路各自的 top 截断长度——每路至少取 20 到 50 条,融合才有足够的交叉空间。
混合结果的评估口径
混合后的排序同样用 R@k 与 MRR 测,但对比对象是两个基线:单稠密、单稀疏。只有混合在两项上都优于或持平最优单路,才值得保留。常见情况是混合的 R@k 显著提升、MRR 略降——稀疏把不相关的精确词凑了上来——这时配一个重排头把精排救回来,链路才完整。
延迟预算怎么分
混合检索的延迟是两路之和,边缘端要提前分账:稠密路(嵌入加索引)与稀疏路(倒排检索)各占多少毫秒。总预算只有 80ms 时,两路都必须压在预算内;否则改用「稀疏先跑、稠密只对 top 子集重排」的串联式混合,牺牲一点全局性换回延迟。
稀疏路在边缘端的构建
稀疏路不需要额外模型:对语料分词后建倒排,BM25 分数查询时现算。边缘端要留意分词器的词表大小——词表越大倒排越占内存。对设备手册这类封闭语料,自定义一个几十万词的领域词表,比通用分词更省内存也更准。
混合检索的失败模式
混合不是万能药,两种失败模式要提前预防:一是两路都召回不了(语义不懂、精确词也不在),混合只是把两个空列表合起来;二是融合后相关文档被不相关但高分的精确词挤掉,常见于术语膨胀——一个型号词命中了大量相似文档。应对前者靠语料质量与切片策略,应对后者靠混合后接重排头,把精排交给网络。
本节可考核点:能解释为何需要混合检索,并说清 RRF 融合相比「分数加权」的工程优势。