4.4 数据摄取与索引更新
电商每小时上新十万条,索引不能停服重建
在检索层的最后一站,我们解决「数据会动」的问题。静态索引只是教科书场景,真实业务的知识一直在长、在改、在删。
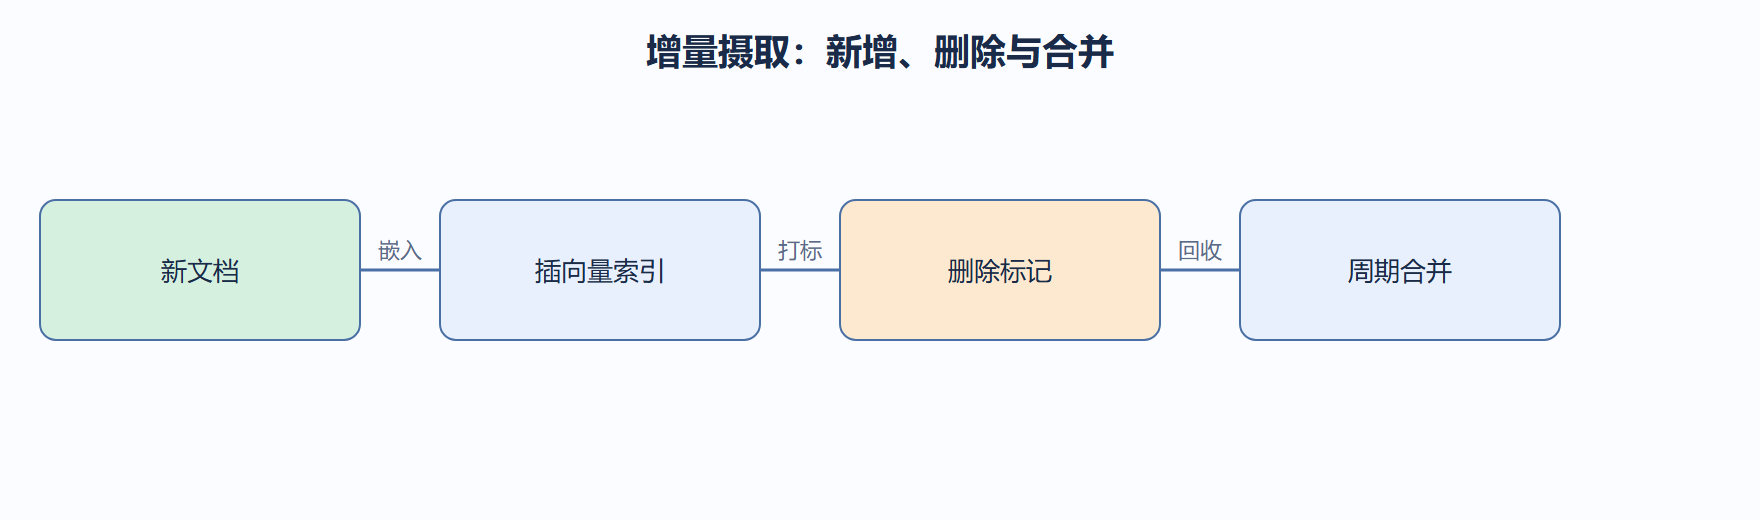
LEANN 的取向是增量更新优先于全量重建。下面给出一段增量摄取:新文档算嵌入、插进索引,旧文档打删除标记,查询时跳过。
class IncrementalIndex: def __init__(self): self.vecs = []; self.docs = []; self.deleted = set() def add(self, text, vec): self.vecs.append(vec); self.docs.append(text) return len(self.vecs) - 1 def delete(self, idx): self.deleted.add(idx) def search(self, q, k=5): # 跳过已删除项 scored = [(i, float(np.dot(q, v))) for i, v in enumerate(self.vecs) if i not in self.deleted] scored.sort(key=lambda x: -x[1]) return [self.docs[i] for i, _ in scored[:k]] idx = IncrementalIndex() import numpy as np a = idx.add('退货政策', np.random.default_rng(1).standard_normal(16)) idx.delete(a) b = idx.add('换货流程', np.random.default_rng(2).standard_normal(16)) print('检索结果:', idx.search(np.random.default_rng(2).standard_normal(16)))
关键设计是「删除用标记而非真的搬移数据」,因为重排图结构删除节点代价高。标记删除让读取时过滤,批量压缩再真正回收,避免频繁停服。
删除标记积累会拖慢查询,所以需要周期性合并。下面给出合并触发判断。
def need_compact(index, threshold=0.3): if not index.vecs: return False ratio = len(index.deleted) / len(index.vecs) return ratio > threshold print('是否该合并:', need_compact(idx))
案例:停服重建拖垮大促
- 背景:某电商每天全量重建索引,大促期间重建耗时两小时,期间搜索不可用。
- 操作:改为增量摄取 + 低峰期合并,重建只在首次全量做一次。
- 结果:搜索 7x24 可用,上新延迟从小时级降到分钟级。
- 解读:增量更新把「不可用时长」从业务指标变成架构默认值——零停服。
- 变式:若删除占比高,合并频次提高;若以新增为主,可拉长合并周期。
增量更新与全量重建怎么选
| 维度 | 增量更新 | 全量重建 |
|---|---|---|
| 不可用时长 | 近似零 | 分钟到小时 |
| 内存开销 | 平稳 | 峰值翻倍 |
| 实现成本 | 较高 | 低 |
| 适合阶段 | 数据持续增长 | 首次上线、结构变更 |
实践上两者不是二选一:首次建索引必须全量,日常维护用增量,图质量劣化到一定程度再做一次全量兜底。关键是「增量为主、全量兜底」的角色定位要写进运维手册,否则团队会退回到遇事就重建的老路。
批量摄取与幂等性
增量摄取要支持重试,就必须幂等:同一批数据重复推送,索引不重复、不丢。做法是给每篇文档一个稳定 id,add 前先查重。下面给出带幂等的批量入口。
def ingest_batch(idx, batch, seen): new = [d for d in batch if d['id'] not in seen] for d in new: idx.add(d['text'], d['vec']); seen.add(d['id']) return len(new) # 返回实际新增数,用于日志与监控 # 网络抖动导致重复推送时,seen 保证同一篇不会入两次索引
合并的资源预算
标记删除积累到阈值触发合并,但合并本身吃内存和 CPU。边缘端要选低峰期合并,并给合并设置时间预算:比如 30 分钟内合不完就先停,下次继续。合并是分批完成的,不是一锤子买卖。还要监控合并后的索引体积——如果合完仍然膨胀,说明删除比例在失控,得回头查删除源。
失败恢复与一致性
增量流程中途失败(断电、崩溃)不能留下「半批」数据。常规防御是写前日志:先把这批变更写成日志,全部成功后打点,崩溃后从打点处重放。边缘端没有分布式事务,靠「日志加幂等重放」就能做到最终一致,成本远低于引入强一致机制。
物理删除何时值得做
标记删除省事,但删除占比超过三成后,查询要过滤大量死数据,效率明显下降,此时物理删除(重建索引)更划算。判断依据就是 4.4 的 need_compact 逻辑,阈值定在 0.3 到 0.4。真正删除后记得把 id 也从已见集合里清掉,否则同样的文档再也加不回来。
更新语义:改文档怎么办
「改」可以拆成「删旧加新」两步,但两步之间查询可能同时看到新旧版本。业务可接受就直接做;不能接受就引入版本字段,查询时过滤旧版本。边缘端检索增强场景通常可接受短暂时延,优先用删旧加新,别为强一致引入复杂机制。
索引更新的观测指标
- 待合并删除占比:超过阈值就该安排合并。
- 索引体积增速:新增与删除是否失衡。
- 增量延迟:从推送到达到检索可见的耗时。
- 合并耗时:是否落在低峰窗口内。
四个指标挂进监控后,索引维护就从「定期折腾」变成「按数据决策」——该合并、该全量、该查删除源,都由数字说话。
更新频率与架构的匹配
增量更新方案也要和业务频率匹配:每分钟几十条变更,直接走增量并延迟合并;每小时上万条,需要批量摄取与固定窗口合并;一天一次的大批次,反而可以直接全量重建。选型的判断标准只有一个:用户可接受的「检索到最新数据的时延」是多少。时延要求苛刻,增量更新越要靠前;时延宽裕,全量重建反而更省心、更不容易出错。
本节可考核点:能解释「标记删除而非物理删除」的取舍,并说明何时触发合并、为何要合并。