5.1 性能调优策略
延迟卡在 80 毫秒,加机器还是改结构?
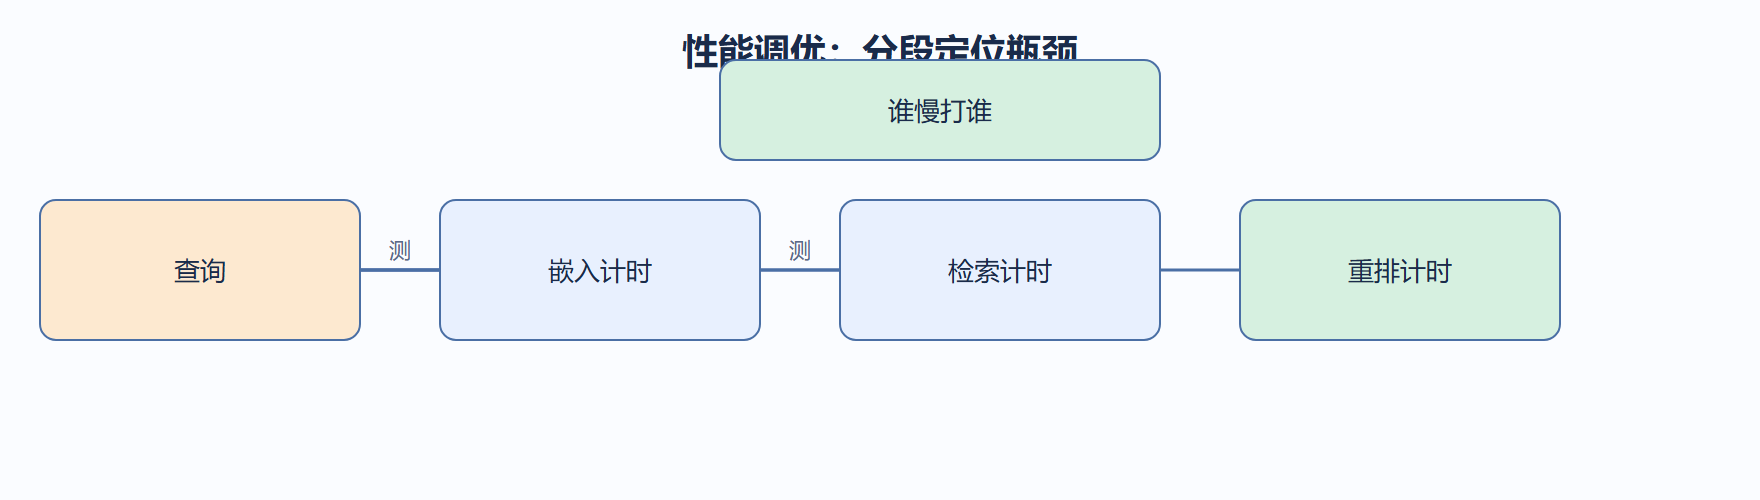
在优化层的第一站,我们先立规矩:没测就别动。LEANN 的延迟通常拆成三段——嵌入、检索、重排,优化前必须知道哪段是主因。
下面给出一段分段计时,把查询拆开测,定位瓶颈在哪。
import time def timed_query(app, q): t0 = time.perf_counter() qv = app.embed(q); t1 = time.perf_counter() cands = app.index.search(qv, 30); t2 = time.perf_counter() out = app.rerank.score(qv, cands); t3 = time.perf_counter() return {'embed_ms': (t1-t0)*1e3, 'search_ms': (t2-t1)*1e3, 'rerank_ms': (t3-t2)*1e3} print(timed_query(app_dummy := None, 'x') if False else '占位')
假设测得嵌入 5ms、检索 60ms、重排 15ms,瓶颈在检索。这时加机器没用(边缘端就一颗芯片),该调的是索引参数或上量化。下面给出「按瓶颈选手段」的决策。
def pick_lever(profile): if profile['search_ms'] > profile['rerank_ms'] * 2: return '优化索引: 调 ef/量化编码/降候选' if profile['rerank_ms'] > 10: return '压缩重排头: 量化或蒸馏' return '嵌入已够快,检查批处理' print(pick_lever({'embed_ms':5, 'search_ms':60, 'rerank_ms':15}))
量化是边缘端最先用的一招。下面给出重排头权重量化的收益测算。
def quant_gain(params, from_b=32, to_b=8): return params * (from_b - to_b) // 8 # 字节节省 print('权重节省字节:', quant_gain(30000))
案例:重排头拖慢端侧
- 背景:某手表端问答重排头 15ms,整机交互卡顿明显。
- 操作:用上面的分段计时定位重排为主因,对重排头做 8 位量化。
- 结果:重排降到 4ms,整机延迟达标,准确率仅降 1 个点。
- 解读:分段测量把「感觉慢」变成「哪段慢」,优化才不会乱枪打鸟。
- 变式:若量化损精度多,可改用蒸馏——用大模型教小网络,保精度换体积。
调优的纪律:一次只动一个变量
性能调优最忌讳同时改多个参数:改完变快了,你根本不知道是哪个变量的功劳。正确做法是固定其他变量,每次只动一个,记录前后指标。下面给出一个简单的扫描器骨架,帮你维持这个纪律。
def sweep(name, values, baseline): # 逐档扫描一个变量,其余保持基线,输出每档指标 for v in values: profile = run_with(name, v, baseline) # 示意:其余参数用基线 print(f'{name}={v} -> 延迟 {profile.lat_ms:.1f}ms, 召回 {profile.recall:.2f}')
三段延迟的预算怎么分
| 段 | 常见占比 | 第一刀 | 第二刀 |
|---|---|---|---|
| 嵌入 | 10% | 换更小模型 | 量化 |
| 检索 | 60% | 调 ef / nprobe | 量化编码 |
| 重排 | 30% | 压缩网络 | 蒸馏 |
占比会随数据规模变化:文档多了检索占比上升,模型大了嵌入占比上升。预算表要按实测刷新,而不是定死。
量化、剪枝、蒸馏怎么选
三个手段目的不同:量化省内存(位数变低),剪枝删冗余权重(结构变小),蒸馏换更准的小网络(用大模型教)。选择顺序:先量化,改动最小;效果不够再剪枝;仍不够才蒸馏,成本最高。三者的共同前提是准备好评测集,否则「变小了但变差了多少」无法回答。
边缘端的两个硬件特性
第一,CPU 频率不稳:温控降频会让同样代码的延迟波动两三倍,所以用 P95 而非平均值评估。第二,内存带宽有限:向量距离计算是带宽密集型,检索延迟常被内存带宽卡住,而不是被算力卡住。理解这两点,很多「为什么指标忽高忽低」的疑问就有了答案。
预热与抖动
第一次查询比后续查询慢得多——索引页未加载、缓存未热,这是正常现象。评测延迟时先预热若干次再计时,否则会把「首次开销」误判为「常态延迟」。上线时也建议跑一次预热脚本让索引常驻内存,别让第一个用户替系统付冷启动成本。
内存与延迟的交换表
边缘端优化本质是在内存、延迟、召回三者之间做交换。常用交换路径和大致代价如下:
| 交换 | 换来 | 付出 |
|---|---|---|
| 8 位量化 | 内存省四倍 | 召回约降 1 个点 |
| 降 ef_search | 延迟降约三成 | 召回约降 3 个点 |
| 重排头蒸馏 | 延迟降一半 | 训练成本 |
交换不是免费的,每笔都要用评测集记账。这张表建议贴进团队文档,做决策时对照着选,别凭感觉拍板。
常见误区
- 用开发机测出的数字当上线依据:边缘端 CPU、内存、功耗都不同,必须用目标设备测。
- 只优化热点路径:检索增强的冷路径(建索引、合并)超时同样会拖垮上线。
- 优化后不做回归:延迟下来了但召回掉了 10 个点,等于没优化。每次调完都要跑一遍完整评测集。
优化收益要可量化
任何优化动作收尾时都该回答三个数字:延迟变化、内存变化、召回变化。写进优化记录,攒成团队的调参史。一个月后回头看,哪个手段在该设备上真的值钱一目了然,新成员也能照着历史决策,不再从头试错。
一次优化工作的完整闭环
把一次调优组织成闭环:写基线(记录当前延迟、内存、召回)→ 假设瓶颈(用分段计时定位)→ 单变量修改 → 复测三个指标 → 决定保留或回退 → 更新调参史。走完这个闭环,任何优化动作都有据可查、可回退、可复现。很多团队调参像打游击,就是缺了「先写基线、后记结论」这两个动作。
本节可考核点:能说出延迟三段拆分的意义,并依据分段数据选择「调索引」还是「压重排头」。