第五章:性能优化与最佳实践
第五章:性能优化与最佳实践
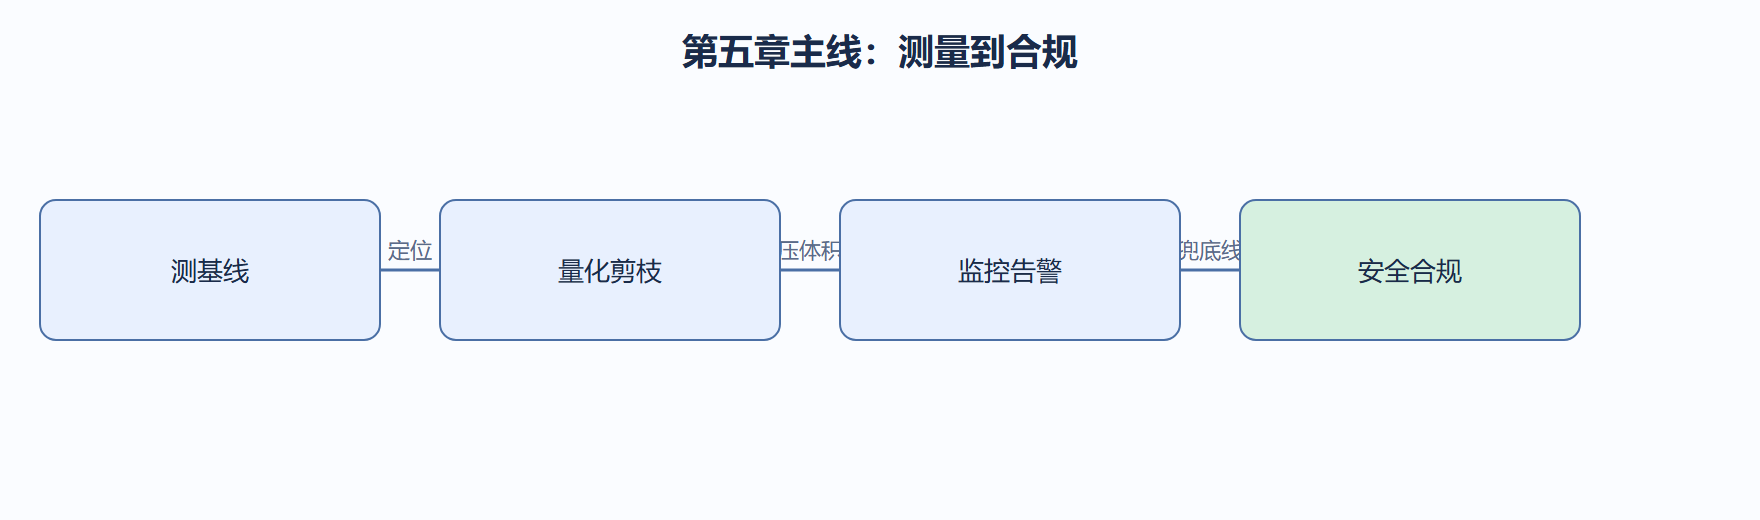
本章跟着一条线走:先测基线找到瓶颈,再用量化剪枝把体积压下来,接着把故障暴露在监控里,最后用安全与合规兜住底线。
前面章节让你「能用」,这一章让你「敢用在生产」。LEANN 上边缘,性能与合规是两条硬杠:延迟超了用户就弃用,数据漏了就触红线。
这一章的抓手是「先测量后优化」。我们反对凭感觉调参——不测基线,你不知道瓶颈在检索、重排还是网络。5.1 给调优方法论,5.2 给可观测性,5.3 给安全合规,5.4 给真实行业案例。
读完本章你能考核四件事:性能该怎么调、故障如何排查监控、安全合规注意什么、行业案例长什么样。最后一章我们回到社区与未来。
四节是怎么安排的
- 5.1 性能调优策略:先测基线再定位瓶颈,用量化、剪枝、蒸馏把体积和延迟压下来,全程按数据决策。
- 5.2 故障排查与监控:把「感觉慢」「感觉怪」变成可观测的指标,P95 延迟、内存、召回率,配上排查顺序。
- 5.3 安全性与合规性考量:数据不出厂、访问控制、日志脱敏,合规不是附加项而是架构选型的第一约束。
- 5.4 案例分析与行业应用:一个真实行业案例把全册方法串起来,从背景、操作到指标,看收益如何落地。
学本章前要确认的几件事
- 已完成第二、三、四章,手里有一份能跑的检索管线和一批真实查询。
- 有基础的 shell 与 Python 能力,能跑计时脚本、能读日志。
- 明确自己业务的两个数字:延迟预算和内存上限。没有预算谈优化就是空转。
本章的主线:先测量,后动手
这一章的抓手是一句话:先测量后优化。不测基线,你不知道瓶颈在检索、重排还是嵌入;不监控,故障发生时你只能靠猜。5.1 给方法论,5.2 给可观测性,5.3 给底线,5.4 给样板。四节合起来,把「担心」变成「可控」。
常见误区
- 拿到延迟问题先加机器:边缘端没有「加机器」这个选项,唯一出路是改结构。
- 只优化检索不管重排:三段延迟里任何一段都可能成为瓶颈,只盯一段会事倍功半。
- 把合规当上线前补丁:数据不能出厂是硬约束,架构选型第一天就该考虑。
性能指标的三个档位
| 指标 | 健康 | 预警 | 危险 |
|---|---|---|---|
| 端到端延迟 P95 | 预算内 | 超预算 20% | 超预算 50% |
| 内存峰值 | 上限 70% 内 | 70% 到 90% | 超上限 |
| 首条命中率 | 稳定 | 周环比降 2 点 | 周环比降 5 点 |
学完自检清单
- 能否用分段计时定位一段 80ms 延迟的主因。
- 能否说清 P95 延迟、内存峰值、召回率三个指标各自反映什么。
- 能否列出「数据不出厂」对应的三条落地动作。
- 能否复述行业案例里准确率从 58% 到 86% 是哪些手段带来的。
建议的节奏与产出
本章适合带着真实问题读:线上正被延迟卡住先看 5.1;正在排障先看 5.2;要过安全审查看 5.3;领导要样板直接看 5.4。读完你手里应该有:一份分段计时的基线报告、一张监控看板、一份合规自查清单。
与前后章节的衔接
第五章是全书动手成果的总检验:第二章的旋钮、第四章的检索管线在这里被测量和优化;5.3 的合规约束会影响第四章的索引方案和第三、六章的生态选型。本章结束后,你应该有底气把 LEANN 方案推上生产。
本章产出物清单
- 一份分段计时基线报告:嵌入、检索、重排各占多少毫秒。
- 一张监控看板:P95 延迟、内存峰值、召回率,至少三个图。
- 一份合规自查清单:数据流向、访问控制、日志脱敏逐项打勾。
- 一个可复述的行业案例:约束、选择、结果三段都能讲清。
学完本章意味着什么
学完本章,你手里的原型就从「实验室作品」变成「生产候选」:延迟有预算、问题能排查、数据合规、案例有样板。这也是全书的分水岭——前四章的能力是「做出」,第五章的能力是「扛住」,第六章则把这份能力交回社区。到这一步,LEANN 对你就不再是一本书,而是一套可以带走的工程方法。
下一章是社区贡献、生态集成与发展路线图。
评论区
(0)
U