6.2 生态系统集成与扩展
生态是把单点能力连成网络的集成关系
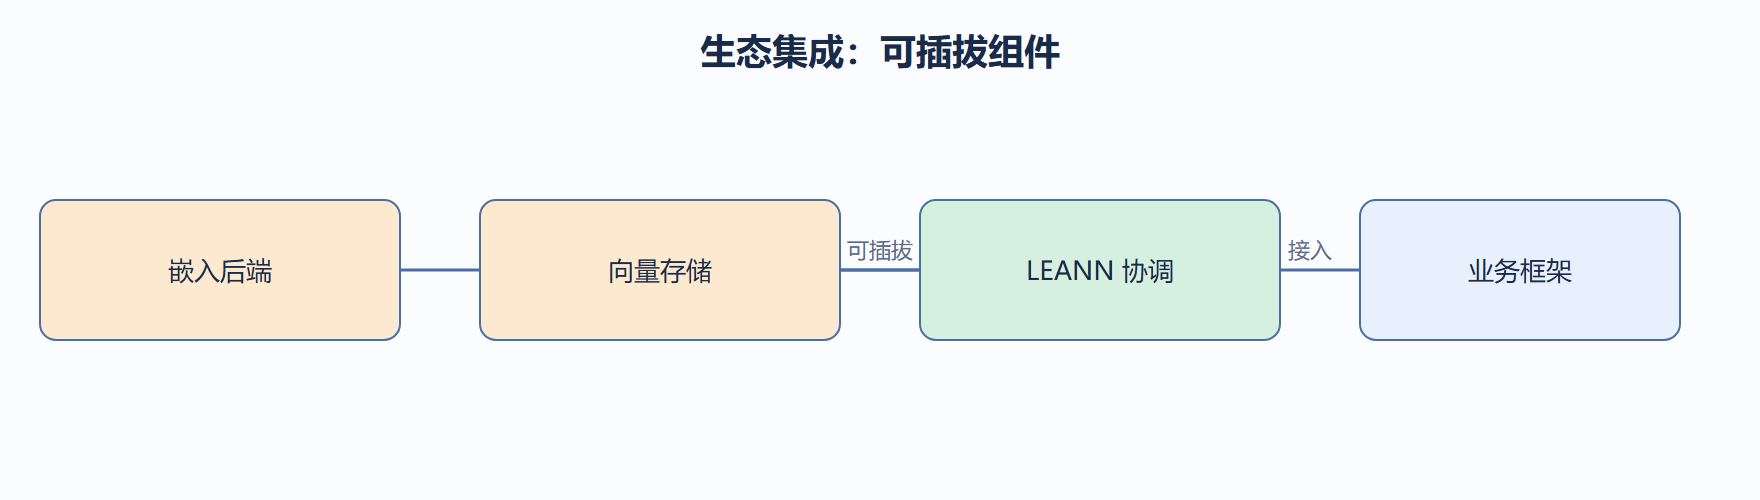
在体系收尾的第二站,我们谈「别重复造轮子」。LEANN 的价值很大程度来自它能接住上下游:嵌入模型、向量存储、业务框架。
我们主张用接口而非绑定来集成。下面给出一段插件式集成骨架:不同嵌入后端实现同一接口,运行时按配置切换。
class EmbedderPlugin: def encode(self, text): raise NotImplementedError class LocalTiny(EmbedderPlugin): def encode(self, text): return _local_vec(text) # 端侧小模型 class RemoteBig(EmbedderPlugin): def encode(self, text): return _remote_call(text) # 服务端强模型 REGISTRY = {'local': LocalTiny, 'remote': RemoteBig} def get_embedder(name): return REGISTRY[name]() print('当前嵌入后端:', get_embedder('local').__class__.__name__)
接口化让 LEANN 不绑死某家模型,也方便你在云端用强模型、边缘用轻模型,同一套检索逻辑不变。这正是「生态」的实操含义:能力可插拔。
再给出一段把 LEANN 接进业务流水线的示例,强调它只是链路一环。
def pipeline(query, embedder, store, reranker): vec = embedder.encode(query) cands = store.search(vec, 30) return reranker.rank(query, cands) # 各组件均可替换,LEANN 作为协调者而非垄断者 print('流水线装配: 嵌入/存储/重排 均可插拔')
案例:换嵌入模型零改动
- 背景:团队想从本地小模型切到厂商强模型做对比,怕改一堆代码。
- 操作:因集成走插件接口,只改配置
embedder: remote即切换。 - 结果:半小时内完成 A/B,确认强模型在长文档上更准,但端侧不可用。
- 解读:接口化集成把「换组件」从重构变成配置,是生态健壮的根。
- 变式:可同时挂多后端做加权融合,按场景动态选模型。
生态位:LEANN 处在哪个位置
| 层 | 典型对象 | LEANN 的角色 |
|---|---|---|
| 嵌入 | 端侧小模型 / 云端强模型 | 消费者:按接口接入 |
| 存储 | 向量库 / 文件系统 | 消费者:索引可替换 |
| 框架 | 业务编排 / 推理框架 | 提供方:作为一环被编排 |
| 硬件 | 手机 / 开发板 / 边缘盒子 | 适配目标:分档支持 |
看清这四层,就明白「集成」不是单向的:LEANN 既消费下游(嵌入、存储),也服务上游(框架、业务)。接口设计要让两个方向都可插拔。
插件协议怎么设计
接口化集成不是「定义一个类就完事」,三个细节决定它能不能真正用起来:
- 用抽象基类锁签名:把 encode、search 这类方法的参数与返回类型定死,实现类必须满足。
- 版本化接口:接口升级走新名字,旧实现仍可用,避免一次升级打断所有插件。
- 注册表与配置解耦:插件按名字注册,业务侧只写配置,不 import 具体类。
下面用抽象基类重写嵌入插件,签名约束比注释可靠得多。
from abc import ABC, abstractmethod class Embedder(ABC): @abstractmethod def encode(self, text: str, dim: int) -> list[float]: """输入文本,输出定长向量;实现类必须满足该签名""" class LocalTiny(Embedder): def encode(self, text, dim=64): return _local_vec(text, dim) # 端侧小模型实现
兼容性矩阵:每个插件记三笔账
给每个集成对象建一行记录:接口版本、测试覆盖、负责人。矩阵不复杂,但缺了它,换组件时就只能靠「改改看」。
| 组件 | 接口版本 | 测试 | 维护者 |
|---|---|---|---|
| 本地小嵌入 | v2 | 通过 | 端侧组 |
| 云端强嵌入 | v2 | 通过 | 算法组 |
| 文件向量存储 | v1 | 通过 | 平台组 |
换组件的验收流程
案例里「半小时完成 A/B」不是运气,是流程撑的。换组件遵循四步:先在测试环境切换配置跑通冒烟,再用评测集对比新旧组件的指标,接着灰度一小批真实用户,最后全量并保留回退开关。回退开关尤其重要——新组件出问题能一键切回,而不是现场回滚代码。
双后端并行:灰度期怎么处理
切换期间新旧组件可能要并行跑,这需要「结果对比」而不只是「切换」。做法:查询同时发给新旧两个后端,线上只展示旧结果,离线对比两份 top 列表的一致性。跑一周,如果一致率低于阈值,说明新组件有问题,不要上线。这套影子模式比直接切换安全得多。
生态健康的两个信号
判断一个生态健不健康,不看宣传看两个信号:一是插件数量是否只增不减,老插件有没有持续维护;二是迁移到新接口的成本是不是在降低。两个信号都正向,说明项目在「接得住」上下真功夫;如果插件文档常年过期、接口频繁破坏,再热门也别急着站队。
从生态到你的团队
生态思维也能用到团队内部:把内部组件也按「接口加注册表加版本」管理,部门之间就不再靠人肉对接。很多项目对外生态漂亮、对内一地鸡毛,差别就在有没有把接口化当作内部默认纪律。这条建议同样适用于第三、四章讲到的索引与存储模块。
贡献点:从适配器开始
如果你想让 LEANN 接入一个新后端,最稳的切入点是写一个适配器:实现现有接口,跑通示例,再提 PR。适配器不涉及核心算法,评审门槛低,又是社区最缺的东西。反过来,别一上来就动核心检索逻辑,那部分需要维护者深度参与。
集成契约的最小集
任何集成都先确认最小契约:输入对象(文本还是结构化数据)、输出对象(向量还是候选)、错误语义(异常还是空结果)、版本标识。四样对齐后,集成代码九成能一次跑通。这四个字段也应写进接口的文档字符串,让实现者不用翻源码就能对照。
本节可考核点:能解释「接口而非绑定」为何利于生态,并说明 LEANN 在业务链路里的协调者角色。