6.3 发展路线图与前瞻
轻量神经架构三年后会长什么样?
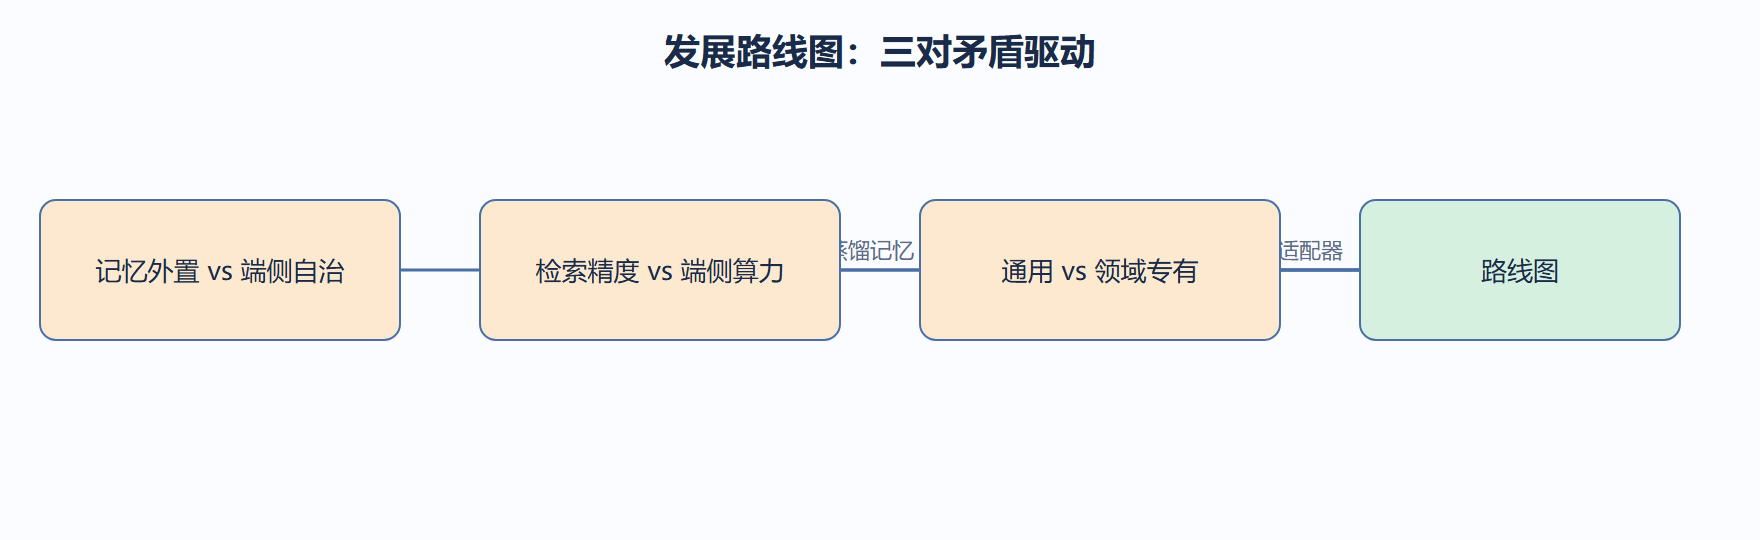
在体系收尾的最后一站,我们不做预言,只沿着已出现的工程张力推演方向。LEANN 这类架构的演进,由三个矛盾驱动。
矛盾一是「记忆外置」与「端侧自治」。现在知识在索引里、网络在端侧,一旦彻底断网,索引也读不了。方向是把一小部分高频知识蒸馏进网络权重,做「常驻记忆」。下面给出蒸馏目标的函数骨架。
def distill_loss(student_logit, teacher_logit, temperature=2.0): # 让小网络模仿强网络的输出分布 import numpy as np ps = _softmax(student_logit / temperature) pt = _softmax(teacher_logit / temperature) return -np.sum(pt * np.log(ps + 1e-9)) def _softmax(x): import numpy as np e = np.exp(x - x.max()); return e / e.sum() print('蒸馏损失占位已定义')
矛盾二是「检索精度」与「端侧算力」。混合检索现在靠 RRF 免训练,但更准的做法要小网络融合,算力又上来了。方向是「按设备档位选策略」:低端走 RRF,高端走神经融合。
矛盾三是「通用嵌入」与「领域专有」。通用模型在垂直领域常翻车。方向是领域适配的最小化:只微调一小段适配器,而非全模型。
下面用一段「能力开关」表达路线图的取舍,它让不同设备各取所需。
ROADMAP = { 'v4': ['端侧常驻蒸馏记忆', '按档位选检索策略'], 'v5': ['领域适配器热插拔', '跨设备联邦索引'], } def next_focus(device_tier): return ROADMAP['v4'] if device_tier == 'low' else ROADMAP['v5'] print('低端设备重点:', next_focus('low'))
案例:地铁隧道里的自治检索
- 背景:巡检机器人进隧道失联,云端知识用不了,纯端侧小模型又记不住手册。
- 操作:按路线图的「常驻蒸馏记忆」,把高频故障条款蒸馏进重排头权重。
- 结果:断联期间仍能答 80% 高频问题,恢复连接后再用全量索引补长尾。
- 解读:架构演进不是追新,而是把「约束矛盾」逐个变成能力。
- 变式:若隧道极长,可分段预载不同区段的蒸馏记忆,控制端侧体积。
三个矛盾对照表
| 矛盾 | 约束双方 | 当前折中 | 演进方向 |
|---|---|---|---|
| 记忆外置 vs 端侧自治 | 知识在索引 vs 断网可用 | 全量索引 + 弱网重排 | 高频知识蒸馏进权重 |
| 检索精度 vs 端侧算力 | 更准的融合 vs 更省的算力 | RRF 免训练融合 | 按设备档位选策略 |
| 通用 vs 领域专有 | 通用模型 vs 垂直精度 | 通用嵌入 + 领域重排 | 领域适配器最小微调 |
三张表并排看,演进方向其实是同一个主题:把「约束」逐步变成「能力」,而不是回避约束。这也是判断后续版本功能取舍的主线。
蒸馏怎么落地:训练流程骨架
「常驻记忆」的蒸馏不是一句口号,落地流程是四步:用全量索引在设备上跑一批高频问题,得到教师输出;用教师输出的软标签训练学生网络;在设备上验证学生的命中率与体积;把学生权重随固件一起发布。下面给出训练循环的最小骨架。
def distill_step(student, teacher, batch, temperature=2.0): s_logits = student(batch) t_logits = teacher(batch) # 教师输出离线预计算,只读缓存 return distill_loss(s_logits, t_logits, temperature) # 训练循环:epoch 内反复调用 distill_step,结束后保存学生权重
注意一个工程细节:教师输出是离线预计算的,训练时只读缓存,不需要把大模型搬上设备。这一步省下的算力和带宽,是蒸馏能被边缘端接受的前提。
三个技术趋势会怎么影响 LEANN
- 量化继续下探:从 8 位到 4 位甚至混合位宽,检索与重排的体积都会再缩,但精度保障需要更强的校准方法。
- 稀疏化与结构化剪枝:把重排头压到更小,配合蒸馏,端侧可用模型的空间会变大。
- 联邦式索引:多个设备各自持有本地索引,只交换聚合统计,不交换原始数据,兼顾隐私与全局召回。
三个趋势都不改变「小网络加外部记忆」的分工,只改变每一侧能做到的边界。判断它们何时兑现,看社区的实际提交而非宣传。
怎么判断一个方向值不值得跟
路线图每半年刷新,判断方向的标准有三条:是否缓解了真实约束,而不是制造新概念;是否能在现有设备上跑起来,而不是等硬件升级;是否有可衡量的指标,体积、延迟、召回都要有数。三条都满足的方向值得投入,否则先观望。用这三条过滤社区里的新提案,你会少走很多弯路。
前瞻里的不确定性
任何前瞻都有不确定性,LEANN 方向的主要风险有三个:一是端侧大模型的进步可能让「外部索引」显得多余;二是云边同步带宽可能成为瓶颈;三是碎片化的硬件适配成本可能拖慢社区。对实践者而言,应对办法是保持接口可替换——你现在为 LEANN 写的代码,将来换成别的主线,损失也应可控。
从路线图到版本规划
把方向拆成版本规划才有执行力:近期版本解决「蒸馏记忆与低端档位策略」,中期解决「领域适配器与联邦索引」,远期看硬件与社区共同演进。每个版本都要带验收指标——比如蒸馏记忆至少覆盖八成的设备高频问题。没有指标的路线图只是愿望清单,对工程没有约束力。
给实践者的建议
读完路线图,最该做的是把你手里的原型和某个方向对齐:比如给重排头加一个蒸馏记忆模块,或者把混合策略按设备档位参数化。不用等框架发布新版本——架构主线不变的前提下,这些方向在现有代码上都能先搭出雏形。你的实践,反过来就是社区路线图最需要的反馈。
六章走完,下一步的三种走法
- 深耕工程:把检索管线压到极致,指标全部贴进监控,冲一个可量化的生产案例。
- 深耕算法:选一个矛盾深入研究,比如蒸馏记忆或领域适配器,做成开源贡献。
- 深耕场景:把案例的方法复制到你所在的行业,用真实数据验证收益。
三条路都建立在六章的能力之上,也都指向同一个事实:轻量神经架构的实践,才刚开始。
本节可考核点:能说出驱动轻量神经架构演进的三个矛盾,并解释「常驻蒸馏记忆」想解决什么约束。