6.3 疾病基因学
6.3 疾病基因学
本节摘要:疾病基因学把"基因"和"病"接起来,回答三个层层递进的问题:病是不是基因引起的、是哪个基因、知道了能怎么办。单基因病给出的是近乎确定的因果,复杂疾病给出的却是概率——前者能定位到具体突变,后者只能估出风险高低。本节从单基因病的确定性讲到复杂疾病的全基因组关联,再讲遗传咨询如何把风险翻译给人听,最后落到基因治疗与精准用药,看知识如何一步步变成诊疗手段。
学习目标
阅读完本节,你应当能够:
- 区分单基因病与复杂疾病在遗传模式、外显率和研究手段上的不同。
- 说清"定位致病基因"从家系连锁到全基因组关联的基本思路。
- 理解遗传咨询要处理的不只是数据,还有风险、概率和人的决定。
- 列举基因替代、基因编辑、基因沉默三种治疗策略并各举一例。
- 解释为什么"关联"不等于"因果",以及精准医疗当前的主要障碍。
一、从家系图说起:单基因病的确定性
疾病基因学的起点,往往是一张画满方框和圆圈的家系图。医生把它摊开,看一种病怎么在几代人里传:只传给儿子还是男女都传,隔代还是代代出现,这些规律能反推出背后的遗传模式。单基因病就是在这种图上表现最"讲道理"的一类——囊性纤维化、亨廷顿病、杜氏肌营养不良、镰状细胞贫血,各自遵循常染色体显性、隐性或 X 连锁的孟德尔规律。
除了单基因病和后面要讲的复杂疾病,遗传病谱系里还有两类常被单列:染色体病,比如唐氏综合征多了一条 21 号染色体,问题不在某个基因,而在整段染色体的剂量;线粒体病,跟着母系的线粒体基因组走,遗传方式完全不按孟德尔那套,只由母亲传给孩子。把它们分开说,是因为研究方法和遗传咨询的规矩都不一样。
它们的确定性高得吓人。以亨廷顿病为例,只要 HTT 基因里那段 CAG 重复扩增到一定长度,携带者几乎必然发病,只是早晚问题。这种"高外显率"意味着,单基因病里找到一个致病突变,往往就能给出相当肯定的判断。定位这类基因的传统办法是连锁分析:利用家系里遗传标记和疾病是否"一起传",把致病位点一步步压缩到某条染色体的某段区间,再在区间里逐个排查候选基因,这套流程叫位置克隆。它慢,但扎实,几十年来已经把一大批单基因病的元凶抓了出来。不过单基因病的"确定"也不是铁板一块:同一个突变,在不同人身上发病早晚、严重程度可能差很多,这叫表现度变异;还有些携带者一辈子不发病,叫外显不全。这些差异背后,往往站着所谓的修饰基因——它们不直接致病,却会悄悄改变主效突变的表现。所以哪怕是最"讲道理"的单基因病,也藏着一层没写进教科书的不确定。
二、多基因病的概率:复杂疾病与全基因组关联
可人类最常见的那些病——2 型糖尿病、冠心病、精神分裂症、阿尔茨海默病——偏偏不讲单基因那种道理。它们不是哪一个基因坏了,而是成百上千个微效位点一起起作用,再叠加饮食、压力、环境这些外部变量。每一个位点贡献的风险都小得可怜,合起来却能决定一个人得病的概率高低。这类病叫复杂疾病,它们的遗传力不低(精神分裂症约八成),却没法归到任何一个"罪魁祸首"头上。
全基因组关联研究(GWAS)就是为它们而生的。它的思路是"大海捞针式的对比":找来成千上万个病人和健康对照,扫描他们基因组里数以百万计的单核苷酸多态性位点,看哪些位点在病人里更常见。二十年下来,GWAS 已经找出数万个和复杂疾病相关的风险位点。但这里藏着一个大坑——这些位点大多是"关联",不是"因果"。它们多数落在非编码区,离哪个基因远、怎么影响表达,都不清楚。要把一个风险位点翻译成真正的致病机制,还得靠上一节讲的功能研究方法,用染色质互作、表达数量性状位点分析、CRISPR 扰动去一步步验证。所以我说 GWAS 是起点,不是终点。要把 GWAS 的位点合成一个实用的数字,就有了多基因风险评分——把一个人携带的成百上千个风险等位基因按权重加总,估出他的总体风险。这个分数在乳腺癌、冠心病上已经有了一定预测力,但精度受人群结构影响很大,换个族群可能就失灵。GWAS 之外还有一套叫孟德尔随机化的思路,把遗传变异当成天然随机分配的工具变量,去判断某个生物标志物和疾病之间到底是因果还是仅仅相关,算是给观察性研究补上一道因果的保险。
三、把风险讲给人听:遗传咨询
定位了基因、算出了风险,还得有人把这些信息翻译成人话,这就是遗传咨询的活。它处理的不只是数据,更是概率面前的人:一个人查出来携带 BRCA1 突变,乳腺癌风险显著升高,但"升高"不等于"一定得",要不要做预防性手术、什么时候做、做完怎么面对,这些决定没有一个能从基因型里直接算出来。
遗传咨询有它自己的纪律。一条核心原则是"非指令性"——咨询师提供信息、算清概率、讲明选项,但不替来访者做决定。它的流程大致是:先收集病史、画家系图、评估遗传风险,再讨论要不要做检测、做哪种检测,结果出来后逐条解读,最后陪着来访者消化这个结果可能带来的心理冲击和家庭影响。产前诊断、携带者筛查、癌症易感基因检测,都属于它的日常业务。这里最容易被忽视的是"翻译"这一步:同一个"风险高 30%",落在不同年龄、不同家庭、不同价值观的人身上,意义完全不同。遗传咨询的价值,就是把冰冷的概率还原成一个具体的人能承受、能行动的判断。它的场景比想象中广:产前诊断要面对"这个胎儿要不要保留"这样的重决定;新生儿筛查要在症状还没出现时就发现可治的代谢病;肿瘤易感基因检测则把"你会不会得癌"提前摆到一个健康人面前。还有一个棘手问题是意外发现——本来查的是 A 病,结果顺手发现了 B 病的风险,这个信息要不要告诉来访者、怎么说,都有一整套伦理规范。所以遗传咨询师往往要同时懂点遗传学、心理学和伦理学,缺一样都做不好这份翻译。
四、从诊断到治疗:基因治疗与精准用药
诊断有了,能不能治?基因治疗想做的,是直接去修那个坏掉的基因。主流策略分三路。基因替代是最老实的一路:用腺相关病毒等载体把一份正常拷贝送进靶组织,让它在体内长期表达,补上缺陷。治脊髓性肌萎缩症的 Zolgensma、治 Leber 先天性黑蒙的 Luxturna,都是这个路子。基因编辑则更激进,直接在基因组原位动刀——2023 年获批的 Casgevy,就是编辑患者造血干细胞里的 BCL11A 增强子,重新激活胎儿血红蛋白,去补偿镰状细胞病和地中海贫血里坏掉的成人珠蛋白。基因沉默是第三路,用反义寡核苷酸或小干扰 RNA 去降解那些有毒的信使 RNA,对付亨廷顿病、某些肌萎缩侧索硬化这类"毒性产物"型疾病。
这三路各有软肋:替代疗法受载体容量和免疫反应限制,编辑疗法有脱靶和递送效率的顾虑,沉默疗法需要反复给药、效果不永久。再往下挖一层,这三路其实卡在同一个地方——递送。基因治疗真正难的不是"改什么",而是"怎么把工具安全、足量地送到对的细胞里";递送问题没解决,再好的编辑策略也到不了战场。所以基因治疗目前还主要落在少数单基因病上,离"包治百病"差得远。更现实、也更普及的是精准用药——测出肿瘤里的驱动突变去匹配靶向药,或者看药物代谢基因的型别来调整剂量,比如 CYP2C19 慢代谢的人吃氯吡格雷效果差、得换药。这已经成了肿瘤科和心血管科的日常。精准用药的边界也在往两边扩:往上游,液体活检通过检测血液里的循环肿瘤 DNA,可以在不动刀的情况下动态追踪肿瘤的突变谱,及时发现耐药;往下游,药物基因组学把"基因型决定剂量"变成常规,比如 HLA-B 某个型别的携带者吃卡马西平极易发生致命的皮肤反应,用药前必须先筛查。不过精准医疗也背着几笔现实账——测序便宜了,解读和存储却还是贵;基因组数据库里欧洲裔占比过高,非欧洲人群的变异解读容易出错,反而可能加剧医疗不平等。这些都是钱和公平的问题,不是单纯的科学问题。
| 策略 | 思路 | 代表例子 |
|---|---|---|
| 基因替代 | 送入正常拷贝补偿缺陷 | Zolgensma 治脊髓性肌萎缩症 |
| 基因编辑 | 在基因组原位修正 | Casgevy 治镰状细胞病 |
| 基因沉默 | 降解毒性信使 RNA | Tofersen 治 SOD1 型肌萎缩侧索硬化 |
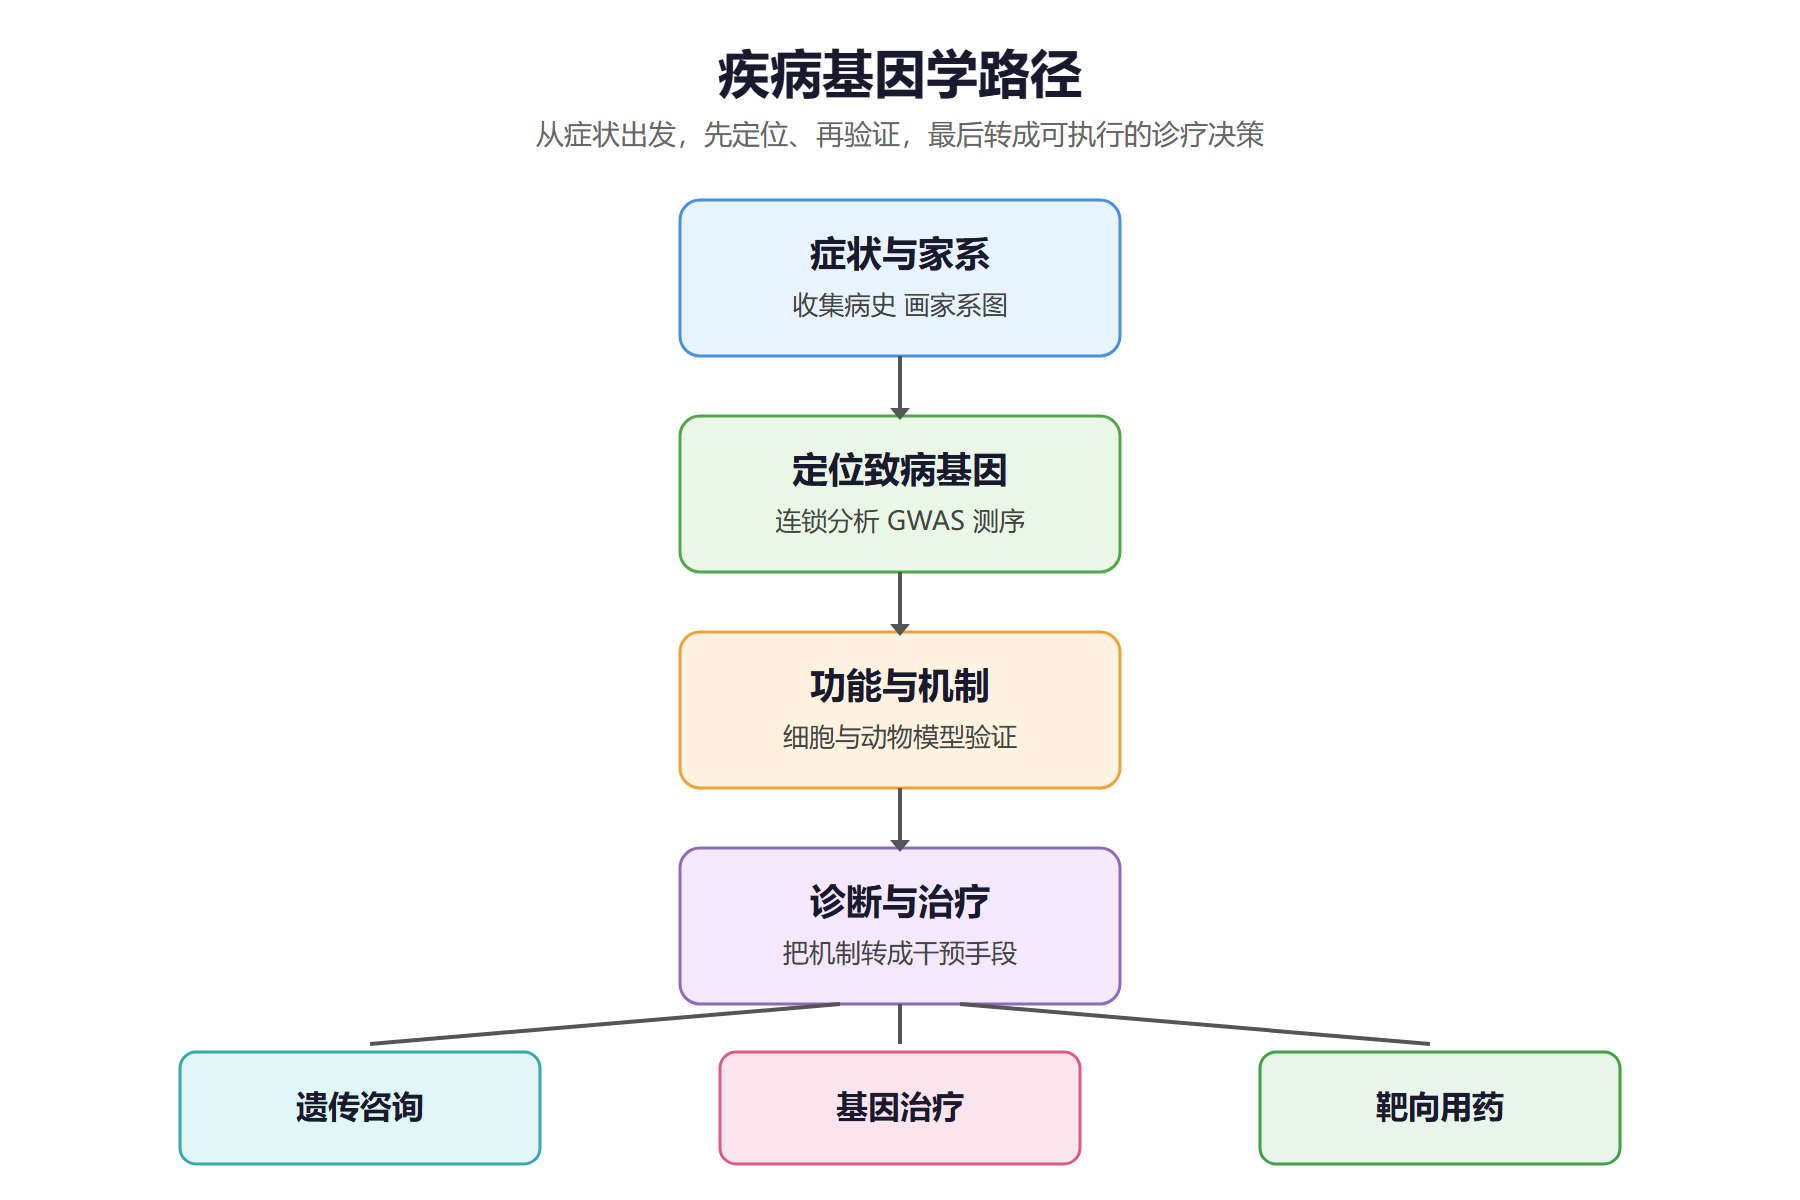
疾病基因学路径
⚠️ 常见坑:全基因组关联找到的是"关联位点",不是"病因基因"。多数风险位点落在非编码区,要经过表达数量性状、染色质互作、功能验证多步,才能说清它到底动了哪个基因。
💡 关键直觉:单基因与复杂疾病的边界正在变模糊。与其纠结二分法,不如把它看成一条"外显率从高到低"的连续谱,很多所谓单基因病也有修饰基因在暗中调表型。
要点串联
- 单基因病:遵循孟德尔规律、外显率高,家系连锁加位置克隆是传统定位手段。
- 复杂疾病:多基因微效叠加再加环境,全基因组关联找的是风险位点,不是病因。
- 遗传咨询:核心是"非指令性",把概率翻译成具体的人能行动的判断。
- 基因治疗三路:替代、编辑、沉默,各有软肋,目前主要落在少数单基因病。
- 精准用药:看驱动突变匹配靶向药,看代谢基因调整剂量,已进入临床日常。
- 关联不等于因果:这是复杂疾病研究里最需要守住的一条底线。
到这里,基因学从分子、遗传、基因组、调控、进化一路走到了应用。第 6 章收尾,也把整套文集带回一个朴素的起点:理解基因,最终是为了理解和改善生命。