7.3 常见参数检验实战
7.3 常见参数检验实战
本节摘要:把五要素框架落到四类高频检验——单样本 t、独立双样本 t( pooled 与 Welch 两版)、配对 t、比例 z 检验。每类检验的关键在"标准误怎么算":方差是否相等、样本是否独立、数据是否配对,三个结构问题决定选哪个模板。全程 statsmodels/scipy 落地,配蒙特卡洛验证检验水平。
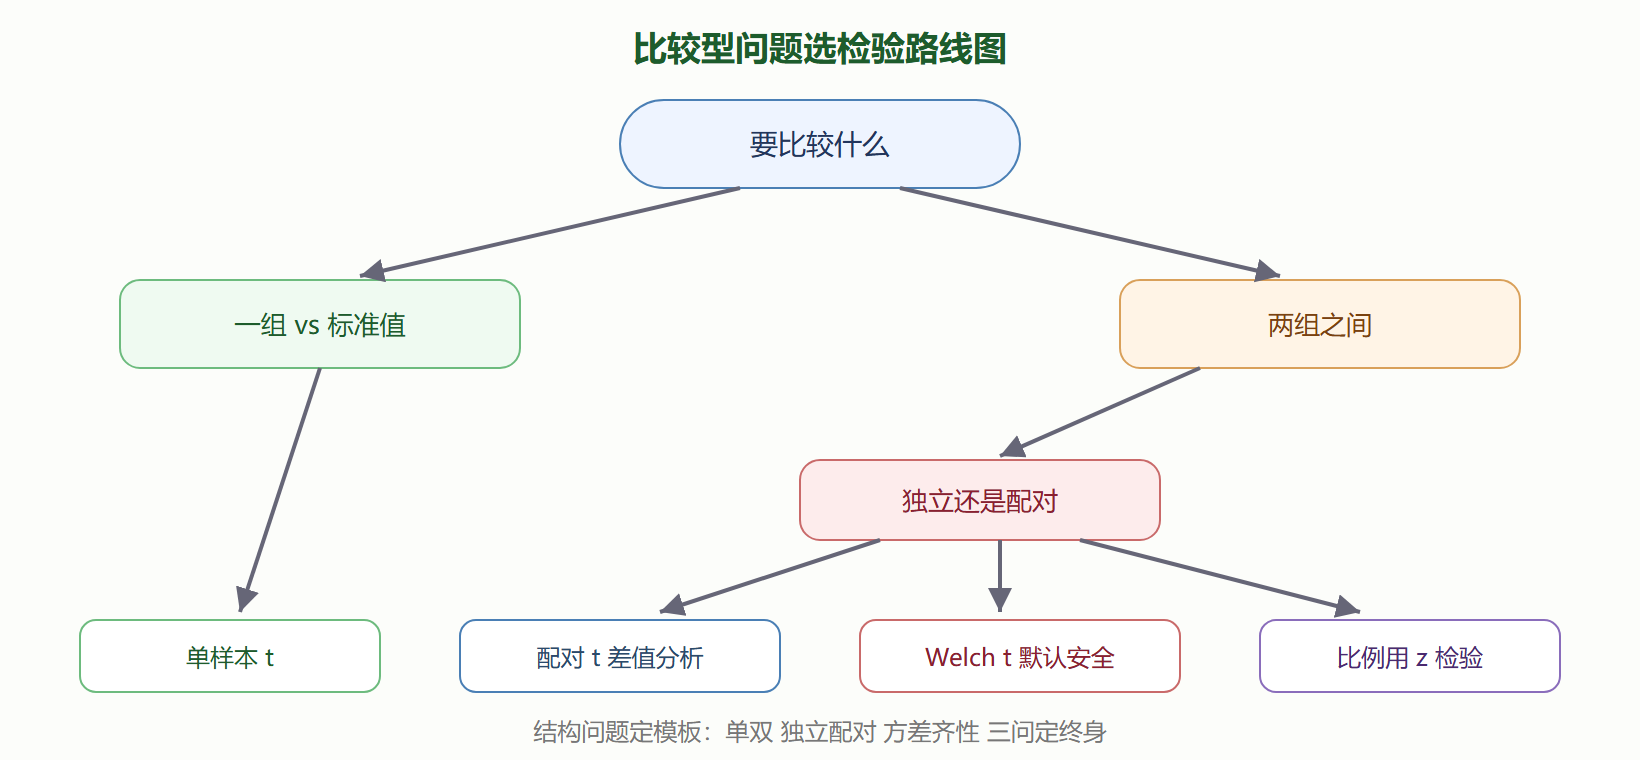
选模板先问三个结构问题
拿到"比较两组数据"的任务,别急着跑函数,先问:①一组还是两组?②两组独立还是配对(同一对象前后测)?③若独立,两组方差可否视为相等?三个答案锁定模板:
| 检验 | 场景 | 统计量标准误 | SciPy 调用 |
|---|---|---|---|
| 单样本 t | 一组 vs 已知标准值 | S/√n | ttest_1samp |
| pooled 双样本 t | 独立、方差齐 | S_p√(1/n₁+1/n₂) | ttest_ind equal_var=True |
| Welch t | 独立、方差不齐 | √(S₁²/n₁+S₂²/n²) | ttest_ind equal_var=False |
| 配对 t | 同对象前后 | S_d/√n(对差值做单样本 t) | ttest_rel |
| 比例 z | 两组比例比较 | √(p̂(1−p̂)(1/n₁+1/n₂)) | proportions_ztest |
Welch t 是双样本的默认安全选项:方差不等时 pooled 版实际水平失真(该 5% 的检验在失衡样本下真实 α 能飙到 10% 以上),而 Welch 在方差齐时损失微乎其微——统计界共识"宁可 Welch 走天下"。模拟直接看证据:
import numpy as np from scipy import stats rng = np.random.default_rng(40) # 方差不齐 + 样本失衡:pooled 与 Welch 的实际第一类错误率 n1, n2, s1, s2 = 50, 200, 1.0, 4.0 reps = 10_000 fp_pool = fp_welch = 0 for _ in range(reps): a = rng.normal(0, s1, n1) b = rng.normal(0, s2, n2) # 真实无差异 if stats.ttest_ind(a, b, equal_var=True).pvalue < 0.05: fp_pool += 1 if stats.ttest_ind(a, b, equal_var=False).pvalue < 0.05: fp_welch += 1 print(f"pooled 实际α {fp_pool/reps:.4f} Welch 实际α {fp_welch/reps:.4f} 名义0.05")
典型输出 pooled 实际 α 在 0.08–0.12 区间(冤案率翻倍),Welch 稳在 0.05——方差不等 + 样本失衡时 pooled 版系统性制造假显著。
完整案例一:新旧两条产线的良率对比
产线 A 抽 25 件、产线 B 抽 35 件,尺寸数据如下(目标:B 是否与 A 均值不同)。流程示范"先看数据、再查方差、后选检验"的三步纪律:
import numpy as np from scipy import stats rng = np.random.default_rng(91) A = rng.normal(100.0, 2.0, 25) B = rng.normal(100.8, 2.0, 35) # 第一步:描述统计 print(f"A: 均值 {A.mean():.3f} SD {A.std(ddof=1):.3f}") print(f"B: 均值 {B.mean():.3f} SD {B.std(ddof=1):.3f}") # 第二步:方差齐性预检(Levene 检验) print("Levene p =", stats.levene(A, B).pvalue.round(3)) # 大 -> 可视为方差齐 # 第三步:双样本 t + 效应量 t, p = stats.ttest_ind(A, B) d = (B.mean() - A.mean()) / np.sqrt(((24*A.var(ddof=1)+34*B.var(ddof=1))/58)) print(f"t={t:.3f} p={p:.4f} Cohen d={d:.2f}") import statsmodels.stats.api as sms cm = sms.CompareMeans(sms.DescrStatsW(B), sms.DescrStatsW(A)) print("均值差 95% CI:", np.round(cm.tconfint_diff(usevar="pooled"), 3))
p≈0.17、效应量小、置信区间含 0——诚实的结论是"B 与 A 的差异未被本样本检出",而非"B 无差异"。把 p 值、效应量、区间三件套一起报告是本节的操作纪律。
完整案例二:A/B 测试的比例检验
新按钮 1040/12000 点击、旧按钮 961/12000。双比例 z 检验:
import statsmodels.stats.proportion as smp import numpy as np counts = np.array([1040, 961]); nobs = np.array([12000, 12000]) zstat, pval = smp.proportions_ztest(counts, nobs) p1, p2 = counts/nobs se = np.sqrt(p1*(1-p1)/nobs[0] + p2*(1-p2)/nobs[1]) print(f"z={zstat:.3f} p={pval:.4f} 差 {p1-p2:+.4f}") print(f"差的 95% CI [{(p1-p2)-1.96*se:.4f}, {(p1-p2)+1.96*se:.4f}]") # 提升幅度视角(业务语言) print(f"相对提升 {(p1/p2-1)*100:.2f}%")
p≈0.048 勉强显著、绝对差 0.66 个百分点、相对提升 8.2%。报告里最有价值的不是 p 值而是区间:相对提升的诚实范围还要再算一遍(delta 方法或 bootstrap)——业务方拍板需要的是"最差能赚多少",不是"是否显著"。
配对设计:免费的精度
同一批员工培训前后各测一次。配对把"人与人"的巨大个体差异直接消掉,只分析差值——好的设计比大的样本更值钱:
import numpy as np from scipy import stats rng = np.random.default_rng(2025) before = rng.normal(70, 12, 30) after = before + rng.normal(3.0, 4.0, 30) # 真实提升 3 分 t_paired = stats.ttest_rel(after, before) t_wrong = stats.ttest_ind(after, before) # 错当独立样本 print(f"配对 t: p={t_paired.pvalue:.2e}") print(f"误当独立: p={t_wrong.pvalue:.3f}")
同一份数据,配对分析 p 到 10⁻⁴ 量级、误当独立只剩 0.5 量级——配对结构用对了等于凭空多出几倍样本。反过来,把配对数据当独立样本处理是真实项目里最常见的分析事故之一。
图 7-3 四类检验的决策路线
本节要点回顾
- 三问定模板:单双样本、独立或配对、方差齐性——结构决定标准误
- Welch t 是双样本默认:pooled 在方差不齐时实际 α 失真到 10% 以上
- 配对设计消掉个体差异:同数据配对分析与误当独立可差几个数量级的 p 值
- 报告三件套:p 值 + 效应量 + 置信区间,缺一不可
- A/B 测试的业务语言是区间:"最差能赚多少"比"是否显著"更有决策价值
- 先描述、再检查前提、后检验:三步纪律防止模板套错