2.3 共轭梯度与 Krylov 子空间
2.3 共轭梯度与 Krylov 子空间
本节摘要:大规模稀疏对称正定系统的主力求解器是共轭梯度法(CG):每步只需一次矩阵向量乘法,理论上 n 步收敛,实践中误差按条件数的平方根衰减。预处理技术把条件数打下来,往往比换算法收益更大。本节从存储现实出发,实现 CG、观察收敛曲线、实测预处理收益。
一、案发背景:直接法的体力极限
三维热传导问题离散出 100 万个未知数时,矩阵每行只有约 7 个非零元——稀疏度 99.999%。两个现实卡死了直接法:
import numpy as np from scipy.sparse import diags n = 1_000_000 A = diags([[-1]*n, [4]*n, [-1]*n], [-1, 0, 1], format='csr') print(f"稀疏存储: {A.nnz * 12 / 1e6:.1f} MB") # 约 36 MB,完全可行 print(f"稠密存储: {n*n*8 / 1e9:.0f} GB") # 8000 GB,直接出局
稠密 LU 的填充效应更致命:消元会把稀疏矩阵填成接近稠密。破局思路是只跟矩阵做乘法,不碰它的元素——矩阵向量乘法对稀疏矩阵是 O(nnz) 的便宜操作,围绕它构建迭代法。
二、CG 的破案逻辑:共轭方向搜索
把解方程转译成最小化二次泛函:解 Ax=b(A 对称正定)等价于最小化 \phi(x) = \frac{1}{2}x^TAx - b^Tx。最速下降沿负梯度走,但在狭长山谷里来回锯齿(第三章会重演这个病理)。CG 的改进是让每一步的搜索方向关于 A 相互共轭——保证新方向不"undo"旧方向的进展,n 维空间最多 n 步搜到精确解。
完整实现(约二十行,值得亲手写一遍):
import numpy as np from scipy.sparse import diags from scipy.sparse.linalg import cg def conjugate_gradient(A, b, tol=1e-10, maxiter=None): n = len(b) maxiter = maxiter or 10 * n x = np.zeros(n) r = b - A @ x # 残差,也是负梯度 p = r.copy() rs_old = r @ r hist = [] for k in range(maxiter): Ap = A @ p alpha = rs_old / (p @ Ap) x += alpha * p r -= alpha * Ap rs_new = r @ r hist.append(np.sqrt(rs_new)) if np.sqrt(rs_new) < tol * np.linalg.norm(b): break p = r + (rs_new / rs_old) * p # 关键行:新方向 = 残差 + 动量项 rs_old = rs_new return x, hist n = 5000 A = diags([[-1]*n, [4]*n, [-1]*n], [-1, 0, 1], format='csr').toarray() b = np.ones(n) x, hist = conjugate_gradient(A, b) print(f"迭代步数: {len(hist)}, 最终残差: {hist[-1]:.2e}")
跑一下会发现:5000 阶矩阵几十步就收敛——远小于 n 步的理论上限。原因藏在谱里:CG 的收敛速率由条件数的平方根控制,误差每步约收缩 \frac{\sqrt{\kappa}-1}{\sqrt{\kappa}+1} 倍。条件数 1e4 的矩阵,最速下降式方法收缩因子约 0.98(慢如爬),CG 达到约 0.96 的平方根改善级——直观说,CG 把条件数的惩罚从开一次方降到开两次方。
三、收敛曲线诊断:特征值分布的证词
CG 的实际表现常常优于最坏界,因为收敛不只看条件数,还看特征值分布:
import numpy as np from scipy.sparse import diags # 均匀谱 vs 聚类谱:两者条件数相同,收敛速度天差地别 def make_matrix(eigs): Q, _ = np.linalg.qr(np.random.default_rng(1).standard_normal((len(eigs), len(eigs)))) return Q @ np.diag(eigs) @ Q.T n = 400 eig_spread = np.linspace(1, 1000, n) # 均匀铺开 eig_clustered = np.concatenate([np.linspace(1, 2, n//2), np.linspace(998, 1000, n//2)]) # 两簇 A1, A2 = make_matrix(eig_spread), make_matrix(eig_clustered) b = np.ones(n) _, h1 = conjugate_gradient(A1, b) _, h2 = conjugate_gradient(A2, b) print(f"均匀谱收敛步数: {len(h1)}") print(f"聚类谱收敛步数: {len(h2)}") # 显著更少
取证解读:特征值聚成少数几簇时,CG 几步就能"消灭"每簇对应的误差分量。这解释了椭圆算子离散矩阵(谱聚在高低端)上 CG 的超预期表现,也提示预处理的目标不必是把条件数打到 1,把谱聚成几簇同样有效。
四、预处理:给迭代法修高速匝道
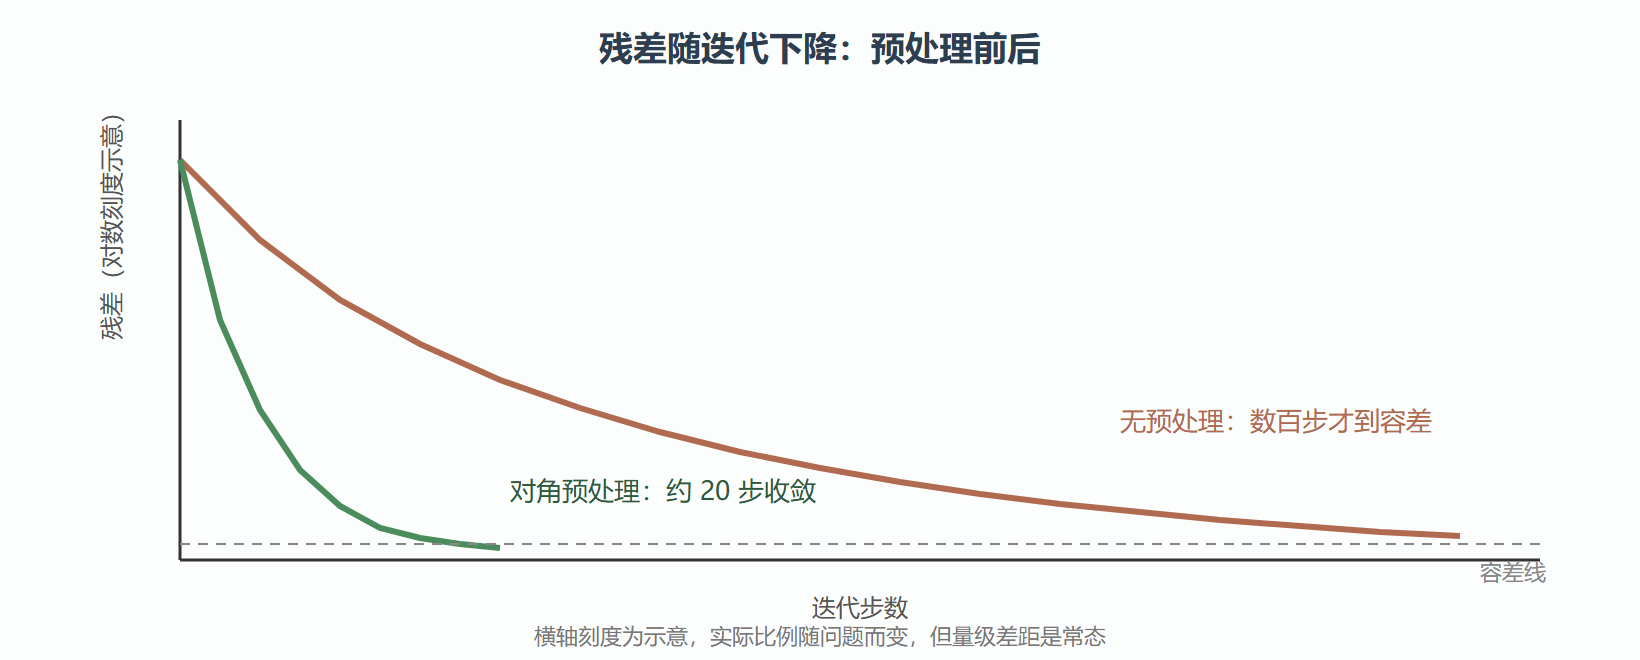
CG 收敛慢的根源是条件数大,而预处理通过解一个近似问题来压条件数——找矩阵 M 近似 A 且易于求解,把原方程改写为 M 逆作用的形式。对角预处理是最便宜的版本:
图 2.3-1 预处理前后收敛轨迹对比(示意)
实测代码:
import numpy as np from scipy.sparse import diags from scipy.sparse.linalg import cg n = 20000 # 尺度悬殊的对角:条件数被行尺度绑架 diag_v = np.logspace(0, 5, n) A = diags([diag_v], [0], format='csr') b = np.ones(n) x1, info1 = cg(A, b, rtol=1e-10) M = diags([1.0 / diag_v], [0], format='csr') # 对角预处理子 x2, info2 = cg(A, b, rtol=1e-10, M=M) # 用迭代计数对比(scipy 的 cg 返回 info,计数可由回调实现,这里看总时长与信息) print(f"无预处理 info: {info1}(0 表示收敛,超时为正数)") print(f"预处理后 info: {info2}")
解读:对角预处理把每一行除以自己的对角元,专门治理"尺度悬殊"型病态。更强的预处理子(不完全 Cholesky、代数多重网格)能再砍一个数量级的迭代数,代价是搭建成本。经验法则:在预处理器上花 30% 的开发时间,经常省掉 90% 的计算时间——这是并行于"换算法"的第二条优化路线。
⚠️ 常见坑一:用 CG 解非对称或非正定问题。数学前提崩塌,算法可能停滞或发散;非对称系统请用 GMRES、BiCGSTAB 一族。
⚠️ 常见坑二:把 CG 的收敛判据(相对残差 1e-10)当成解的精度。2.2 节的条件数定律在这里同样生效——迭代到机器极限也越不过条件数画下的天花板。
本节要点回顾
- 稀疏现实:百万阶矩阵只有 O(nnz) 存储与乘法可行,一切设计围绕矩阵向量积展开
- CG 双重收益:每步一次矩阵向量乘,误差按条件数的平方根衰减(优于最速下降的一次方)
- 谱聚类效应:条件数相同,特征值聚簇的矩阵收敛快得多;预处理目标是聚谱而非单纯降条件数
- 预处理优先:对角预处理治尺度病,不完全分解与多重网格治更深的病
- 适用边界:CG 仅限对称正定;收敛判据是残差口径,精度天花板仍由条件数决定
至此线性案件结卷。第三章进入非线性世界:那里没有超定结构可依赖,每个根都要靠局部线索一步步逼近。