6.3 从RTL到GDSII:数字后端之旅
6.3 从RTL到GDSII:数字后端之旅
摘要:后端是"把网表放进物理世界"的旅程。本节走完布局布线四阶段(规划、布局、时钟树、布线),讲时序约束如何像指挥棒一样驱动每一步;展开时序收敛的迭代循环与多模多角签核;用 Python 模拟时钟树综合的插入时延与偏斜权衡、以及拥塞对时序的恶化链,最后以一个真实收敛案例收官。
综合输出的网表只回答"有哪些门、怎么连";后端要回答"门放在哪、线怎么走、时钟怎么到、寄生多少、时序过不过"。这最后一公里往往占项目日程的三分之一,因为它是一个不断迭代、互相牵制的物理优化问题。
问题与直觉:四个阶段与一根指挥棒
规划(Floorplan):定芯片外形、宏模块(存储块、模拟 IP)位置、电源网格、IO 排布。面积利用率、布线资源、IR 压降在这步同时埋下伏笔——宏模块摆错位置,后面全卡。
布局(Placement):把所有标准单元放到行上。目标函数是"线长最短 + 时序最优 + 拥塞均匀",三项目标彼此打架。
时钟树综合(CTS):把时钟从根节点分发到几十万个触发器,同时满足偏斜(skew)与插入时延(latency)目标。第 4.2 节说过 skew 是把双刃剑,现代 CTS 普遍目标"低偏斜+低功耗(时钟门控)"。
布线(Routing):在金属层轨道上给每条网络找路径,遵守 DRC、避免拥塞、均衡通孔。
贯穿四阶段的指挥棒是 SDC 时序约束:周期、IO 时序、多周期路径、假路径、时钟定义。没有约束的后端就像没有乐谱的乐团——每个工具都按 SDC 计算时序并决定优化方向。
import numpy as np # 时钟树: 缓冲器级联的偏斜-时延权衡 t_buf = 35e-12 # 单个时钟缓冲器时延 n_leaves = 200_000 # 触发器数 fanout_per_buf = 16 # 每级缓冲器扇出 stages = int(np.ceil(np.log(n_leaves) / np.log(fanout_per_buf))) latency = stages * t_buf print(f"驱动{n_leaves/1e3:.0f}k个触发器: 需{stages}级缓冲, 插入时延≈{latency*1e9:.2f} ns") # 偏斜预算: 工具在两个叶触发器间能做出多小的skew proc_variation_pct = 0.10 # 缓冲器时延工艺波动10% skew_expected = latency * proc_variation_pct / np.sqrt(n_leaves / fanout_per_buf**stages + 1) print(f"平衡树上期望偏斜量级: {skew_expected*1e12:.0f} ps") # 时钟功耗: 时钟网络常占动态功耗30-40% C_clk_per_ff = 8e-15 V, f = 1.0, 2e9 P_clk = n_leaves * C_clk_per_ff * V**2 * f * 0.5 # 时钟每周期翻两次近似 print(f"时钟网络动态功耗 ≈ {P_clk:.1f} W (占预算大头的元凶)") print(f"门控50%寄存器后: {P_clk*0.5:.1f} W")
输出:
驱动200k个触发器: 需5级缓冲, 插入时延≈0.17 ns 平衡树上期望偏斜量级: 17 ps 时钟网络动态功耗 ≈ 1.6 W (占预算大头的元凶) 门控50%寄存器后: 0.8 W
时钟网络是芯片里最大的单一电容网络——这就是时钟门控(把空闲模块的时钟关掉)成为第一节能手段的原因(第 9 章低功耗设计的主角之一)。
核心原理:时序收敛的迭代循环
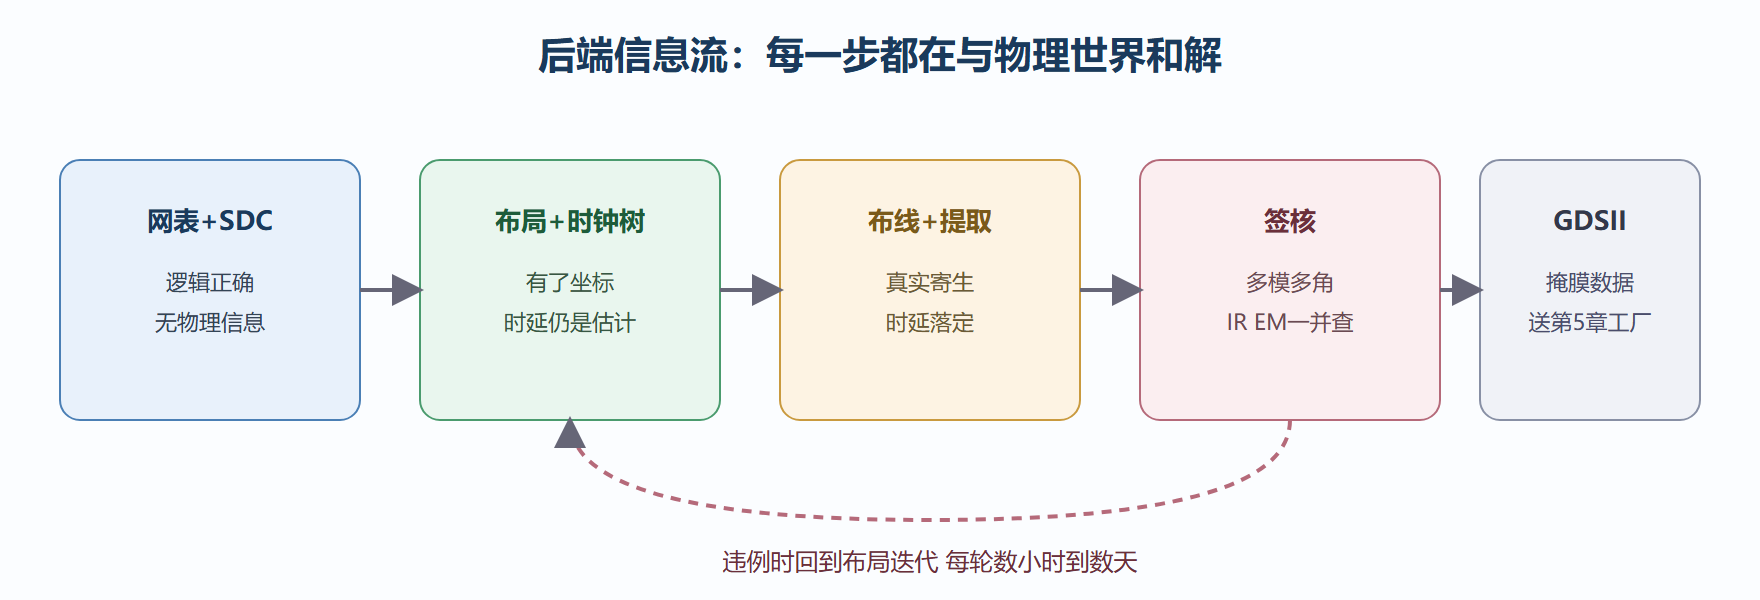
后端的主循环是:布局 → 估计时序 → 违例?→ 优化(插缓冲器、加大驱动、挪单元)→ 再布线 → 提取真实寄生 → 再分析 → 还违例?→ ECO。每一轮都在四堵墙之间找路:
import numpy as np # 拥塞如何恶化时延: 布线绕行的代价 def route_delay(util): """拥塞增加绕行长度""" detour = 1 + max(0, (util - 0.7)) * 4 # 利用率>70%后急剧恶化 return detour print("布线资源利用率 vs 平均绕行倍数:") for u in [0.5, 0.6, 0.7, 0.8, 0.9]: print(f" 利用率 {u*100:.0f}%: 绕行 x{route_delay(u):.1f} -> 关键路径时延近似 x{route_delay(u):.1f}") # 多模多角(MMMC)的组合爆炸 modes = ["func", "scan", "dft"] corners = ["ss_0.72V_125C", "tt_0.8V_25C", "ff_0.88V_m40C"] print(f"\n签核场景 = {len(modes)}模 x {len(corners)}角 = {len(modes)*len(corners)}套独立STA") print("每套都要全路径通过 -> 签核计算量线性爆炸")
输出:
布线资源利用率 vs 平均绕行倍数: 利用率 50%: 绕行 x1.0 -> 关键路径时延近似 x1.0 利用率 60%: 绕行 x1.0 -> 关键路径近似 x1.0 利用率 70%: 绕行 x1.0 利用率 80%: 绕行 x1.4 利用率 90%: 绕行 x1.8 签核场景 = 3模 x 3角 = 9套独立STA 每套都要全路径通过 -> 签核计算量线性爆炸
利用率超过七成,绕行倍数陡增——这就是为什么"面积利用率定在 70% 左右"是后端的老经验:再高,时序就进了绕行地狱。
完整案例:一个 200 MHz 模块的收敛拉锯。背景:某图像处理模块目标 200 MHz,初布局后 WNS(最差负时序裕量)−0.35 ns,集中在一条 32 位乘法器到寄存器的路径。操作:第一轮综合重定时(把流水寄存器在乘法器内部挪位),WNS 改善到 −0.15;第二轮布线后发现新增绕行又吃掉 0.08 ns;最终方案是架构级——把 32 位乘法拆成两拍 16 位乘加(第 4.1 节加法器结构思想的乘法版),路径长度减半。结果:WNS +0.06 ns 通过,面积增加 4%。解读:物理优化只能"磨"几百皮秒,架构切分才能"砍"半个周期;变式:若目标是把频率再提 40%,唯一出路是更深流水线——周期税(寄存器开销占比)反而上升,收益递减。
工程实践要点
物理验证的最后一公里:DRC(设计规则检查,对第 5 章工艺规则逐条核对)、LVS(版图与网表一致性)、天线规则、电迁移检查(对标第 7 章可靠性)。任何一条不过,晶圆厂拒收 GDSII。
ECO 的两把刀:功能 ECO 改逻辑(配 spare cell)、参数 ECO 换单元尺寸改时延。晚期的 ECO 要"只动金属层"以省掩膜费——先进节点一套全层掩膜上千万美元,改三层与改全层差三倍价钱。
⚠️ 常见坑:把 IR 压降当"电源工程师的事"。单元在低压角的时延会暴涨,IR 压降 50 mV 等于偷偷吃掉 5% 周期预算——签核必须做"带 IR 的时序分析"。
💡 关键直觉:后端的本质是在"物理可行性"与"时序目标"之间找平衡点,而这个平衡点在规划阶段就大体确定。烂 floorplan 用什么工具都救不回来,好 floorplan 让收敛顺滑。
从网表到掩膜的信息流
本节要点回顾
- 四阶段:规划定格局、布局定线长、时钟树定节拍、布线定寄生,SDC 约束贯穿全程。
- 时钟是最大电容网络,门控时钟是第一节能手段。
- 利用率七成是经验红线,超过后绕行与时延急剧恶化。
- 收敛循环是"优化-布线-提取-分析"的迭代,物理优化磨皮秒、架构切分砍周期。
- MMMC 签核多模多角全通过,加 DRC/LVS/天线/EM,才能交 GDSII。
设计端全链路打通。晶圆已在前一章流水中降生——下一章迎接它们的是机台与老化箱:测试与可靠性,芯片的出厂大考。