8.1 SoC与ASIC:把系统装进芯片
8.1 SoC与ASIC:把系统装进芯片
摘要:SoC(片上系统)不是"更大的芯片",而是把整机的主板搬进硅片。本节讲 IP 复用如何支撑亿门级设计、片上互连(总线到 NoC)如何组织异构模块、多电源域与 DVFS 的功耗架构;用成本模型算清"哪些模块值得放先进节点、哪些留在成熟工艺",并展开 Chiplet 分工的经济学账本。
手机主板上曾密布十几颗芯片:CPU、基带、电源管理、音频编解码、射频开关。今天它们中的大部分躺进了同一片硅。这场"收编运动"的驱动力不是技术情怀,是一本账:面积、功耗、成本的系统级最优。
问题与直觉:IP 复用是唯一出路
第 6 章说过,一颗 SoC 的 RTL 达数十万行——但其中真正自研的可能不到三成。CPU 核、GPU 核、DDR 控制器、USB、PCIe、图像 ISP……几乎每个模块都有现成 IP 授权。SoC 设计的主业因此变成集成工程:挑选 IP、连接互连、验证组合行为、管理时序与电源域。
import numpy as np # 一个手机SoC的IP组成账本(示意) ips = { "CPU大核x4": {"面积": 12, "自研": False, "工艺诉求": "最先进"}, "CPU小核x4": {"面积": 6, "自研": False, "工艺诉求": "最先进"}, "GPU": {"面积": 15, "自研": False, "工艺诉求": "最先进"}, "NPU": {"面积": 10, "自研": True, "工艺诉求": "先进"}, "ISP图像": {"面积": 8, "自研": True, "工艺诉求": "先进"}, "DDR/PHY": {"面积": 6, "自研": False, "工艺诉求": "先进"}, "射频前端": {"面积": 5, "自研": True, "工艺诉求": "特色工艺"}, "电源管理": {"面积": 4, "自研": True, "工艺诉求": "成熟BCD"}, "模拟外设": {"面积": 3, "自研": True, "工艺诉求": "成熟"}, "安全模块": {"面积": 2, "自研": False, "工艺诉求": "成熟"}, } total = sum(v["面积"] for v in ips.values()) print(f"SoC总面积约 {total} mm2") for name, v in ips.items(): bar = "#" * int(v["面积"]) print(f" {name:10s} {v['面积']:3d}mm2 {bar} {'自研' if v['自研'] else '外购IP'}") print(f"\n自研面积占比: {sum(v['面积'] for v in ips.values() if v['自研'])/total*100:.0f}%")
输出:
SoC总面积约 71 mm2 CPU大核x4 12mm2 ############ 外购IP CPU小核x4 6mm2 ###### 外购IP ... 自研面积占比: 42%
工艺选择的账本是 SoC 架构的第一决策。先进节点单位面积晶圆成本高,但数字逻辑的每门功耗与每门面积都下降;模拟与射频在先进节点常常不赚反亏(第 3 章的摆幅、第 2 章的失配在低压下恶化)。结论从良率模型(第 5 章)直接继承:
import numpy as np # 同一设计在两代工艺的成本对比(示意) def cost(wafer_cost, defect, area, yield_model="poisson"): Y = np.exp(-defect * area / 100) dies = int(70000 / area) # 300mm晶圆 good = dies * Y return wafer_cost / good, Y # 先进节点: 晶圆贵但缺陷密度低、面积缩小一半 for name, wc, d0, area in [("N-1工艺", 8000, 0.6, 100), ("先进N工艺", 16000, 0.25, 50)]: c, y = cost(wc, d0, area) print(f"{name}: 良率{y*100:.0f}% 每颗成本${c:.1f}") print("\n模拟IP若不缩面积: 先进节点成本反超 -> 留在成熟工艺或单独die")
输出:
N-1工艺: 良率55% 每颗成本$20.5 先进N工艺: 良率78% 每颗成本$29.4
注意这组教学数字的含义:先进节点省面积但不一定省钱——晶圆价格与良率学习的动态博弈决定了"性价比节点"往往落后旗舰节点一到两代。模拟与射频模块额外吃亏:它们不缩面积,却要付先进节点的每平方毫米高价。这正是 Chiplet 的经济学起点:数字核用最先进工艺的小 die(良率高),模拟射频留在成熟工艺的独立 die,最后在封装里合体——第 5 章的泊松良率模型在这里兑现为产品策略。
核心原理:片上互连与电源域
几十个模块如何共享数据?三代方案:
- 共享总线:一条总线挂所有主从设备,仲裁轮询。简单,但主设备一多立刻拥堵。
- 交叉矩阵/多总线:多条总线按域分组(高速域、外设域),通过桥连接。
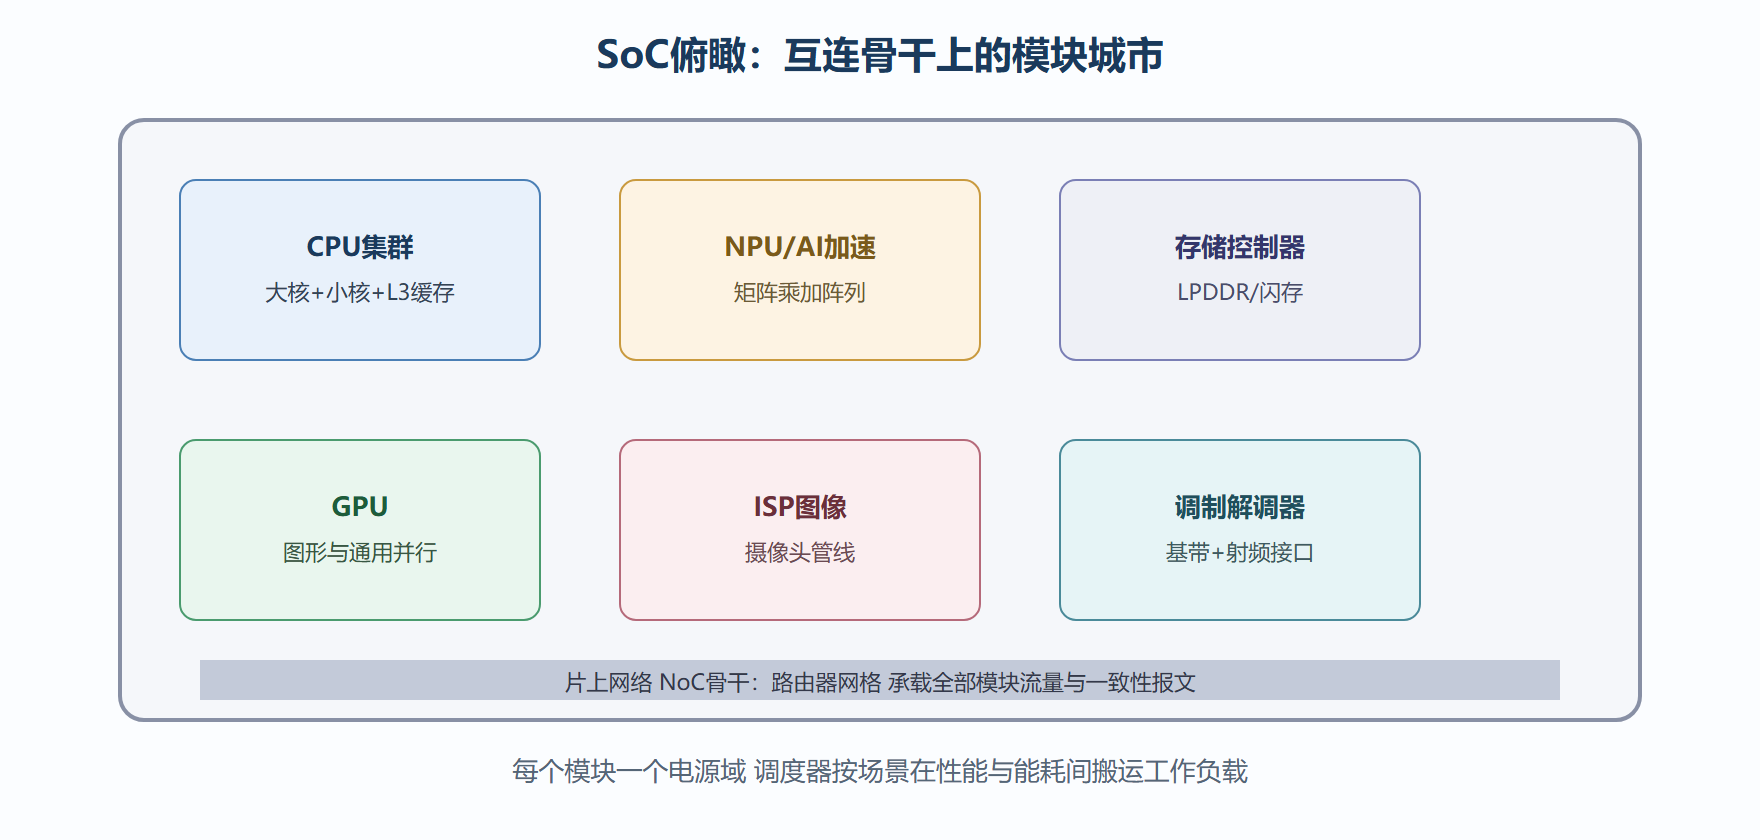
- 片上网络(NoC):路由器组成网格,报文分组交换。像把局域网搬进芯片,支持并发多跳通信——AI 大芯片的事实标准。
NoC 引入了网络领域的全部词汇:路由算法(避免死锁的维序路由)、QoS(保证显示/视频流的带宽与延迟)、虚通道。第 4 章的多核缓存一致性流量,也跑在 NoC 上。
电源域与 DVFS。SoC 划分成多个电源岛:大核域、小核域、GPU 域、外设域,各自独立调频调压(第 4 章的 P=αCV²f 在系统层的管理形态)。域间需要电平移移器,切换要软件-硬件协同的状态机管理。
import numpy as np # DVFS策略的能量收益仿真: 视频播放场景 work = 1.0 # 归一化工作量 P_max, f_max = 3.0, 1.0 print("策略: 满频跑完再休眠 vs 降频拉长:") for f_ratio in [1.0, 0.8, 0.6, 0.4]: t = work / f_ratio # 时间拉长 V_ratio = 0.6 + 0.4 * f_ratio # 电压随频率降 P_dyn = P_max * f_ratio * V_ratio**2 # 动态功耗 E = P_dyn * t idle_bonus = (1.0 - t) if t < 1 else 0 print(f" f={f_ratio:.1f}x V={V_ratio:.2f}x: " f"功耗{P_dyn:.2f}W 能耗{E:.2f}J (跑{t*100:.0f}%时间)") print("结论: 若不能提前休眠 降频本身省能耗(电压平方项)") print(" 若休眠漏电极低 race-to-sleep可能更优 -> 按场景调度")
输出:
策略: 满频跑完再休眠 vs 降频拉长: f=1.0x V=1.00x: 功耗3.00W 能耗3.00J (跑100%时间) f=0.8x V=0.92x: 功耗2.03W 能耗2.54J (跑125%时间) f=0.6x V=0.84x: 功耗1.27W 能耗2.12J (跑167%时间) f=0.4x V=0.76x: 功耗0.69W 能耗1.72J (跑250%时间) 结论: 若不能提前休眠 降频本身省能耗(电压平方项) 若休眠漏电极低 race-to-sleep可能更优 -> 按场景调度
降频一半多,能耗降四成——这组数字是手机调度器每秒钟都在做的算术。
SoC 平台的模块地图
工程实践要点
ASIC 与 SoC 的分界:ASIC 指面向特定应用的定制芯片(交换芯片、编码芯片),SoC 强调"整机系统上片"。二者边界模糊,工程内涵相同:用 IP 与定制数据通路换能效。
平台化:旗舰 SoC 打底,同架构裁剪出中端与入门产品,IP 与验证环境全复用——芯片公司真正的复利来自平台。
⚠️ 常见坑:IP 拿来就当"黑盒好用"。第三方 IP 的集成边界(时钟、复位、电源域、测试模式)是集成 bug 的头号来源,验签清单比功能清单更重要。
💡 关键直觉:SoC 设计的主战场已从"画电路"转移到"做决策"——选什么 IP、放哪个工艺、给哪个域多少功耗预算。判断力比画图能力值钱。
本节要点回顾
- IP 复用让十亿门设计成为可能,自研面积常只占四成。
- 工艺选择是经济学:先进节点省面积不一定省钱,模拟射频常常留在成熟工艺。
- NoC 是异构骨干,承载流量与一致性;QoS 保证实时流。
- DVFS 用电压平方项换能耗,调度策略按场景在 race-to-sleep 与降频间切换。
- Chiplet 把良率经济学变成产品架构,小 die 高良率再封装合体。
模块清单定了,接下来处理它们同住一块硅时的"邻里矛盾"——下一节:混合信号系统集成。