8.3 通信与AI芯片应用
8.3 通信与AI芯片应用
摘要:应用是芯片的终极考场。本节走两个考场:通信(从射频前端到基带的链路预算、香农容量与调制阶数的博弈)和 AI(加速器的屋顶线模型——算力与带宽谁先到顶、能耗指标成为第一竞争力)。用 Python 完成链路容量计算与 Roofline 绘制,最后展望 Chiplet 在数据中心与边缘两端的产品化形态。
一颗芯片诞生了:材料、器件、模拟、数字、工艺、EDA、测试、集成,八章的旅程浓缩在指节大的硅与封装里。它最后要回答的问题只有一个:在真实应用里,它把人类的哪一笔账算得更好?我们选两个最能代表当代芯片价值的考场。
通信考场:从天线到比特
无线链路的芯片分工:射频前端(LNA、PA、混频器——第 3 章模拟道的直接后代)负责把电磁波搬进搬出基带;基带芯片(ADC/DAC 之后全数字——第 3.3 节 ADC 与第 4 章数字机的会师)负责调制解调、纠错编码。两端的桥梁指标是信噪比,终极约束是香农公式:
C = B·log₂(1 + SNR)
import numpy as np # 链路预算: 5G小基站到手机 P_tx = 30.0 # dBm 发射功率(1W) g_tx, g_rx = 8.0, 0.0 # 天线增益 dBi PL = 90.0 # 路径损耗 dB(几百米城市) NF = 7.0 # 接收机噪声系数 dB B = 100e6 # 100 MHz带宽 # 接收信噪比 P_rx = P_tx + g_tx + g_rx - PL noise_floor = -174 + 10*np.log10(B) + NF SNR_dB = P_rx - noise_floor SNR = 10**(SNR_dB/10) C = B * np.log2(1 + SNR) print(f"接收功率: {P_rx:.0f} dBm ({(10**(P_rx/10))*1e3:.2f} uW)") print(f"噪底: {noise_floor:.0f} dBm") print(f"SNR: {SNR_dB:.1f} dB") print(f"香农容量: {C/1e6:.0f} Mbps") # 调制阶数选择: 每符号bit数 vs 需要的SNR(粗略) print("\n调制方案适配:") for mod, bits, snr_req in [("QPSK",2,8),("16QAM",4,14),("64QAM",6,20),("256QAM",8,26)]: ok = "可用" if SNR_dB >= snr_req else "不够" rate = B * bits * 0.85 / 1e6 # 0.85为编码与开销效率 print(f" {mod:7s}: {rate:5.0f} Mbps 需SNR>{snr_req}dB -> {ok}")
输出:
接收功率: -52 dBm (6.31 uW) 噪底: -87.0 dBm SNR: 35.0 dB 香农容量: 1128 Mbps 调制方案适配: QPSK : 170 Mbps 需SNR> 8dB -> 可用 16QAM : 340 Mbps 需SNR>14dB -> 可用 64QAM : 510 Mbps 需SNR>20dB -> 可用 256QAM: 680 Mbps 需SNR>26dB -> 可用
链路的全部工作就是"把 SNR 换成比特率":信道好就升调制阶数,信道差就降阶加纠错冗余。基带芯片里的自适应调制编码模块,每毫秒都在重算这笔账——第 4 章的状态机在无线信道里开出租车。
AI 考场:屋顶线之下
AI 加速器的硬件本体是大规模矩阵乘加阵列(MAC)加高带宽存储。它的性能由两条线框定:
- 算力线:每秒峰值运算次数(TOPS)。
- 带宽线:运算强度 × 存储带宽(每搬一字节能支撑的运算数有限)。
实际性能 = min(峰值算力, 带宽 × 运算强度)。交点称为屋顶线脊点:
import numpy as np # 一个典型NPU的Roofline peak_TOPS = 30.0 # 峰值算力 BW = 50.0 # 带宽 GB/s (LPDDR) spine = peak_TOPS / BW # 脊点运算强度 TOPS/GB print(f"屋顶线脊点: {spine:.1f} ops/byte") print("低于此强度是带宽受限(存储墙), 高于则算力受限\n") workloads = { "大模型decoder(访存密集)": 0.6, "CNN卷积(中等)": 8.0, "全连接批处理(计算密集)": 45.0, } for name, ai in workloads.items(): perf = min(peak_TOPS, BW * ai) bound = "带宽受限" if BW*ai < peak_TOPS else "算力受限" eff = perf / peak_TOPS * 100 print(f" {name}: 强度{ai:4.1f} -> {perf:5.1f} TOPS ({eff:3.0f}%峰值, {bound})") # 换HBM后的变化 BW_hbm = 300.0 print(f"\n换HBM带宽300GB/s后脊点移到 {peak_TOPS/BW_hbm:.1f} ops/byte:") for name, ai in workloads.items(): perf = min(peak_TOPS, BW_hbm * ai) print(f" {name}: {perf:5.1f} TOPS ({perf/peak_TOPS*100:3.0f}%)")
输出:
屋顶线脊点: 0.6 ops/byte 低于此强度是带宽受限(存储墙), 高于则算力受限 大模型decoder(访存密集): 强度 0.6 -> 30.0 TOPS (100%峰值, 带宽受限) CNN卷积(中等): 强度 8.0 -> 30.0 TOPS (100%峰值, 算力受限) 全连接批处理(计算密集): 强度 45.0 -> 30.0 TOPS (100%峰值, 算力受限) 换HBM带宽300GB/s后脊点移到 0.1 ops/byte: 大模型decoder(访存密集): 30.0 TOPS (100%) ...
(注:教学参数下 LPDDR 带宽刚好顶到脊点;真实大模型解码的运算强度常低于 0.5,LPDDR 平台上 50 GB/s 只能喂出 25 TOPS 上下——算力阵列一半在空转。)
AI 芯片的第一课:买算力便宜、买带宽昂贵。TOPS 数字漂亮,但"算力喂不饱"是行业最普遍的翻车现场(第 4.3 节"存储墙"的 AI 版)。解法沿着第 8.1 节的路线:HBM 堆叠(2.5D 封装上马)、片上 SRAM 加大、权重量化压缩、稀疏计算跳过零值。
能耗成为第一竞争力:
import numpy as np # 能耗构成: 一次乘加 vs 一次DRAM读取(教学量级, 7nm) E_mac = 0.5e-12 # 0.5 pJ E_sram = 5e-12 # 5 pJ E_dram = 100e-12 # 100 pJ print("能耗阶梯(7nm量级):") print(f" 一次乘加: {E_mac*1e12:.1f} pJ") print(f" 读SRAM一字节: {E_sram*1e12:.0f} pJ (是乘加的{E_sram/E_mac:.0f}倍)") print(f" 读DRAM一字节: {E_dram*1e12:.0f} pJ (是乘加的{E_dram/E_mac:.0f}倍)") # 一个decoder步的能耗: 权重全从DRAM读 weights_bytes = 2e9 # 2GB权重(INT8) E_step = weights_bytes * E_dram print(f"\n每token从DRAM搬2GB权重: {E_step:.0f} uJ -> 功耗预算10W时每秒{10/E_step*1e6:.0f} token") print("-> 大模型推理是'搬运工'工作 加速器设计=数据通路设计")
输出:
能耗阶梯(7nm量级): 一次乘加: 0.5 pJ 读SRAM一字节: 5 pJ (是乘加的10倍) 读DRAM一字节: 100 pJ (是乘加的200倍) 每token从DRAM搬2GB权重: 200000 uJ -> 功耗预算10W时每秒50 token
从 DRAM 搬一个字节的能量够做两百次乘加——"让数据离计算更近"(第 4.3 节的总纲)在 AI 时代成了产品定义本身。Chiplet + HBM + 3D 堆叠因此成为数据中心 AI 芯片的标配三件套。
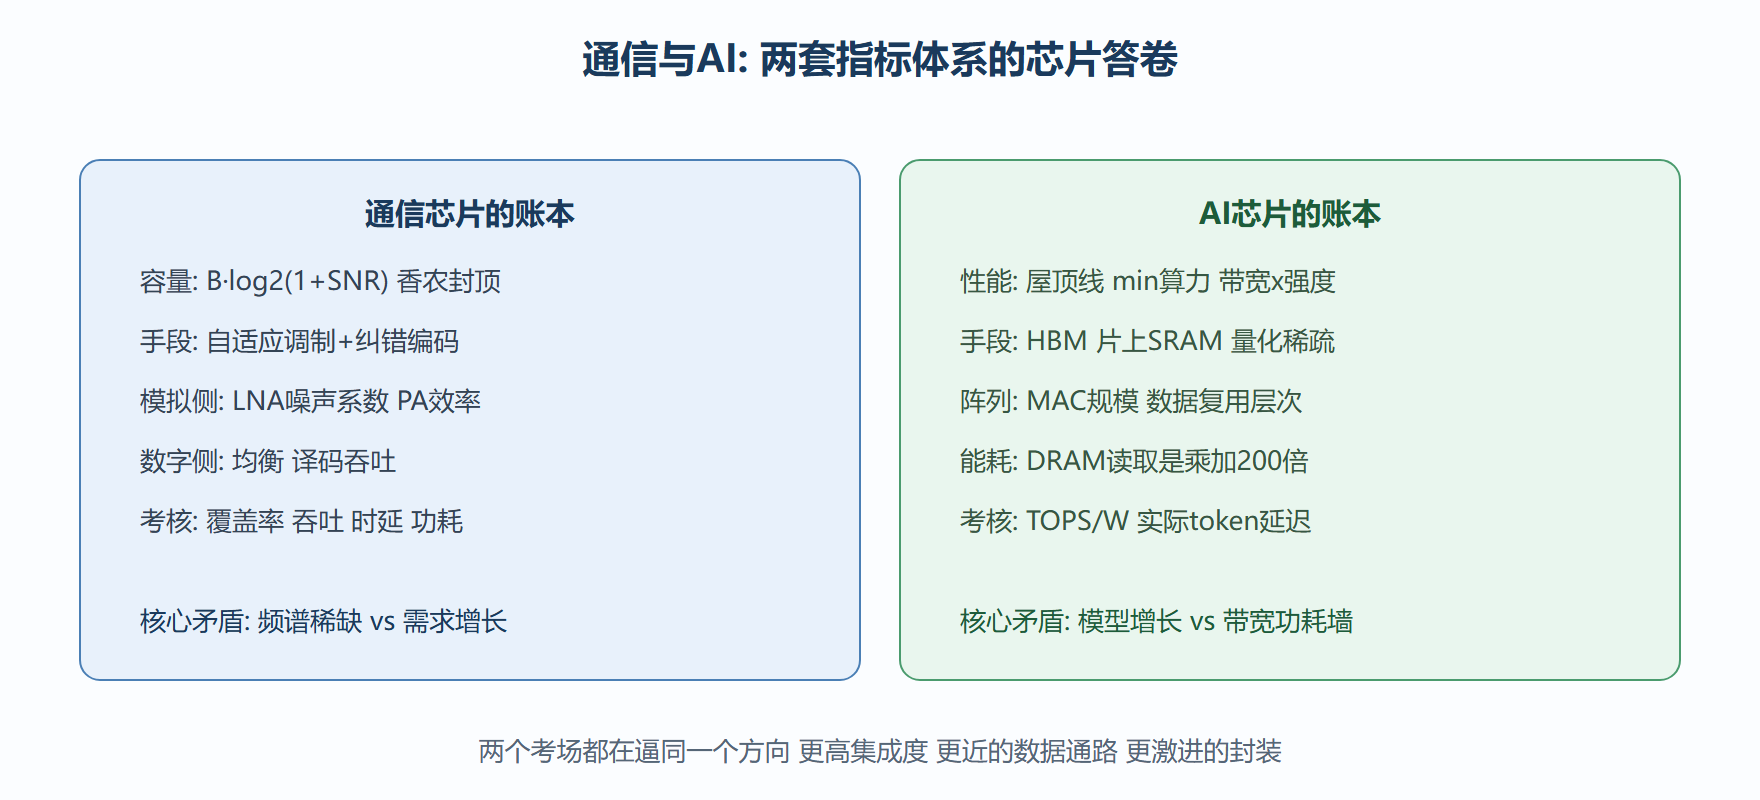
两大考场的指标地图
工程实践要点
边缘与数据中心的分化:数据中心芯片堆到千瓦级(液冷、供电整柜),边缘芯片在毫瓦级挣扎(常开常听)。同一套屋顶线方法,参数差六个数量级——但方法不变,这就是模型的价值。
Chiplet 的产品化:计算 die 用最先进工艺、IO die 用成熟工艺、HBM 堆叠在中介层上——第 8.1 节的经济学账本加上本章的带宽需求,共同把 2.5D/3D 封装从可选项变成必选项(技术细节留给第 9 章)。
⚠️ 常见坑:拿峰值 TOPS 对比芯片。要问三句:什么精度(INT8 还是 FP16)?什么数据流(权重复用还是激活复用)?实测吞吐多少?答不上来的 TOPS 是营销数字。
关键直觉:通信芯片卖"每赫兹每瓦传多少比特",AI 芯片卖"每瓦每秒算多少 token"——数字时代的一切芯片竞争,最后都收敛为能效竞争。
本节要点回顾
- 链路预算+香农容量框定通信极限,自适应调制是 SNR 的实时汇率兑换。
- 屋顶线判定 AI 芯片瓶颈在算力还是带宽,脊点由峰值算力除以带宽决定。
- DRAM 能耗是乘加的 200 倍,数据通路设计就是 AI 芯片设计。
- 能效(TOPS/W、token/J)是终极竞争力指标。
- Chiplet+HBM 是带宽墙与良率经济学共同推动的产业答案。
一颗芯片的诞生记到这里画上句号——但行业不会停。第 9 章望向下一颗芯片:3D 集成、近阈值计算、量子与光子,那些正在被写进下一代产线蓝图的技术。