3.1 嵌入模型与向量化
3.1 嵌入模型与向量化
本节摘要:嵌入模型把文本压成定长向量,语义相近的文本在向量空间里距离更近,这是整个向量检索的数学地基。本节用实验演示"语义距离"的真实含义,给出嵌入模型的选型维度(语言、维度、长度上限、检索性能),并强调一个常被跳过的步骤:用你自己的语料验证嵌入质量。
先做实验,再讲道理
抽象定义不如一个对照实验直观。同一段"退货政策"文本,配上三个问题——一个同义改写、一个相邻主题、一个完全无关——看余弦相似度是否给出了符合直觉的排序:
import numpy as np from llama_index.embeddings.huggingface import HuggingFaceEmbedding embed = HuggingFaceEmbedding(model_name="BAAI/bge-small-zh-v1.5") chunk = "自签收日起 7 天内可无理由退货,30 天内质量问题可退货。" queries = [ "买了东西想退,最多能拖几天?", # 同义改写 "会员积分怎么兑换商品?", # 相邻主题 "今天天气适合登山吗?", # 完全无关 ] def cos(a, b): a, b = np.array(a), np.array(b) return float(a @ b / (np.linalg.norm(a) * np.linalg.norm(b))) for q in queries: print(f"{cos(embed.get_query_embedding(q), embed.get_text_embedding(chunk)):.4f} {q}")
正常输出里同义改写得分最高、无关问题最低。如果排序不对,后面的一切检索优化都是在流沙上盖楼。这就是为什么本节坚持"先实验后选型"。
嵌入空间在做什么
可以把它理解为"把意思翻译成坐标":模型在海量语料上学会了"什么和什么出现在相似语境里",于是"退货"与"退换货"被放到邻近坐标,"退货"与"登山"相距甚远。余弦相似度只看方向不看长度,取值约在 0 到 1 之间(归一化后),越大越近。向量检索的本质就是:把查询也翻译成坐标,然后找库中最近的 K 个邻居。
值得知道的一个结构性局限:嵌入把整段文本压成一个点,长文本的多个主题会被平均掉。一份既讲退货又讲积分的 1000 字文档,其向量落在两个主题的"中间地带",对两个主题的查询都不够近。这正是第 2 章"切分粒度"的数学解释——两章在这里咬合。
选型维度
用自己的语料做嵌入评估
公开榜单(MTEB 等)只是初筛。落到你的场景,做一个迷你"问答对命中率"评估更可靠:
# 迷你评估:10 个问题 + 人工标注的正确出处片段 eval_set = [ ("退货最长期限", "30 天内质量问题可退货"), ("P8 住宿标准", "P8 及以上住宿上限 800 元"), # …… 凑够 10 条,覆盖典型问题形态 ] hits = 0 for question, gold_text in eval_set: qv = embed.get_query_embedding(question) sims = [cos(qv, embed.get_text_embedding(n.text)) for n in nodes] best = nodes[int(np.argmax(sims))] hits += (gold_text[:12] in best.text) print(f"嵌入 + 最近邻 命中率: {hits}/{len(eval_set)}")
把候选嵌入模型各跑一遍这个脚本,命中率就是你的选型依据。这个过程十分钟就能搭起来,却是整个索引层回报率最高的十分钟。
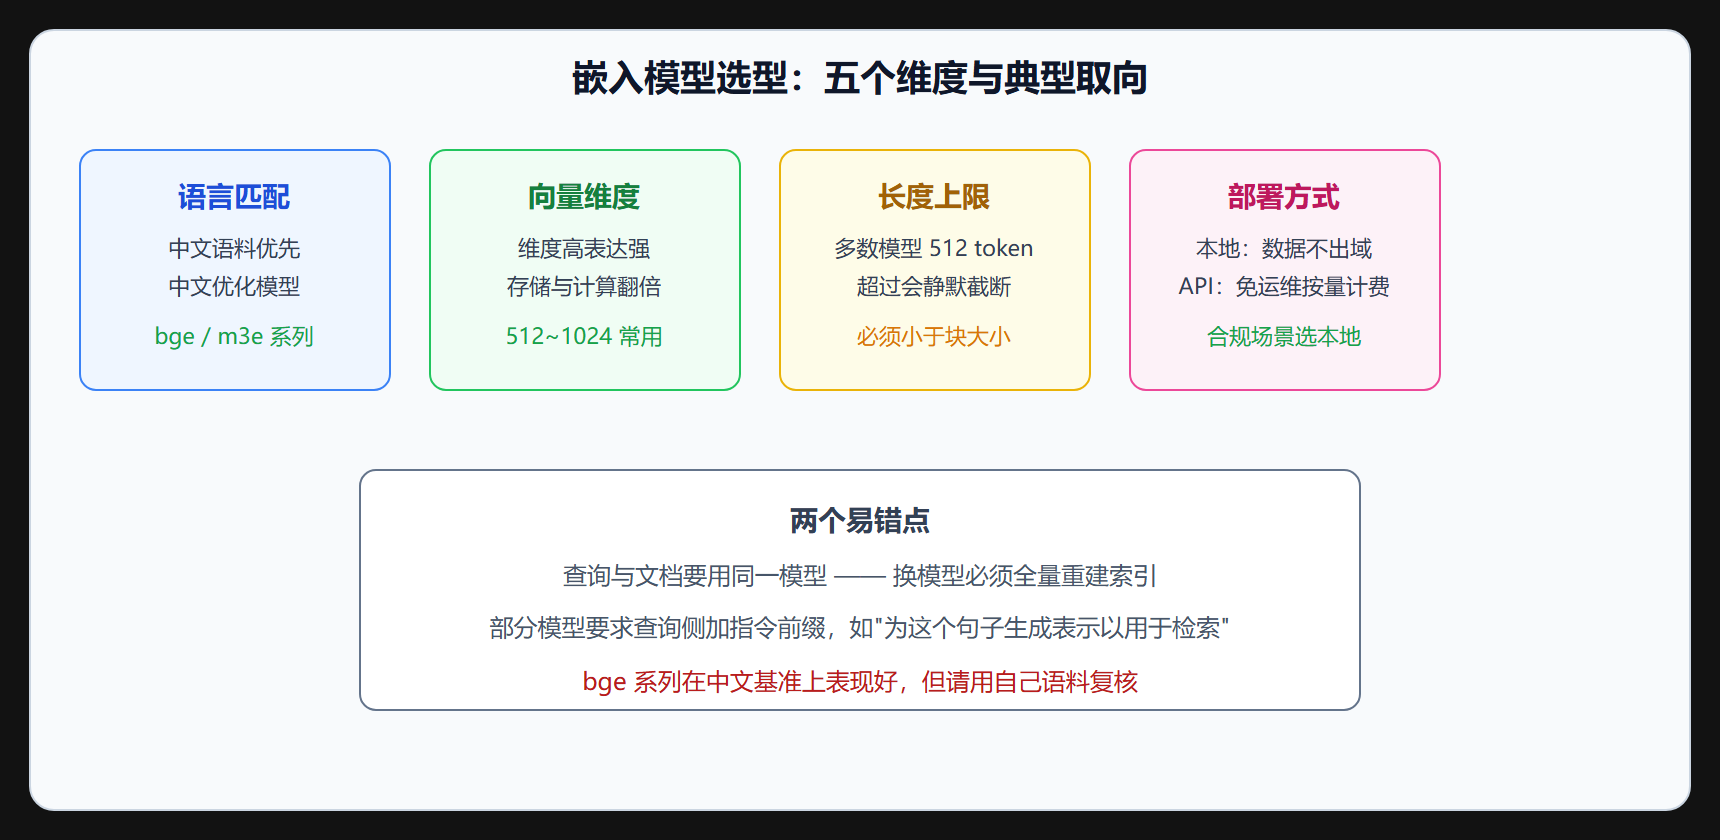
⚠️ 常见坑:切换嵌入模型后只重建了一半数据(比如只重新嵌入新增文档),新旧向量不在同一空间,检索结果会诡异变差且很难排查。换模型 = 全量重建,没有例外。
本节要点回顾
- 向量即坐标:嵌入把语义翻译成坐标,余弦相似度量化语义距离——先用实验确认排序符合直觉再谈选型。
- 平均化局限:长文本多主题被平均,切分粒度问题在此获得数学解释。
- 五维选型:语言、维度、长度上限、部署方式、榜单初筛加自评复核。
- 同模型铁律:查询与文档同模型,换模型必须全量重建索引。
- 迷你评估:十道题的命中率脚本是最便宜的选型保险。
常见问题
中文语料用多语言模型还是中文专用模型? 如果查询与文档都是中文,中文专用模型通常在检索精度上更占优;如果语料中英混杂(技术文档常见),多语言模型更稳。这个结论会随模型版本变化,所以更可靠的做法永远是拿 3.1 节的迷你评估脚本跑一次自己语料的对比。
向量维度越高检索越准吗? 不一定。维度提升带来的表达力增益会边际递减,而存储与计算的代价线性增长。检索质量更多取决于模型训练得好不好,而不是输出向量有多长。工程上从 512 到 1024 维的常见档位起步即可,除非评估显示瓶颈在表达力,否则别为高维度买单。
嵌入分数能跨模型比较吗? 不能,甚至同一模型不同距离度量下分数含义都不同。这就是为什么 4.1 节强调"分数阈值"要慎用:换模型、换度量,阈值全部重调。稳健的做法是把分数用于"同一查询内的相对排序",而不是跨查询的绝对判断。
再补充一个进阶但实用的知识点:查询侧与文档侧的嵌入不对称。多数嵌入模型对"查询"与" passages"采用不同的编码方式,好的集成包会自动处理(get_query_embedding 与 get_text_embedding 正是为这个区分而存在),自己直接裸调模型 API 时要手动加相应前缀,否则检索质量会莫名打折。这也是"用框架封装而不是裸调"的一个具体理由。
关于嵌入模型的更新节奏:这个领域迭代很快,值得每半年重新做一次 3.1 节的迷你评估——新一代模型常在同维度下带来明显的检索精度提升,而升级的全部代价只是全量重嵌一次(费用可估)加上评估集回归验证。
最后落一个动作项:今天就为你的项目建一个嵌入评估的小脚本(十道题的迷你版),把当前使用的嵌入模型得分记下来存进版本库。这个数字是索引层一切后续优化的原点——三个月后你换模型、调参数时,会感谢今天留下的这个基准点。