3.2 核心索引类型及其应用场景
3.2 核心索引类型及其应用场景
本节摘要:LlamaIndex 提供四种核心索引——VectorStoreIndex(语义相似)、SummaryIndex(顺序遍历做摘要)、TreeIndex(自底向上摘要成树、查询时逐层聚焦)、KnowledgeGraphIndex(实体关系三元组)。本节用同一份语料分别建四种索引,观察它们对"找条款"与"写总结"两类问题的不同表现,并给出选型矩阵。
一个问题形态实验
准备好两类问题:"P8 的住宿上限是多少"(精确找条款)与"总结这份制度的差旅规定"(全局概括)。直觉上前者该用向量索引、后者该用摘要索引,实验来验证:
from llama_index.core import ( VectorStoreIndex, SummaryIndex, SimpleDirectoryReader) docs = SimpleDirectoryReader("./data").load_data() # 向量索引:语义检索的默认选择 vec_index = VectorStoreIndex.from_documents(docs) vec_engine = vec_index.as_query_engine() print(vec_engine.query("P8 的住宿上限是多少?")) # 摘要索引:把所有节点顺序喂给模型做整体概括 sum_index = SummaryIndex.from_documents(docs) sum_engine = sum_index.as_query_engine(response_mode="tree_summarize") print(sum_engine.query("总结这份制度的差旅规定"))
向量索引对第二类问题会吃亏:它只召回最像"差旅总结"的几个片段,写出来的总结天然偏采样。摘要索引对第一类问题则浪费:为了一个条款遍历全部内容,慢且贵。索引类型 = 对查询方式的预判。
树索引与图谱索引
from llama_index.core import TreeIndex # 树索引:叶子是原文块,逐层自动摘要成树根 tree_index = TreeIndex.from_documents(docs, num_children=10) tree_engine = tree_index.as_query_engine(child_branch_factor=2) # 查询时从树根向下选择相关分支 —— 先粗后细,适合超长文档 print(tree_engine.query("这份文档最核心的三个变化是什么?"))
from llama_index.core import KnowledgeGraphIndex # 图谱索引:抽取实体与关系构成三元组,按关系遍历回答关联性问题 kg_index = KnowledgeGraphIndex.from_documents( docs, max_triplets_per_chunk=5, include_embeddings=True, # 三元组也做向量检索 show_progress=False, ) kg_engine = kg_index.as_query_engine() # 优势问题形态:甲和丙之间有什么联系? print(kg_engine.query("报销审批链条上,总监之后是谁参与?"))
图谱索引的建造成本最高(每块都要过一遍 LLM 抽三元组),只在"关系型问题"占比高时才值得——合同主体关系、组织架构影响链、药品相互作用这类语料。
选型矩阵
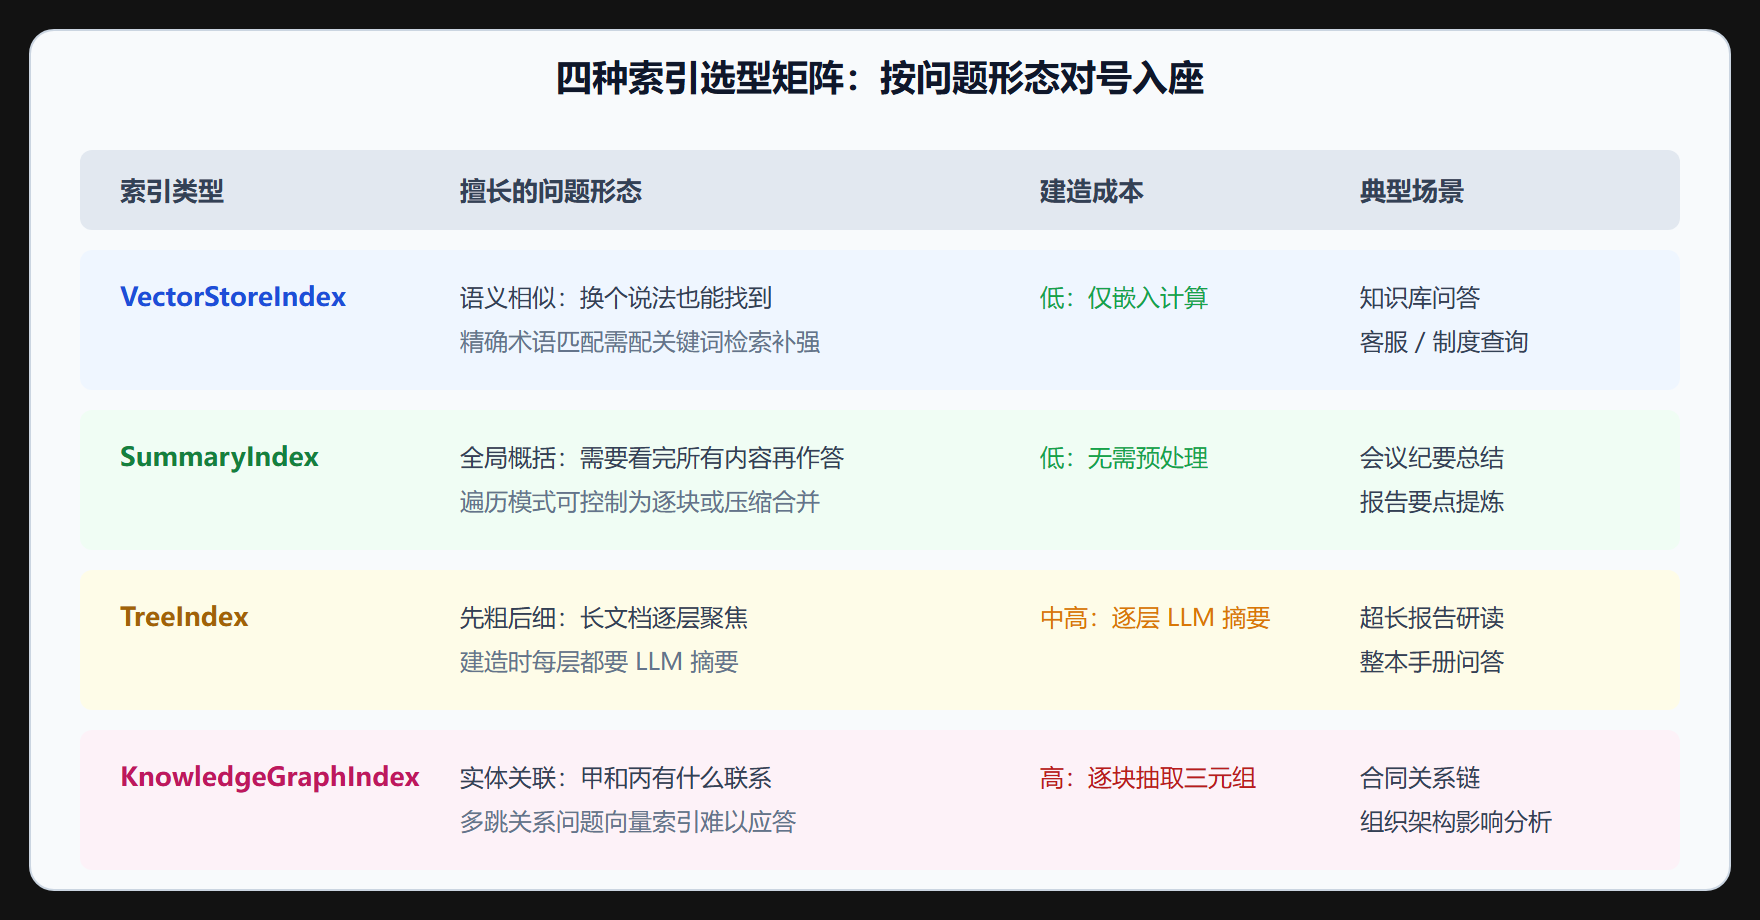
组合才是常态
真实系统很少只用一种。常见配方:主力用向量索引,全局总结类问题路由到摘要索引(3.5 节的 Router 就是干这个的);语料里有强关系结构时再加图谱索引兜"多跳"问题。先让 80% 的问题被向量索引接住,再为剩下的 20% 引入重型武器——顺序反了就是过度工程。
💡 关键直觉:选索引就像给图书馆选排架法——按主题排(向量)、按目录排(摘要)、按层级排(树)、按关联排(图谱),取决于读者怎么找书,而不是哪种更新颖。
本节要点回顾
- 索引 = 查询方式的预判:找条款用向量、写总结用摘要、先粗后细用树、查关系用图谱。
- 实验验证直觉:两类问题在两种索引上的表现差异,亲手跑一遍胜过背十遍结论。
- 成本阶梯:向量最低,摘要次之,树与图谱都要在建库期消耗 LLM 调用。
- 组合配方:向量索引打底 + 按问题形态路由补强,是生产系统的主流形态。
- 反过度工程:先让主流问题被便宜方案接住,再为长尾问题上重型索引。
常见问题
一个索引能装多少节点? 向量索引的天花板主要取决于向量库:内存型存储在百万级节点内都很从容,外接专业向量库可以到亿级。但注意"能装"与"该装"是两回事——数据域混杂的巨型索引检索精度会下滑,3.5 节的拆分与路由往往是比扩容更好的答案。
树索引值得用吗? 它的价值集中在"单篇超长文档的层级理解"场景(整本手册、长研报)。建造期要逐层调 LLM 摘要,成本高;如果语料是几千篇独立短文档,摘要索引加路由通常更划算。先确认你的问题形态真的是"先粗后细",再为树索引付费。
图谱索引的三元组抽取质量不行怎么办? 通用抽取器在领域语料上确实容易抽出行话错乱的三元组。改进路径:给抽取提示词补充领域实体表与关系类型白名单;或者放弃自动抽取,从已有的结构化数据(数据库外键、组织架构表)直接导入关系——半结构化来源建图往往比纯文本抽取可靠得多。
还有一个介于向量与图谱之间的实用模式值得知道:把结构化关系"折叠"进元数据,而不是真的建图谱。比如把"审批人职位"作为工单节点的元数据字段,多跳问题里的第一跳就能用元数据过滤直接命中,成本远低于图索引。当关系类型只有两三种且模式固定时,元数据折叠是性价比之王;关系类型开放多变时才需要真正的图谱。先问"我的关系能不能塞进字段",再考虑建图。
行动项同样具体:用你第 2 章切好的语料,把向量与摘要两种索引各跑五个典型问题,记录答案质量的主观差异。这个二十分钟的对比会给出比任何教程都诚实的结论——你的语料会告诉你它需要什么。