3.3 向量数据库集成
3.3 向量数据库集成
本节摘要:数据规模超出内存或需要多进程共享索引时,就要把向量存进专业向量数据库。本节讲清"什么时候必须上向量库"的判断标准,对比 Chroma / Milvus / Qdrant / pgvector 四条路线,并以 Chroma 为例完成从建库、接入 LlamaIndex 到查询验证的完整闭环。
什么时候必须上向量库
内置默认存储(SimpleVectorStore)把向量放内存,三个信号提示该升级了:一是数据量——几十万节点级别,内存与启动时间都吃紧;二是进程模型——Web 服务多进程部署,每个进程各自加载一份内存索引既慢又容易不一致;三是运维需求——要权限控制、要备份、要与现有基础设施(如已有的 PostgreSQL)合并管理。都没命中就先别上,简单是第一生产力。
四条路线对比
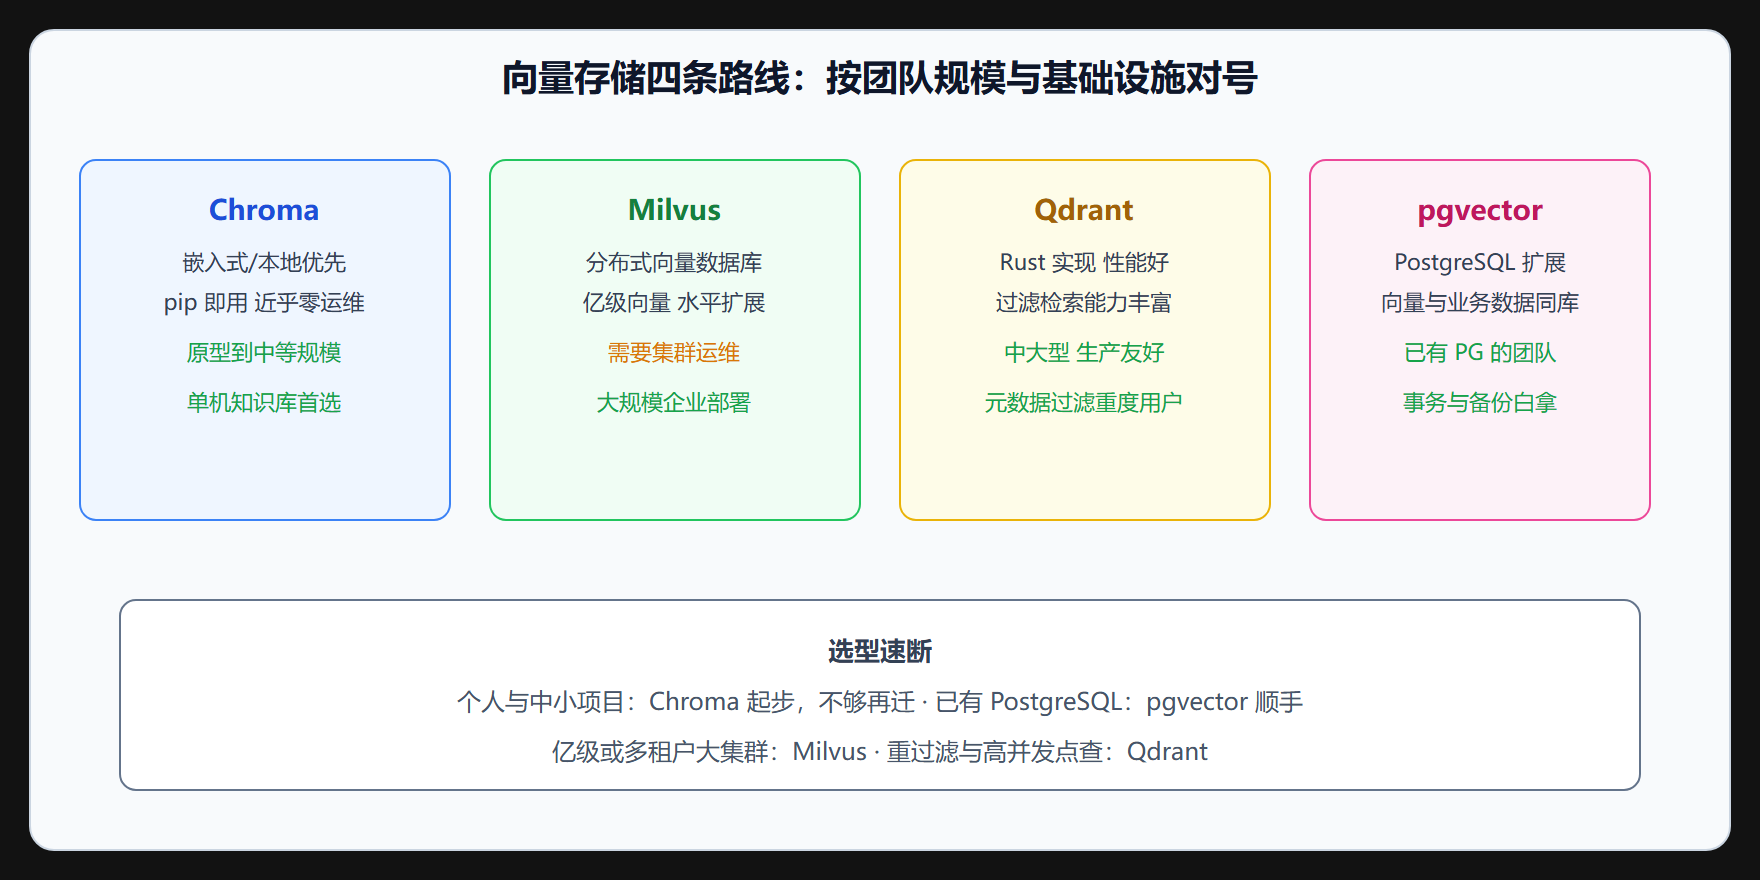
Chroma 接入完整闭环
# 第一步:创建持久化向量库并包装为 LlamaIndex 的 VectorStore import chromadb from llama_index.core import VectorStoreIndex, StorageContext from llama_index.vector_stores.chroma import ChromaVectorStore from llama_index.core import SimpleDirectoryReader db = chromadb.PersistentClient(path="./chroma_db") collection = db.get_or_create_collection( "company_kb", metadata={"hnsw:space": "cosine"}, # 显式指定余弦距离 ) vector_store = ChromaVectorStore(chroma_collection=collection) storage_context = StorageContext.from_defaults(vector_store=vector_store) # 第二步:建索引直接写入向量库(而非内存) docs = SimpleDirectoryReader("./data").load_data() index = VectorStoreIndex.from_documents( docs, storage_context=storage_context, show_progress=True) # 第三步:另一个进程里重建索引对象 —— 不需要再嵌入任何东西 index2 = VectorStoreIndex.from_vector_store(vector_store) engine = index2.as_query_engine(similarity_top_k=5) print(engine.query("年假可以拆分使用吗?"))
第三步是向量库的核心价值所在:from_vector_store 秒级返回可查询的索引,嵌入的成本只付一次。
过滤检索:向量库的另一半能力
第 2 章埋的元数据伏笔在这里兑现。业务上大量查询天然带范围:"只查 2024 年的制度""只查华东区的工单":
from llama_index.core.vector_stores import ( MetadataFilters, ExactMatchFilter, MetadataMode) filters = MetadataFilters(filters=[ ExactMatchFilter(key="dept", value="finance"), ExactMatchFilter(key="year", value="2024"), ]) engine = index2.as_query_engine(filters=filters, similarity_top_k=5)
不同向量库的过滤实现性能差异很大(有的在索引后过滤、有的支持索引内过滤),重过滤场景选型时要把这项列入压测项,而不是只看纯向量检索的 QPS。
⚠️ 常见坑:Chroma 默认距离是平方欧氏距离而非余弦。若你的相似度阈值(
retrieval_similarity_top_k之外的 score 阈值)是按余弦调的,建库时务必显式指定距离度量,否则分数含义完全不同,阈值调到天荒地老也不对。
本节要点回顾
- 三个升级信号:数据量、多进程共享、运维需求;未命中先保持默认存储。
- 四条路线:Chroma 快起步、Milvus 大集群、Qdrant 重过滤、pgvector 顺路白拿。
- 核心价值:
from_vector_store让嵌入成本只付一次,进程间共享索引。 - 过滤检索:元数据过滤是业务高频能力,选型时压测"带过滤的检索"而非裸检索。
- 距离度量:建库时显式指定余弦,别让默认值偷换分数含义。
常见问题
先选向量库还是先选嵌入模型? 先嵌入模型。向量维度与度量方式由嵌入模型决定,向量库只是被动适配的一方。换嵌入模型要全量重建,换向量库只需要迁移数据——前者的决策权重远高于后者。
多个集合(collection)怎么组织? 常见两种:按业务域分集合(制度库、工单库各自独立,配 3.5 节路由),或单集合靠元数据分区(软分区,配过滤检索)。数据量与权限差异决定选择:域之间权限不同就物理分集合,查询常跨域就软分区。别两者混用一半一半,运维会疯。
上线后发现距离度量选错了,怎么办? 只能全量重建,没有热切换的办法。这就是本节反复强调"建库时显式指定度量"的原因——这是最便宜的预防。重建时把 3.4 节的版本化流程走一遍,顺便把灰度切换也演练了。
容量规划给出粗略参考:一百万个 768 维向量,纯向量数据约三个吉字节,加上索引结构与元数据翻倍估算。嵌入式方案(Chroma 单机)在千万级向量内可用但检索延迟开始爬升;再往上走分布式方案。别过度设计——多数企业知识库在百万节点以内,单机加持久化就能稳定服役很久,等真实数据逼近容量再迁移,迁移成本在第 3.4 节的版本化流程下完全可控。