4.3 查询转换与优化
4.3 查询转换与优化
本节摘要:检索失配的另一半根源在问题端——用户的问题和文档的表述天然错位。查询转换站在检索之前改造问题:HyDE 让模型先写假设答案再用它检索,子问题分解拆开复合问题,多查询扩展生成多个改写。本节实测三种转换的增益场景与代价,并提醒一个反直觉事实:转换不是万能药,用错场景会负优化。
问题端的三种失配
一是表述失配:用户问"机器坏了能保修多久",文档写"XR-2000 系列售后维修服务条款"——问句像"问题描述",文档像"标题",向量距离远。二是复合失配:用户问"A 和 B 两个方案哪个报销额度高",正确答案分散在两个节点,单次检索两头不靠。三是指代失配:聊天里的"它呢""那第二种呢",离开上下文没法检索。三种失配对应三种解法。
HyDE:先编一个答案,再拿它去搜
HyDE(Hypothetical Document Embeddings)的思路反直觉但有效:假设答案与真实答案的文本形态相似(都是陈述句、都用术语),比"问题形态"更接近文档。让 LLM 先凭常识编一个假设答案,用假设答案的向量去检索:
from llama_index.core.indices.query.query_transform import HyDEQueryTransform from llama_index.core.query_engine import TransformQueryEngine hyde = HyDEQueryTransform(llm=Settings.llm, include_original=True) hyde_engine = TransformQueryEngine(base_engine, hyde) resp = hyde_engine.query("机器坏了能保修多久?") # 内部流程:LLM 生成假设性保修条款 → 用它检索 → 召回的正是真实条款
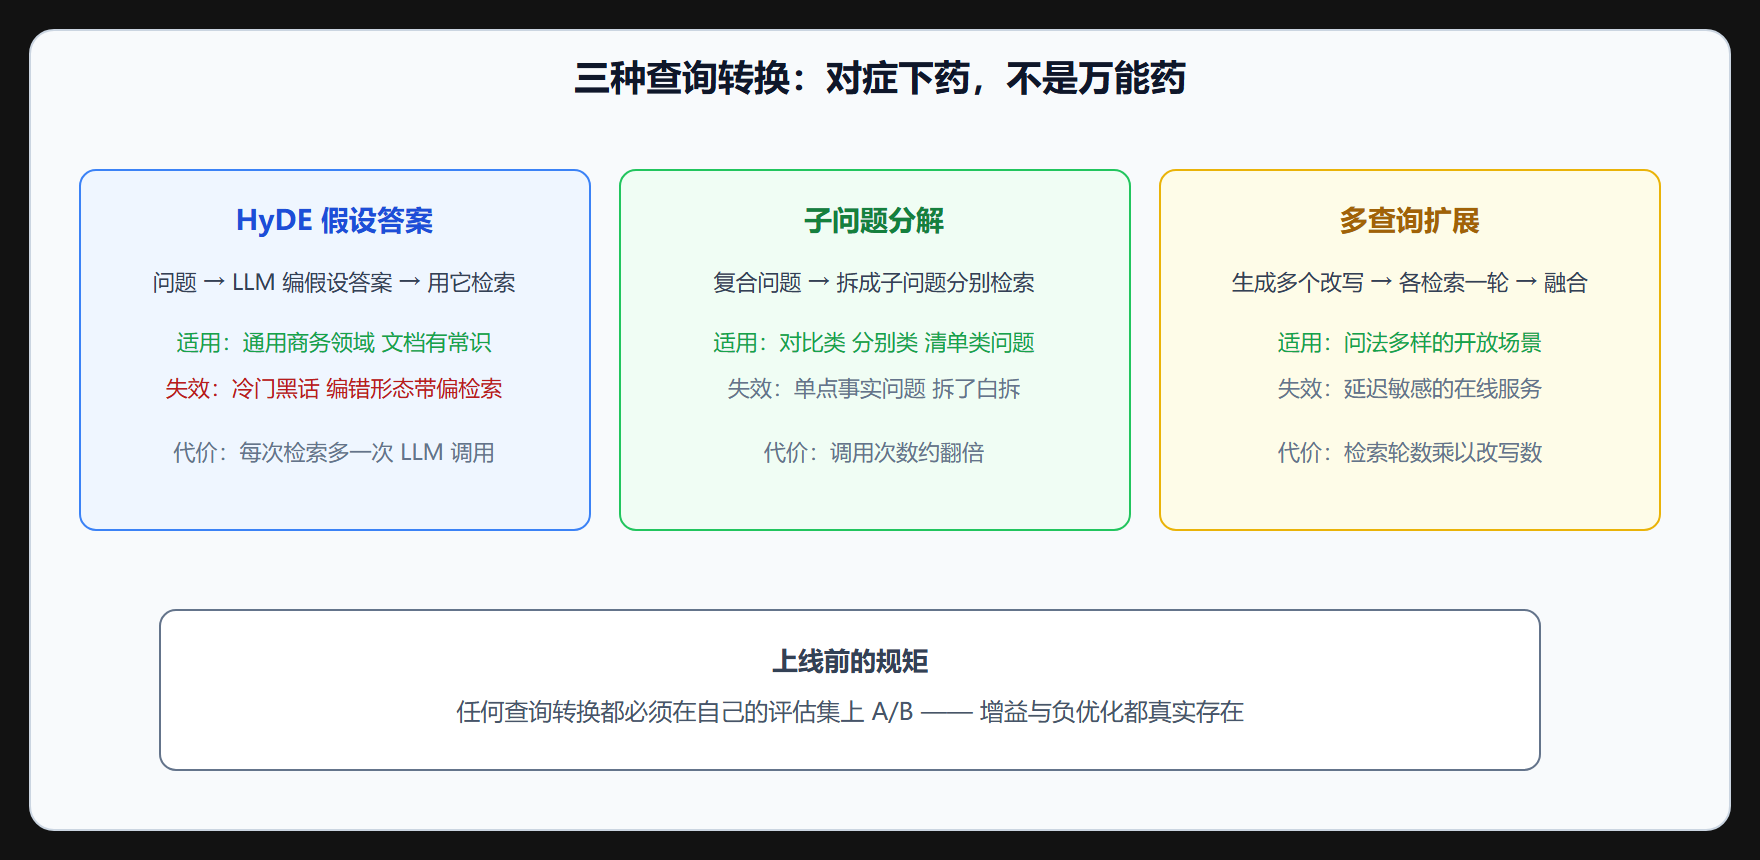
HyDE 的适用边界要记牢:文档语料是"模型有常识的领域"(保修、请假、报销这类通用商务文本)时,假设答案形态猜得准,增益明显;冷门领域(内部黑话、专有型号)模型编出来的假设答案可能形态全错,反而把检索带偏。上 HyDE 前先在自己的评估集上 A/B 一次。
子问题分解:把复合问题拆开
from llama_index.core.query_engine import SubQuestionQueryEngine from llama_index.core.tools import QueryEngineTool, ToolMetadata tools = [QueryEngineTool(query_engine=base_engine, metadata=ToolMetadata(name="policy", description="公司制度问答"))] sub_engine = SubQuestionQueryEngine.from_defaults(query_engine_tools=tools) # "差旅和餐补的报销上限分别是多少" 会被拆成两个独立子问题分别检索 print(sub_engine.query("差旅住宿和餐补的报销上限分别是多少?")) # 输出结构:子问题1答案 + 子问题2答案 + 汇总
分解的代价是 LLM 调用次数翻倍(拆一次 + 合一次),它换来的是每个子问题都能命中自己的最佳节点。对比类、清单类问题("分别""各有哪些""哪个更")是它的主场。
多查询扩展:不猜哪个改写最好,全试一遍
from llama_index.core.retrievers import QueryFusionRetriever fusion = QueryFusionRetriever( [index.as_retriever(similarity_top_k=5)], similarity_top_k=6, num_queries=4, # 原问题 + 3 个 LLM 改写,各召回一轮再融合 mode="reciprocal_rerank_fusion", ) nodes = fusion.retrieve("年假拆分规则")
num_queries=4 意味着一次检索变成四次(外加一次 LLM 改写调用),换取的是对"问法随机性"的鲁棒性——某个改写恰好贴近文档表述就能捞回来。适合离线分析与对延迟不敏感的场景。
与聊天引擎的衔接
指代失配不用手动处理:聊天引擎的 condense_question 模式内建了"历史 + 追问 → 完整独立问题"的改写(1.5 节见过)。知道这个机制存在,就不会在查询引擎外面自己再糊一层指代消解。
本节要点回顾
- 三种失配对三种解法:表述失配用 HyDE、复合失配用子问题分解、问法随机用多查询扩展、指代失配交给聊天引擎。
- HyDE 有边界:模型有常识的领域增益、冷门领域负优化,务必 A/B。
- 分解有代价:LLM 调用翻倍,只对复合问题划算。
- 多查询换鲁棒:延迟不敏感场景的保险策略。
- 先归因再上转换:用 4.1 节的 source_nodes 三分法确认失配真在问题端,再动这里的手术。
常见问题
HyDE 生成的假设答案会污染最终回答吗? 默认实现里假设答案只用于检索,不进入合成上下文,所以"编错内容"只影响召回不影响作答。但自定义实现时要小心别把假设答案当上下文传给合成器——那等于让模型引用自己编的材料。
查询转换和重排器,先上哪个? 先归因(4.1 节三分法):正确内容不在候选集里,是召回问题,查转换可能有效;在但排序差,重排器直接对症。两个一起上会让归因变混乱——一次只动一个变量,评估集看效果,这是全册反复强调的纪律。
多查询扩展会增加多少延迟? 线性:四次改写约等于四次检索加一次生成改写的延迟。对在线服务通常不可接受,除非改写与多路检索全部并发执行——并发化之后延迟只增加一轮左右,值得工程投入。
最后一个提醒:查询转换的效果与语料的"表述风格分布"强相关。用户群体与技术文档表述差异大的系统(客服场景),转换收益显著;用户本来就是专业人士、提问术语与文档一致(内部研发知识库),转换常常无增益。上线前统计一批真实问题与文档的表述相似度,能提前预判转换值不值得投入,省下一轮试错。