4.4 响应合成器与 LLM 交互
4.4 响应合成器与 LLM 交互
本节摘要:合成器决定召回的节点如何进入提示词、模型如何被调用。四种 response_mode(refine / compact / tree_summarize / no_text)在 token 成本、答案连贯性、上下文超窗处理上各有取舍。本节用一批超长召回做对照实验,给出选型规则,并展示自定义提示模板这个"最后一公里"的改装点。
四种模式各是怎么花 token 的
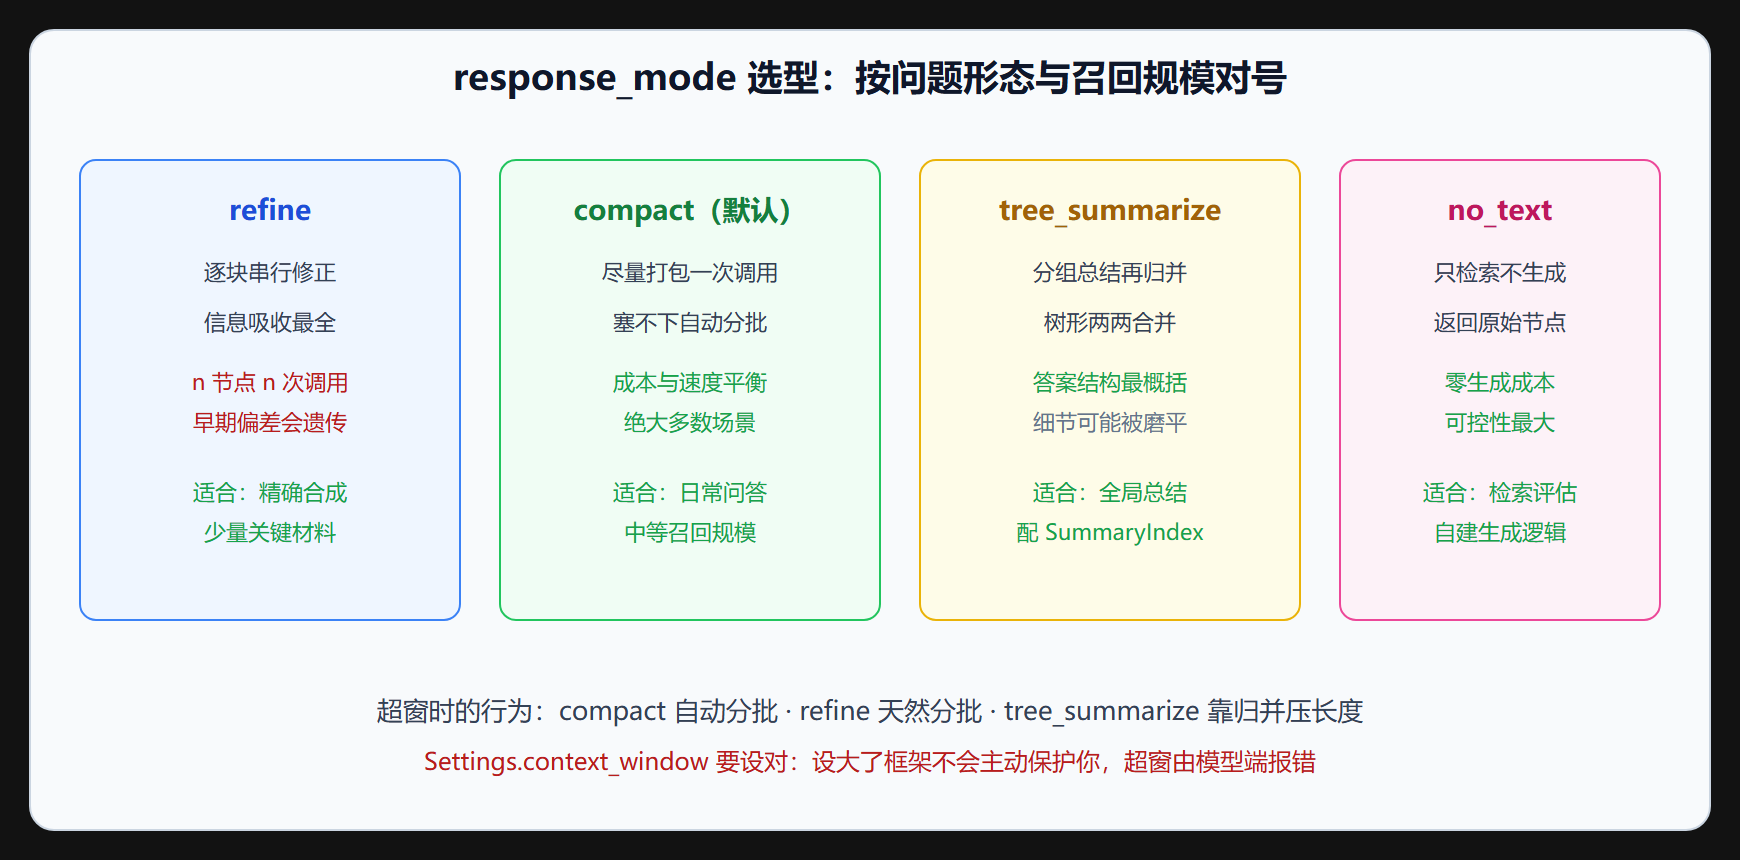
refine:逐个节点串行喂模型,每次"根据新材料修正前一次答案"。答案能吸收全部信息,但 n 个节点 = n 次模型调用,慢且贵,且早期偏差可能一路遗传。
compact(默认):尽量把节点打包进一次提示词,塞不下再分批 refine。多数场景的最佳平衡。
tree_summarize:把节点分组各自总结,再总结总结(树形归并)。适合"全局概括"类任务,与 SummaryIndex 是天作之合(3.2 节)。
no_text:只检索不生成,返回原始节点。评估检索质量(第 6 章)和自建生成逻辑时用它。
from llama_index.core import get_response_synthesizer for mode in ("refine", "compact", "tree_summarize"): synth = get_response_synthesizer(response_mode=mode) engine = index.as_query_engine( response_synthesizer=synth, similarity_top_k=12) # 故意放大召回 resp = engine.query("总结报销制度的关键变化") print(mode, "答案长度:", len(resp.response))
召回 12 个长节点时,compact 会自动分批打包;refine 跑得明显更久(12 次调用);tree_summarize 产出的答案结构最"总结化"。配合 1.4 节的回调打点,你能直接看到各模式的 LLM 调用次数差异——眼见为实。
选型规则与超窗行为
流式输出与自定义模板
面向用户的系统,流式输出几乎是必选项;而提示模板是控制答案风格(带出处、限长度、拒答规则)的最后一公里:
from llama_index.core import PromptTemplate # 自定义问答模板:约束"必须引用出处、无依据则拒答" qa_tpl = PromptTemplate( "上下文信息如下:\n" "---------------------\n{context_str}\n---------------------\n" "请仅依据上下文回答:{query_str}\n" "要求:1)答案末尾标注依据的文件名;2)上下文无依据时回答"根据现有资料无法回答"。" ) engine = index.as_query_engine(text_qa_template=qa_tpl) # 流式输出 resp = engine.query("年假可以拆分吗?") if hasattr(resp, "response_gen"): # streaming=True 时 for token in resp.response_gen: print(token, end="")
⚠️ 常见坑:refine 模式配弱模型时,"修正链"容易越修越啰嗦甚至越修越偏——第一轮答偏,后面每轮都在为偏差打补丁。弱模型 + 需要精确引用的场景,用 compact + 好模板比 refine 更稳。
本节要点回顾
- 四模式分工:compact 默认、tree_summarize 管概括、refine 管全量精修但要慎用、no_text 管评估与自建。
- 超窗三策略:分批打包、串行分批、树形归并,各有成本曲线。
- 模板是最后一公里:出处标注与拒答规则写进模板,比事后处理答案可靠。
- 流式默认开:面向用户的服务没有理由不流式。
- 弱模型避 refine:修正链会放大早期偏差,compact 加模板更稳。
常见问题
答案总是很啰嗦,在哪控制? 三处:提示模板里写明"简洁回答,不超过三句话";response_mode 换 compact 减少多轮 refine 的累积啰嗦;top_k 收紧减少模型要消化的材料。模板约束是第一优先级,它直接塑造输出风格且零成本。
流式输出和 refine 模式兼容吗? 效果不好:refine 的每一轮都是"重新生成完整答案",流式体验会退化成反复重写。需要流式的场景选 compact 模式,一次调用天然适合流式输出。这也是生产系统很少用 refine 的现实原因之一。
怎么让模型在没把握时明确说不知道? 模板里给"无依据时回答无法确认"的显式许可,外加相似度截断(低分节点直接过滤,让"没有材料"成为真实可能)。模型天生倾向给答案,不给它拒答的许可与拒答的条件,它就会硬答。
关于合成质量还有一个常被忽略的杠杆:节点在上下文里的排列顺序。默认按相似度降序排,但多数模型对上下文的开头与结尾利用率高于中段。把得分最高的节点放开头与结尾、中等的放中间,有时能白捡一点准确率——这类"排列技巧"零成本,值得一试并在评估集上验证。
流式与并发的组合也值得规划:合成是最长的一段等待,流式只改善体感不改善吞吐;吞吐瓶颈靠并发请求与模型服务的并行配额解决。两者配合,单机服务的实际承载能力比同步串行模式高出数倍,这是 6.4 节部署架构的量化基础。
最后给一个容易被忽略的观测项:答案长度分布。突然变长的答案常预示着召回内容变多或模板被改坏;突然变短则可能是截断或材料不足。把"平均答案长度"加入日常监控,配合延迟与命中率一起看,合成层的很多问题能在用户投诉之前就被发现。
合成层的最后一条经验:改动合成配置后,除了看命中率与答案质量,也要抽查两三个"材料互相矛盾"的问题(新旧制度并存)——合成器处理冲突的方式最能暴露配置问题,而这类问题在常规指标里完全隐形。