4.5 高级查询模式:多跳、递归与子问题引擎
4.5 高级查询模式:多跳、递归与子问题引擎
本节摘要:有些问题的答案不在任何单个节点里,而藏在"先查 A、再用 A 的结果去查 B"的链路上。本节解剖三类高级模式:SubQuestion 引擎的规划-执行-汇总结构、多跳递归查询的"以答案为钥匙开下一扇门",以及它们与知识图谱索引(3.2 节)在关系型问题上的分工,最后讨论成本控制。
什么是多跳问题
单跳问题:"P8 的住宿上限是多少"——一次检索搞定。多跳问题:"负责审批 P8 差旅报销的那位领导,他自己报销要谁审批?"——第一步检索"P8 审批人"得到职位(比如"财务总监"),第二步要用"财务总监 报销审批"再检索一次。中间结果是下一步的钥匙,这是向量检索"一次定生死"模式天然处理不了的形态。
SubQuestion 引擎:规划、执行、汇总
from llama_index.core.query_engine import SubQuestionQueryEngine from llama_index.core.tools import QueryEngineTool, ToolMetadata tools = [ QueryEngineTool(query_engine=policy_engine, metadata=ToolMetadata(name="policy", description="公司制度:报销、审批、休假条款")), QueryEngineTool(query_engine=org_engine, metadata=ToolMetadata(name="org", description="组织架构:汇报线、负责人信息")), ] sq = SubQuestionQueryEngine.from_defaults(query_engine_tools=tools, verbose=True) print(sq.query("负责审批 P8 差旅的领导自己报销找谁?")) # verbose 输出会显示它规划的子问题: # 子问题1(policy):P8 差旅报销的审批人是什么职位? # 子问题2(org):该职位的报销审批上级是谁?
注意它实际是"LLM 规划出子问题列表、逐个查询、最后汇总"——规划质量取决于工具描述与模型能力。这里的每个子问题仍是单跳,所谓多跳被拆解为"多次单跳 + 中间结果传递"。
真·多跳:递归查询引擎
当需要"把上一步答案塞进下一步问题"的紧耦合链条时,用递归引擎自己写传递逻辑:
from llama_index.core.query_engine import ( BaseQueryEngine, RetrieverQueryEngine) from llama_index.core import PromptTemplate class TwoHopQueryEngine: """手写两跳:第一跳的答案构造成第二跳的查询""" def __init__(self, engine: RetrieverQueryEngine, hop2_tpl: PromptTemplate): self.engine, self.tpl = engine, hop2_tpl def query(self, question: str): step1 = self.engine.query(question) # 第一跳 key = step1.response.strip() # 提取钥匙 q2 = self.tpl.format(key=key) # 钥匙开下一扇门 step2 = self.engine.query(q2) # 第二跳 return f"第一跳结论:{key}\n第二跳结论:{step2.response}" two_hop = TwoHopQueryEngine( base_engine, PromptTemplate("{key} 的报销审批上级是谁"), ) print(two_hop.query("P8 差旅报销的审批人是什么职位?"))
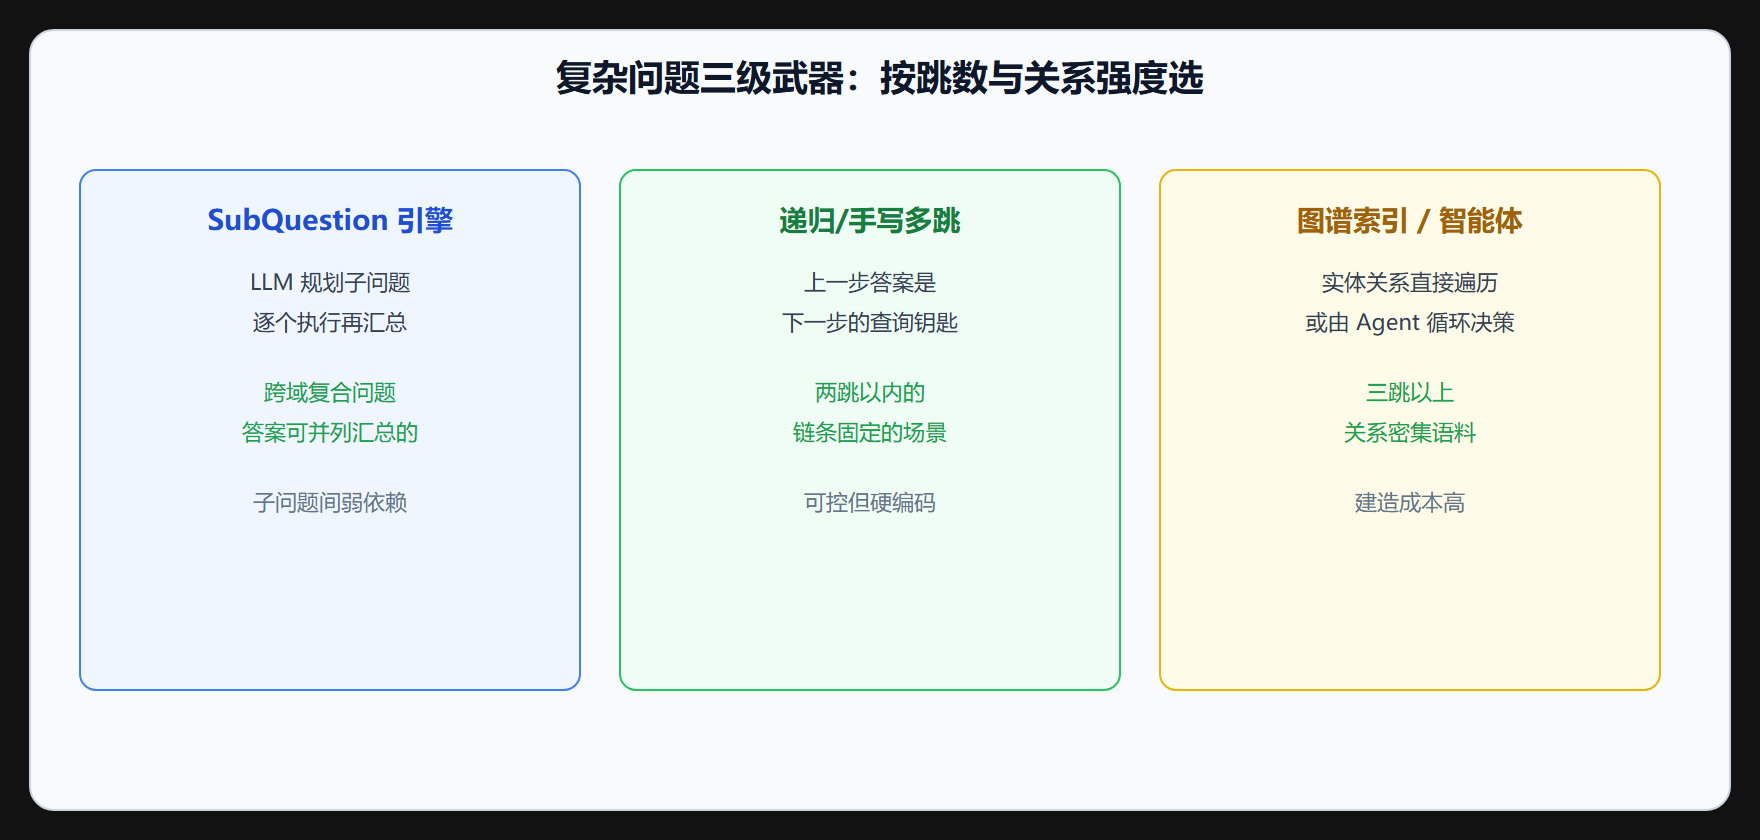
两跳手写可控;三跳以上建议直接考虑图谱索引或第 5 章的智能体——让模型在循环里自己决定"下一步查什么",比硬编码链条灵活得多。
成本与深度的控制
多跳类模式的账单特征是"乘法":每跳一次检索加一次生成,SubQuestion 的子问题数乘以每题成本,智能体的循环步数更不可预测。两个控制阀:给引擎设最大深度/最大子问题数;用便宜模型做规划、贵模型只做最终汇总——规划任务对模型能力的要求远低于合成任务,混部是省钱的常规操作。
本节要点回顾
- 多跳定义:中间结果是下一步的钥匙,单次检索结构性处理不了。
- SubQuestion 结构:规划-执行-汇总,子问题各自单跳,规划质量靠工具描述。
- 手写两跳模板:紧耦合链条自己写传递,可控性最高;三跳以上交给图谱或智能体。
- 三级武器分工:弱依赖复合 → SubQuestion;固定两跳 → 递归;深度关系 → 图谱/Agent。
- 成本乘法:设深度上限、规划用便宜模型,是多跳模式的标配省钱阀。
常见问题
怎么判断我的问题集里有多少多跳问题? 抽样标注:取一百条真实用户问题,人工标"单跳/多跳/非检索"。比例决定投入——多跳占比一成以下,SubQuestion 引擎按需调用即可;占比三成以上,认真做 3.2 节的图谱索引或第 5 章智能体,值得为它建重型设施。
多跳链路中间答错了,后面全错,怎么缓解? 这是级联错误的固有风险。缓解手段:每跳的中间答案配来源节点(可验证);关键跳用更强的模型;链路设计时让"验证步"参与——第二跳检索前先确认第一跳答案有出处支撑。完全消除不可能,工程目标是让级联失败可被观测与追溯。
SubQuestion 和 Workflow 各适合什么场景? SubQuestion 是"开箱即用的分解器",适合标准复合问题;Workflow 是"自定义流程编排",适合分解逻辑本身有业务规则的场景(比如必须先查内部库再查外部库的合规顺序)。前者快,后者可控,复杂系统常常两者并存。
补充一个判断信号:如果评估集里多跳问题的失败模式高度一致(比如总是第二跳检索偏),优先修那一跳的检索配置而不是换更复杂的框架设施——多数"多跳失败"其实是某一跳的普通检索失败。多跳链路的健壮性等于最弱一跳的健壮性,链式改进的顺序是先逐跳测试再整体联调。