5.3 多模态 RAG:让图文混排文档进索引
5.3 多模态 RAG:让图文混排文档进索引
本节摘要:大量真实知识以"图 + 文"混排存在(产品手册的架构图、财务报告的图表)。多模态 RAG 的两条主流路线:图文分离(文本走文本嵌入、图像走多模态嵌入、出处互相指认)与统一向量空间(同一模型把文本与图像投到同一空间直接互检)。本节实现"文搜图、图搜文"的完整闭环,并讨论成本与工程取舍。
问题:图里的知识检索不到
文字版 RAG 对"2019 年与 2023 年的营收对比柱状图"无能为力——图没有被翻译成可检索的表示。用户问"营收趋势如何",正确答案恰恰在那张图里。多模态 RAG 的目标:图能被文字问题搜到,图也能参与答案合成。
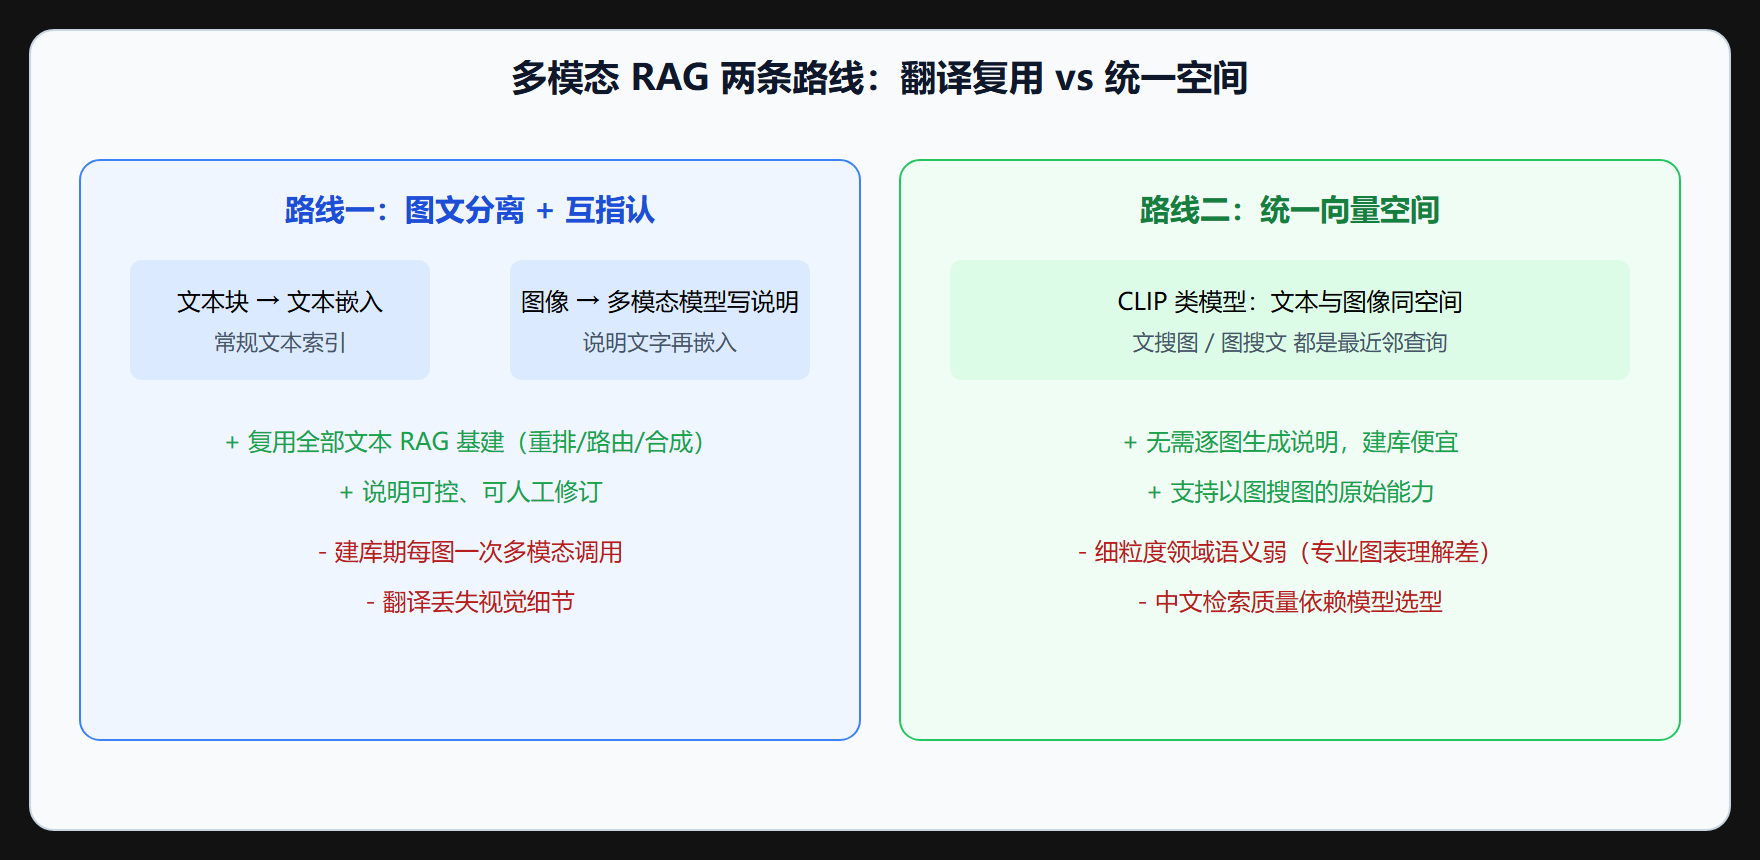
路线一:图文分离 + 互指认
每个文档页面解析出"文本块 + 图像块"两类节点,分别嵌入,元数据里互相记录出处。检索时两路并行:
from llama_index.core import VectorStoreIndex, Document from llama_index.core.schema import ImageDocument from llama_index.multi_modal_llms.openai import OpenAIMultiModal # ① 文本侧:常规切块入索引(第2章流水线) text_nodes = SentenceSplitter(chunk_size=512).get_nodes_from_documents( [Document(text=page_text, metadata={"page": i, "doc": "annual_report"}) for i, page_text in enumerate(pages)]) # ② 图像侧:图像描述生成 —— 用多模态模型给每张图写"可检索的文字说明" mllm = OpenAIMultiModal(model="gpt-4o-mini", max_new_tokens=300) for img in extracted_images: caption = mllm.complete( prompt="用两三句话客观描述这张图表的关键信息与数字," "不要猜测图外信息。", image_documents=[ImageDocument(image_path=img.path)]).text img.text_node.metadata["image_caption"] = caption # 图像的向量 = 对 caption 做文本嵌入;caption 让图"可被文字搜到"
这条路线的本质是用多模态模型把图翻译成文字,再复用整套文本 RAG 基建——第 2、3、4 章的所有优化(重排、路由、合成)原样适用。代价是建库期每张图一次多模态调用,以及翻译过程可能丢失细节(颜色、精确刻度)。
路线二:统一向量空间
用 CLIP 类多模态嵌入模型,把图像与文本投进同一向量空间,"文搜图"变成直接的最近邻查询:
from llama_index.core.indices.multi_modal.base import MultiModalVectorStoreIndex # 图像与文本各自嵌入,但存进同一索引,检索时跨模态匹配 mm_index = MultiModalVectorStoreIndex.from_documents( documents_with_images, # 含 ImageDocument 与 TextNode image_embed_model=clip_embed, # 图像嵌入模型 text_embed_model=Settings.embed_model, ) retriever = mm_index.as_retriever(similarity_top_k=3) result = retriever.retrieve("营收增长趋势的图表") # 命中的可能是 ImageNode —— 出处直接指向那张图
答案合成:图要真的被"看见"
检索到图还不够,合成阶段让多模态模型直接看图作答(而不是只看 caption),是准确率的关键一步:
# 合成阶段:把检索到的图像节点连同文本一起交给多模态模型 answer = mllm.complete( prompt=f"问题:{question}\n请结合以下文字材料与图片作答:\n{text_context}", image_documents=[ImageDocument(image_path=best_img.path)]).text
这样"图里的数字"由模型直接读图得出,caption 只负责帮检索命中——检索用翻译,生成用原图,各取所长。
工程取舍
图像嵌入与多模态生成的成本都显著高于纯文本,落地策略是分层:先问业务"图承载了多少答案"——产品图册、财报图表值得上多模态;纯装饰性截图直接过滤掉(摄取阶段按尺寸/占比过滤,别让它们污染索引)。其次图数多时优先路线一(说明可控、可缓存),检索体验要求"以图搜图"才上路线二。
⚠️ 常见坑:扫描版 PDF 整页当"一张图"入索引,一页几十个话题挤一个向量,检索粒度灾难。先做版面分析切出子图,再按子图建节点。
本节要点回顾
- 两条路线:图文分离靠多模态模型翻译成文字(复用文本基建),统一空间靠 CLIP 类模型跨模态互检。
- 检索用翻译、生成用原图:caption 管命中,多模态合成管读图,各司其职。
- 分层落地:先评估图的答案占比,装饰图摄取期过滤,别为不承载知识的图付多模态成本。
- 粒度警告:整页扫描图当单节点是检索灾难,版面分析切子图再入索引。
常见问题
多模态嵌入模型对中文图表效果如何? 通用 CLIP 类模型对中文文本的理解与专业图表的细粒度语义都偏弱,纯中文场景更依赖路线一(翻译成中文说明再用中文嵌入模型)。选型时用"文字问题能否命中目标图"做评估,与 3.1 节的嵌入评估一脉相承。
图表里的精确数字读不准怎么办? 多模态模型读图的数值精度有限,高精度需求下补充结构化路径:建库期把关键表格导出成结构化数据存表,问题涉及精确数字时走表格查询工具(第 5 章的 FunctionTool)而不是靠模型读图。图给趋势,表给精确值,各司其职。
视频数据能进 RAG 吗? 思路相同粒度不同:先抽关键帧(按场景切换或固定间隔),关键帧当图像走多模态管道,音轨转文字走文本管道。成本高得多,务必先确认视频承载的知识占比值得这份投入。