5.4 可观测性与调试:看见链路内部
5.4 可观测性与调试:看见链路内部
本节摘要:RAG 系统的错误藏得很深——答案错了,但错在摄取、检索、重排还是合成?可观测性给你 X 光机:回调系统看执行轨迹,结构化输出看每步中间产物,评估框架量化质量趋势。本节把"调试三板斧"配齐,并建立一个可长期跟踪的评估集。
第一斧:执行轨迹(发生了什么)
1.4 节用过的回调系统是轨迹层的核心。生产环境的用法不是打印,而是接入观测服务(如 Arize Phoenix 等支持 OpenTelemetry 标准的工具):
# 把 LlamaIndex 的事件流接到 OpenInference 标准的观测后端 import llama_index.core llama_index.core.set_global_handler("arize_phoenix") # 此后每次查询的 检索事件/LLM事件/嵌入事件 都会带完整载荷上报: # 哪个查询、召回哪些节点、各得多少分、提示词原文、模型返回、耗时 resp = engine.query("报销审批流程") # 在观测面板上按 trace 查看:这条查询走了哪些站、每站花了多少
没有观测面板时,退化为本地结构化日志同样有效:把每次查询的 source_nodes(含分数)、最终提示词长度、耗时写进日志文件。关键是每次查询都留下"模型看到了什么"——事后归因全靠它。
第二斧:中间产物(东西长什么样)
轨迹告诉你"调用了检索",中间产物告诉你"检索返回的具体内容"。三个最高频的检查点:
# 检查点1:嵌入前后的文本(元数据是否泄漏进提示词) node = nodes[0] print(node.get_content(metadata_mode=MetadataMode.LLM)) # 模型实际看到的 print(node.get_content(metadata_mode=MetadataMode.EMBED)) # 嵌入实际吃的 # 检查点2:重排前后排序变化(重排器有没有起作用) before = [(n.node_id, round(n.score,3)) for n in retrieved] after = [(n.node_id, round(n.score,3)) for n in reranked] print("重排前:", before[:5], "\n重排后:", after[:5]) # 检查点3:最终提示词(合成器拼了什么) resp = engine.query("报销审批流程") print(engine.get_prompts()["response_synthesizer:text_qa_template"].template_vars if hasattr(engine, "get_prompts") else "见观测面板的 prompt 字段")
检查点 1 常抓到真 bug:MetadataMode 配置不当时,内部主键、无关元数据混进嵌入文本,悄悄污染相似度。
第三斧:评估集(趋势可量化)
# 一个最小的检索评估循环:命中率与 MRR eval_set = [ {"q": "报销审批流程", "gold": "提交申请后先经直属上级"}, {"q": "年假拆分规则", "gold": "最多可拆分为三次使用"}, # ... 30~50 条,覆盖主要问题形态与难度 ] def mrr(engine, eval_set): total = 0 for item in eval_set: nodes = engine.retrieve(item["q"]) if hasattr(engine, "retrieve") \ else engine.query(item["q"]).source_nodes rank = next((i+1 for i, n in enumerate(nodes) if item["gold"][:10] in n.text), 99) total += 1 / rank return total / len(eval_set) print("MRR:", round(mrr(retriever, eval_set), 3)) # 每次改配置后重跑
MRR(平均倒数排名)衡量"正确材料平均排第几"。这套三十行的脚本配上 git 里跟进的配置变更,就是最朴素也最有效的回归防线:任何改动(换嵌入模型、调 top_k、加重排)跑一遍,数字说话。
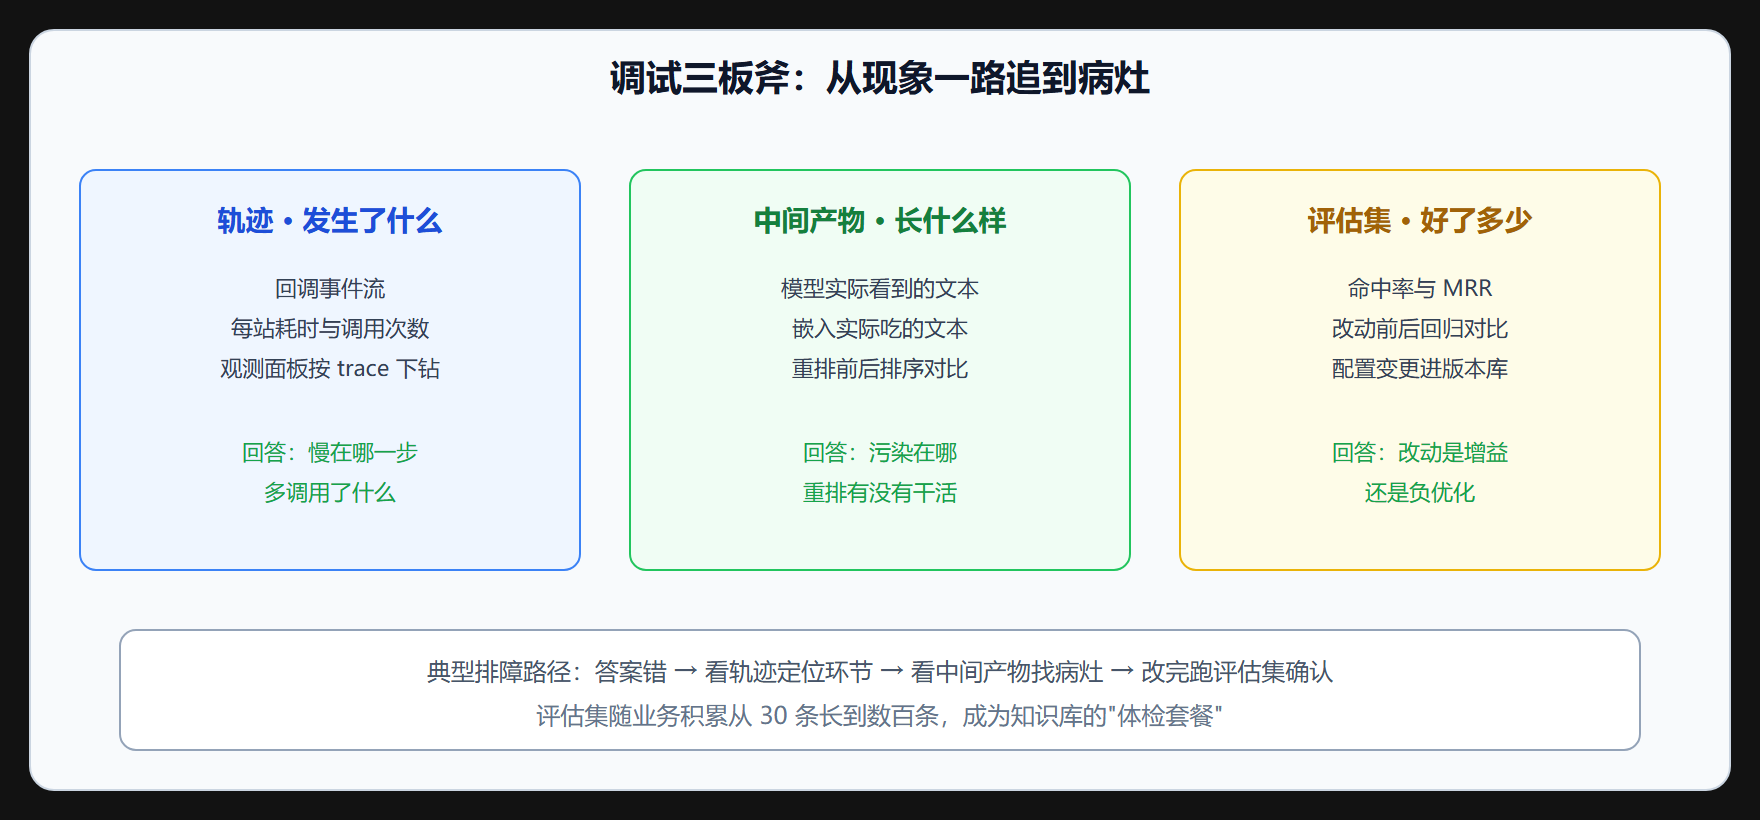
把排障变成流程
答案错误的标准化路径:看轨迹(哪段异常——检索次数、耗时、调用链)→ 看中间产物(source_nodes 有没有正确材料、提示词是否被污染)→ 修对应环节 → 评估集回归。这个流程与前几章的"三分法"(4.1 节)一脉相承,只是从一次性调试升级为可持续的观测体系。
本节要点回顾
- 三板斧:轨迹(发生了什么)、中间产物(长什么样)、评估集(好了多少)。
- 观测标准化:回调事件可上报 OpenTelemetry 系面板,本地退化为结构化日志。
- MetadataMode 检查:模型看到的与嵌入吃的文本要分开核查,元数据泄漏是隐形 bug。
- 三十行评估循环:命中率加 MRR,配版本化配置就是回归防线。
- 排障流程化:答案错 → 定位环节 → 找病灶 → 回归确认,不凭感觉改参数。
常见问题
观测数据太贵存不起怎么办? 分级存储:trace 全量采样但只保留七天;评估指标与错误案例长期保留;慢查询与低分查询的完整上下文单独归档。观测的价值集中在"异常与趋势",全量长期热存储是浪费。
评估集怎么维护不腐化? 三个习惯:线上真实问题按月抽样入库(覆盖新问题形态);每次发现"答错的典型案例"立刻入库(它是最有价值的负样本);定期清理过时问题(制度改版后旧问题的标准答案失效)。评估集是活文档,不是一次性交付物。
改动前后指标持平还要上线吗? 看次要指标:延迟、成本、答案长度。持平且无恶化就值得上(代码更简洁也是收益);持平但成本上升就要掂量。评估不是只有命中率一个维度,第 6 章会把完整的天平衡量框架展开。
关于生成质量评估再补一句:检索指标(命中率、MRR)客观可自动算,生成质量(答案对不对、全不全)则介于自动评估与人工之间。实用方案是双轨:小模型当裁判做全量粗评(给答案与标准出处,让它判断一致性),人工抽检做校准——裁判模型与人工的一致率达到八成后,自动评估就可以承担日常回归,人力只处理裁判标红的疑难样本。