6.1 性能瓶颈分析与优化策略
6.1 性能瓶颈分析与优化策略
本节摘要:RAG 延迟是四段之和——检索、重排、合成(排队 + 生成)、传输,其中合成段通常占大头。优化铁律是先归因再动刀:用观测数据列出延迟预算表,对最贵的一段下手。本节给出一套优化菜单(缓存、流式、模型分级、并行、提示词瘦身),标注各自的收益与代价。
先列延迟预算表
拿 5.4 节的轨迹数据,把一次查询的耗时分段。一个典型分布:检索 80ms、重排 200ms、合成排队 500ms、生成首 token 600ms、完整生成 2.5s。结论立刻清晰:大头在合成段,尤其是排队与生成。动刀前先知道肉在哪。
# 用回调事件统计各段耗时 from llama_index.core.callbacks import CallbackManager, LlamaDebugHandler handler = LlamaDebugHandler() Settings.callback_manager = CallbackManager([handler]) resp = engine.query("报销审批流程") for start, end in handler.get_event_pairs(): ms = (end.duration() or 0) * 1000 print(f"{start.payload.get('name', '?'):30s} {ms:7.1f} ms")
优化菜单:按收益排序
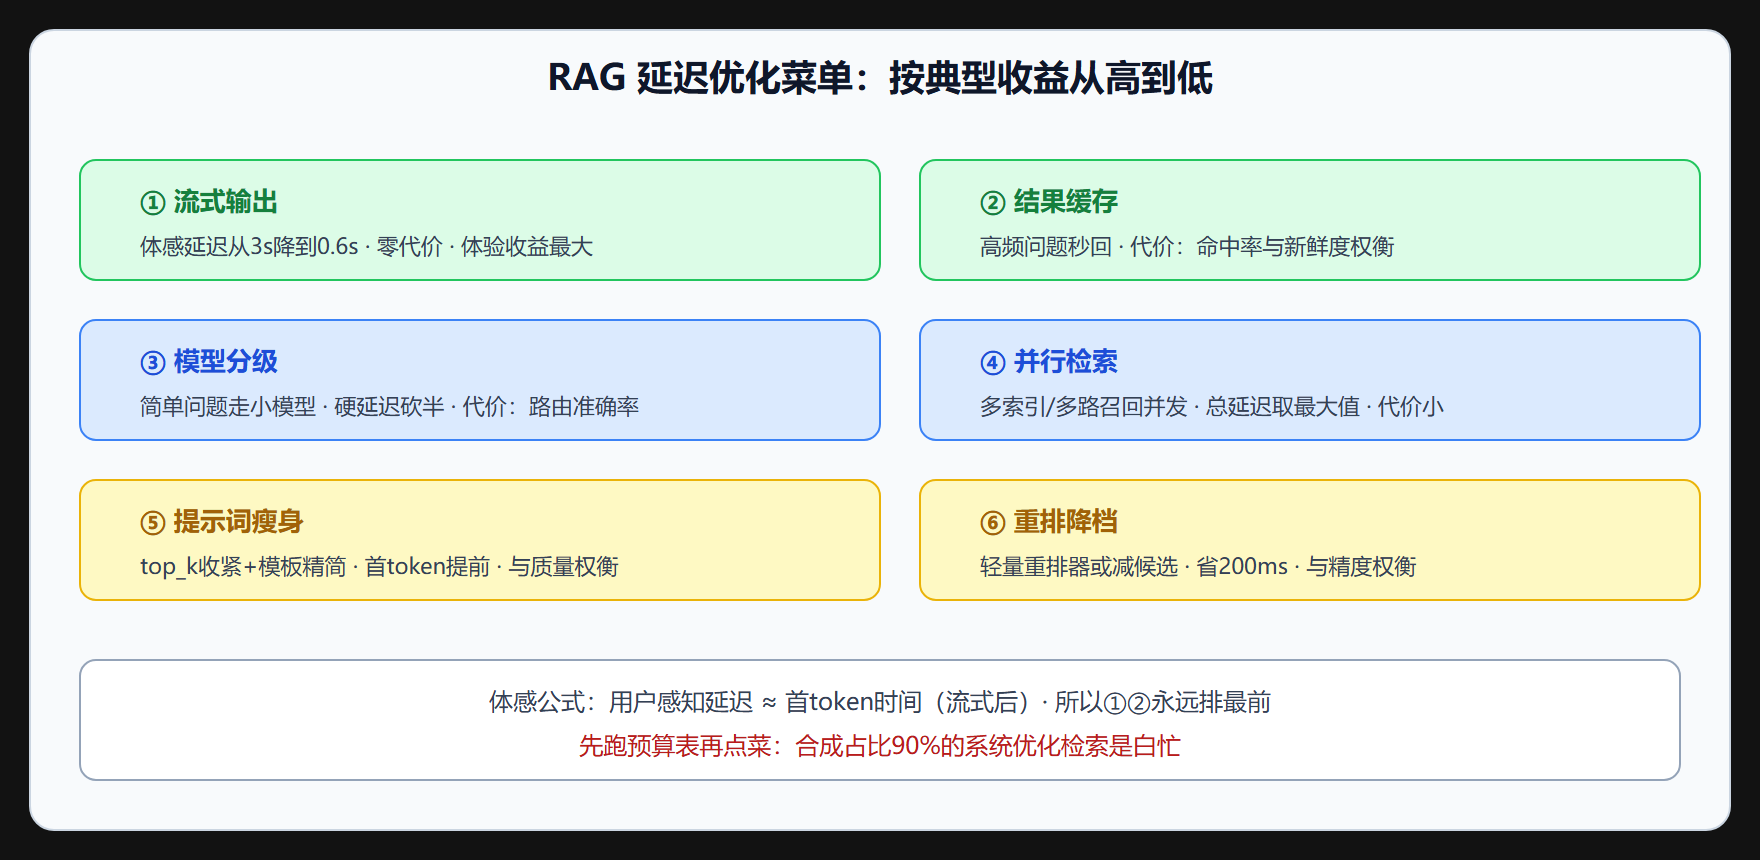
代码落实两个高收益项:
# ① 流式:体感延迟的头号杠杆 engine = index.as_query_engine(streaming=True) resp = engine.query("报销审批流程") for token in resp.response_gen: # 首token后立即开始输出 yield token # ② 结果缓存:高频问题直接命中 from llama_index.core import QueryBundle import hashlib, json _cache = {} def cached_query(engine, question: str): key = hashlib.md5(question.encode()).hexdigest() if key in _cache: return _cache[key] # 秒回 answer = engine.query(question) _cache[key] = answer.response return answer.response
缓存键做"归一化后哈希"(去空格、统一大小写)能把命中率抬高不少;新鲜度用 TTL 或"知识库版本号入键"控制——索引重建后旧缓存自动失效。
模型分级路由
# 简单问题走小模型:省钱且快 from llama_index.core.query_engine import RouterQueryEngine from llama_index.core.selectors import LLMSingleSelector small_engine = index.as_query_engine( llm=Settings.llm_fast, similarity_top_k=3) # 小模型+窄召回 full_engine = index.as_query_engine( llm=Settings.llm_strong, similarity_top_k=8) # 强模型+宽召回 router = RouterQueryEngine(selector=LLMSingleSelector.from_defaults(), query_engine_tools=[ QueryEngineTool(small_engine, ToolMetadata( name="quick", description="简单事实查询:天数、金额、流程步骤")), QueryEngineTool(full_engine, ToolMetadata( name="deep", description="复杂分析、多条款对比、长文综合")), ])
别忘了嵌入侧
高并发下的隐性瓶颈常在摄取侧:批量嵌入的吞吐决定索引更新速度。要点:嵌入调用开批量接口(一次一批而非一条一请求)、本地嵌入模型批量推理、增量摄取(2.4 节缓存)避免全量重嵌。
本节要点回顾
- 预算表先行:分段计时找到最贵一段,合成段通常是大头。
- 体感公式:流式后用户感知 ≈ 首 token 时间,①②永远优先。
- 分级路由:简单问题小模型窄召回,复杂问题才上重型配置。
- 缓存键设计:归一化哈希提命中率,索引版本号入键保新鲜。
- 摄取吞吐:批量嵌入加增量摄取,索引更新不再阻塞。
常见问题
优化到什么程度算够? 给个务实锚点:知识库问答场景,首 token 一秒内、完整回答五秒内,用户满意度就进入平台期,再压延迟的边际收益急剧下降。把工程精力转向命中率与答案质量,比从五秒磨到三秒更值。性能优化的终点是"用户不再抱怨慢",不是物理极限。
语义缓存和结果缓存冲突吗? 不冲突,是上下游:语义缓存拦"意思相近的问题"(需要嵌入计算相似度),结果缓存拦"完全相同的问题"(哈希直查)。顺序上便宜的在前:先查精确缓存,未命中再算语义相似。两层各管一段,命中率叠加。
模型服务端排队严重,客户端能做什么? 三招:请求级超时加重试(指数退避);高峰期降级到备用模型或小模型(6.1 节分级路由);与模型服务方确认并发配额,别让限流打满导致雪崩。排队问题的根子常常在配额管理而非代码。
关于首字延迟再补一个细节:除了模型侧优化,网络路径也值得检查——服务到模型服务的往返、到向量库的往返,跨可用区的几十毫秒累积起来并不小。把推理服务与向量库部署在同一内网区域,是零代码改动的白捡优化。压测时分别测内网与公网路径的差值,常常能发现意外之喜。
压测方法补一句:自建压测脚本时记得带上有区分度的问题集——全是冷门问题的压测测不出缓存收益,全是高频问题的压测又会高估真实性能。从线上日志抽样三成高频问题加七成长尾问题,是贴近真实的压测配比。