6.2 成本效益分析与管理
6.2 成本效益分析与管理
本节摘要:RAG 的账单由四块构成——摄取期嵌入费、查询期生成费、重排与多模态的算力、以及被忽视的"重复劳动税"。本节做一个可复用的成本估算模型,拆解各块占比,给出五条经过验证的省钱策略,并强调"先计量后省钱":没有分项账单的优化都是在雾里开枪。
账单长什么样
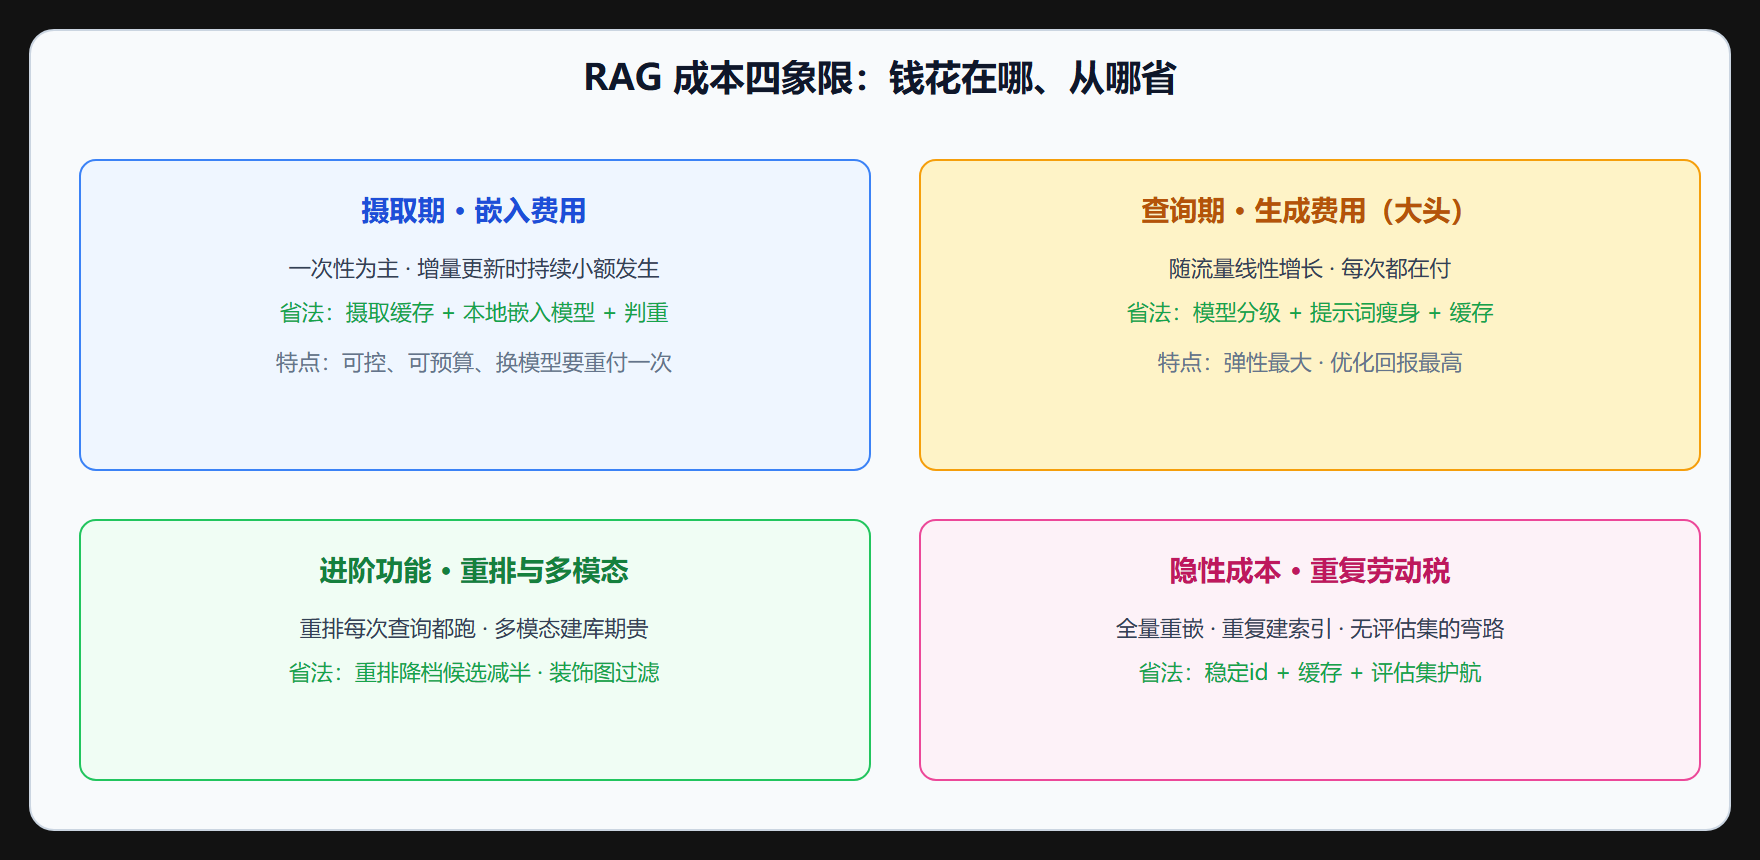
一个可复用的估算模型
def estimate_monthly_cost( docs_tokens: int, q_per_day: int, embed_price_per_m=0.02, # 每百万token嵌入价 gen_in_price_per_m=0.15, gen_out_price_per_m=0.6, ctx_tokens=3000, out_tokens=400): ingest = docs_tokens / 1e6 * embed_price_per_m # 摄取一次性 daily = (q_per_day * (ctx_tokens * gen_in_price_per_m + out_tokens * gen_out_price_per_m)) / 1e6 # 查询期每日 return {"ingest_oneshot": round(ingest, 2), "monthly_query": round(daily * 30, 2), "annualized": round(ingest * 12 + daily * 365, 2)} print(estimate_monthly_cost(docs_tokens=2_000_000, q_per_day=2000)) # 典型输出:查询期月成本是摄取一次性成本的十倍以上
这个模型的真正价值不是绝对数字,而是揭示结构:查询期成本与流量线性相关且占比随时间碾压摄取期——所以优化火力应集中在查询侧(上下文长度、模型档次、命中率)。
五条经过验证的省钱策略
# 策略1:提示词瘦身 —— 上下文是按token付费的 engine = index.as_query_engine( similarity_top_k=4, # 从8收到4,上下文减半 node_postprocessors=[SimilarityPostprocessor(similarity_cutoff=0.35)], ) # 策略2:模型分级 —— 大多数问题不需要旗舰模型 Settings.llm = cheap_llm # 默认走便宜模型 # 只有 Router 判定为"深度分析"的问题才升级(6.1节的路由代码) # 策略3:结果缓存 —— 知识库问答的命中率天然可观 # 6.1节的缓存实现;内部知识库常见30%~60%命中率 # 策略4:摄取缓存 —— 2.4节已实现,全量重嵌只付一次 # 策略5:compact模式+精简模板 —— 少一次调用就省一整次的钱 synth = get_response_synthesizer(response_mode="compact")
省 producing 的另一面:值不值
成本讨论的另一半是效益。一个实用的决策框架:把一次查询成本与一次人工客服成本对比——若 RAG 单次成本是人工的百分之一,即使命中率只有七成,总账仍然大幅为正,剩下的钱应该花在提升命中率(更好的检索、更好的语料治理)而不是把单次成本从百分之一压到千分之一。先算总账,再抠单价。
⚠️ 常见坑:为了省钱把 top_k 压到 2、砍掉重排器,命中率下滑导致用户重复提问,实际查询次数上升,总成本反而增加。省钱策略上线前后都要盯 6.1 节的指标与 5.4 节的评估集。
本节要点回顾
- 四象限账单:摄取嵌入、查询生成(大头)、进阶算力、重复劳动税。
- 估算模型揭示结构:查询期成本随流量线性增长,长期碾压摄取期。
- 五策略:提示词瘦身、模型分级、结果缓存、摄取缓存、compact 模式。
- 总账思维:单次成本与人工对比决定优化方向,别脱离命中率抠单价。
- 负优化警惕:省过头的检索配置会推高重复提问,总成本反弹。
常见问题
老板要看成本报表,给哪些数字? 四个数:单次查询平均成本、月度总成本、缓存命中率(省钱证据)、自动化替代的人工工时(价值证明)。前三个说明效率,最后一个说明效益——没有价值侧数字的成本报表,只会引来"砍预算"而不是"优化"的决策。
本地模型真的更便宜吗? 不一定,要算总账:本地有显卡折旧、电费、运维人力,云 API 按量付费。流量稳定且大时本地摊薄成本占优,流量波动大或小时级使用云 API 更划算。另外本地的隐性收益(数据不出域、延迟稳定)在合规场景里可以折算成真金白银。
成本优化的顺序? 先免费后付费:提示词瘦身与缓存(几乎零成本)→ 模型分级(改路由配置)→ 换更便宜的模型(要评估回归)→ 本地部署(重工程)。跳级做付费优化而免费项还没做,是最常见的浪费。
成本话题最后补一个组织层面的建议:把成本指标做成"看得见的仪表盘"而不只是月底账单。团队实时看见单次查询成本与缓存命中率时,节约行为会自然发生——工程师会主动收紧过宽的 top_k,产品会主动提出高频问题的缓存策略。成本管理的最佳工具不是更便宜的服务,是让花费透明的可视化。
成本话题还有一个维度:失败成本。检索不准导致的错答、权限漏洞导致的数据事件、系统不可用导致的业务中断,这些"负效益"比 API 账单贵几个量级。所以省钱的边界要画清楚:压缩 token、分级模型、缓存复用都是安全的省钱区;砍掉重排、跳过权限过滤、关掉观测上报则是危险区——前者优化的是效率,后者透支的是质量与安全。每个优化提案都值得先问一句:省的是哪类钱,冒的是哪类险。
最后落一个可执行的起点:本周就能做的三件事——给现有系统的每次调用加上 token 计数字段(一行代码);拉出最近一个月的调用量估算月成本;在评估集上跑一次"top_k 减半"的对照实验,看看命中率掉多少、成本省多少。有了这三个数,后续所有的成本讨论都有了锚点,不再是各说各话的感觉之争。
预算沟通也提一句:向上汇报成本时永远带着三个数——绝对值(花了多少)、单位成本(单次查询多少)、价值对照(替代了多少人工)。只有绝对值的汇报 invites 砍预算,带单位成本与价值对照的汇报才能赢得优化空间。