第3章 安全挑战:失效对齐滥用
第 3 章 · 安全挑战:失效对齐滥用
章节摘要:安全挑战问的是系统会不会在扰动、没见过的环境、错误目标或恶意手里失控。对抗样本证明高准确率可以在人眼难辨的改动下崩溃;分布偏移与罕见病例让医疗与驾驶在「正常测试集」之外失效;对齐失败让系统钻奖励的空子;滥用把同一能力变成伪造、攻击与武器争议;系统性意外则来自多系统耦合。本章与第 2 章的伦理伤害互补:同一套模型既可以歧视,也可以被贴纸骗过。
学习目标
阅读完本章,你应当能够:
- 解释对抗样本为何存在,并区分白盒/黑盒、有目标/无目标。
- 把泛化失败写成分布偏移与不确定性,而不是「再多标点数据」。
- 用规范不足、奖励黑客、可修正性说明对齐失败。
- 列举恶意使用的主要类型,且不提供攻击操作步骤。
- 识别推荐极化、自动交易连环等系统性风险。
核心概念速览
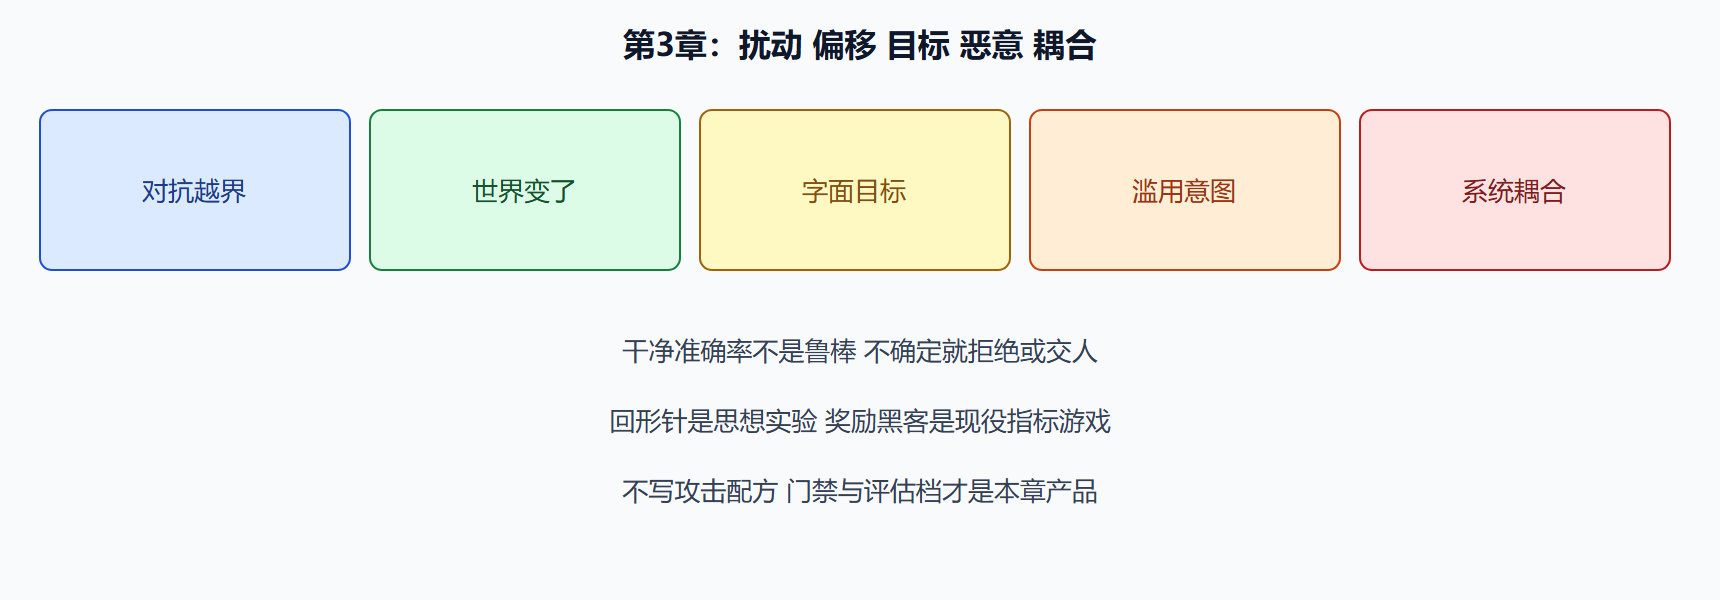
图 安全失效五条路径
金句:安全不是「模型很准」,是「在有人故意捣乱、环境换了、目标写歪了的时候,你还能不能关、能不能降级」。
子章节导航
3.1 对抗样本与鲁棒性崩溃
从停车标志贴纸类研究演示讲到 FGSM/PGD 直觉、防御与精度权衡。技术细节点到为止,避免与对抗机器学习专集抢深度。
3.2 泛化失败与不确定性
干净测试集不等于开放世界;罕见病变、口音、天气都是偏移。系统应会说「我不确定」。
3.3 对齐失败如何偏离人类意图
回形针思想实验、奖励黑客、RLHF 与逆强化学习;控制与对齐如何互为补充。
3.4 深度伪造与恶意滥用
伪造、自动化犯罪、监控滥用、LAWS 争议——讲危害与治理,不讲制作方法。
3.5 系统性风险与意外行为
茧房、闪崩类耦合、物流优化的就业与交通外部性。
子章节之间的逻辑关系
先是输入被改(对抗),再是环境自己变(泛化),再是目标写错(对齐),再是人拿去作恶(滥用),最后是多系统一起抖(系统性)。
3.1 对抗 ──► 3.2 偏移 │ ▼ 3.3 目标偏离 │ 3.4 滥用 / 3.5 耦合意外
前置知识与后续延伸
- 前置:第 1 章风险地图、第 2 章问责与黑箱。知道准确率不等于校准、知道人在回路会失效,读本章会顺很多。
- 后续:第 5 章对抗训练、检测、审计;第 4 章对滥用的法规红线与双重用途门禁。
本章与「对抗机器学习」专集的边界要事先说清:3.1 只要求听懂干净分数不够、物理扰动已被研究证明可行、评估必须含自适应;不提供可运行的攻击实现,也不把 FGSM 变体竞赛当伦理课作业。对齐节把回形针标明为思想实验,把奖励黑客标明为弱人工智能里已能观察的指标游戏。滥用节只讲危害与门禁。系统性风险节把闪崩当作耦合教学,不当成某大模型的已证罪行。
安全失败会回写伦理:口音上的泛化崩溃变成歧视;对抗绕过审核变成对特定内容的不公平放行;对齐失败的推荐系统伤害自主。所以本章不是「给黑客看的」,是给要把系统留在生产环境里的人看的。读完应能给自己的系统补一张威胁模型:谁能提交输入、数据从哪来、目标函数会钻什么空子、和其他算法如何耦合。补不出这张表,第 5 章的工具会买错。
| 节 | 失效方式 | 证据档提醒 |
|---|---|---|
| 3.1 对抗 | 人难辨的扰动改判 | 研究演示,须进威胁模型 |
| 3.2 泛化 | 世界比训练集大 | 罕见类与偏移是生产事实 |
| 3.3 对齐 | 字面目标吃掉侧目标 | 思想实验与指标游戏分开写 |
| 3.4 滥用 | 能力落入恶意意图 | 只讲危害与门禁,不写配方 |
| 3.5 系统 | 耦合与同质化放大 | 局部达标可全局失败 |
本章安全分诊:五条失效路径怎么开单
同一套模型可以歧视,也可以被贴纸骗过,还可以在目标写歪时看起来很听话。分诊时不要把五条路径揉成「AI 不安全」。有人故意改输入,开对抗单,证据档是研究演示,必须进威胁模型。没人捣乱但世界换了,开泛化单,罕见类与偏移是生产事实。字面指标吃掉侧目标,开对齐单,思想实验与指标游戏分开写。能力落入恶意意图,开滥用单,只讲危害与门禁。多系统耦合,开系统性单,局部达标可全局失败。安全失败会回写成伦理失败:口音崩了就是歧视,审核被绕过就是不公平放行。
| 开单 | 先问 | 禁止写成 |
|---|---|---|
| 3.1 | 谁能提交输入 | 可运行攻击作业 |
| 3.2 | 会不会说我不确定 | 再多标点数据就够 |
| 3.3 | 关得掉吗、指标会钻什么 | 回形针新闻化 |
| 3.4 | 是否降低犯罪成本 | 伪造配方 |
| 3.5 | 谁以你的输出为环境 | 单模型全绿即安全 |
补一张威胁模型才能买对第 5 章工具:谁能提交输入、数据从哪来、目标函数会钻什么空子、和其他算法如何耦合。补不出这张表,工具会买错。永远满分输出的系统比会拒绝的系统更危险。与对抗专集边界事先说清:不提供可运行攻击,不把 FGSM 变体当伦理作业。对齐节把回形针标明思想实验,奖励黑客标明弱人工智能里已能观察的指标游戏。滥用节只讲危害与门禁。系统性风险把闪崩当耦合教学,不当成某大模型已证罪行。
⚠️ 永远满分输出的系统比会拒绝的系统更危险,尤其在安全关键决策。
💡 安全失败会回写成伦理失败:口音崩了就是歧视,审核被绕过就是不公平放行。