2.1 参数估计
2.1 参数估计
本节摘要:给定 (p,d,q),估计要解决的是 φ、θ 和常数项。纯 AR 还可用 Yule-Walker 或最小二乘;一旦含 MA,误差不可直接观测,实务以最大似然为主。估计必须带着平稳与可逆约束,否则样本内拟合可以很好,样本外会炸。
本节地图
阅读完本节,你应当能够:
- 说明 MA 项为何让普通「对滞后回归」不够用。
- 列出条件最小二乘与最大似然的适用差别。
- 在输出表里检查系数标准误、平稳/可逆根,而不是只看点估计。
一、AR 好估,MA 藏在误差里
AR(p) 在平稳序列上接近线性回归:用 y_{t-1} 到 y_{t-p} 解释 y_t。Yule-Walker 用样本自相关解系数,Durbin-Levinson 递推同一套关系,最小二乘直接回归。样本大且平稳时,这几条路通常靠近。
MA(q) 不同:y_t = μ + ε_t + θ1 ε_{t-1} + … + θq ε_{t-q},右边的 ε 没有直接观测。你不能把「上期残差」事先列成自变量,因为残差依赖于你正在估的 θ。必须用迭代:先猜 θ,反推冲击序列,再更新 θ,直到似然不再涨。ARMA 两边都有,更是非线性优化。这就是原文把「最大似然估计等方法」放在构建流程里的原因——不是仪式,是 MA 的结构逼你这么做。
示意:假设差分后的平稳序列(教学数字)前 8 项为 2, -1, 3, 0, 2, -2, 1, 2。若候选是 MA(1),你要找一个 θ,使得用「本期冲击 + θ×上期冲击」重建这些点时,冲击看起来最像白噪声。θ 靠近 ±1 时,可逆性变差,优化会难受,预测对初始冲击也敏感。
二、最大似然在做什么
在高斯假设下,似然由残差平方和与残差方差构成。最大化似然近似于让预测误差的样本方差变小,但要对参数个数和初始值付出代价。条件最大似然固定前几个冲击为 0 或用预样本反推;精确最大似然用卡尔曼滤波处理初始不确定性,短样本更值得。软件默认往往是精确或近似精确似然,你需要知道:不同实现会对短序列给出不同的 θ,不是「算错了」。
约束:AR 多项式的根应在单位圆外(平稳),MA 多项式的根也应在单位圆外(可逆)。不可逆的 MA 可以有另一个可逆表示给出同一 ACF,估计会在两个等价点间晃。软件通常把搜索限制在可逆域内。若优化撞到边界,θ 顶在 ±1 附近,优先怀疑过差分或阶给错,而不是再加迭代次数。
图 估计不是点数字,是带约束的搜索
三、读估计结果时的取舍
| 现象 | 更可能的含义 | 我倾向的动作 |
|---|---|---|
| AR 系数接近 1 且 d=0 | 欠差分 | 回到定 d,而不是把 p 加到 5 |
| MA 系数接近 -1 且刚做完差分 | 过差分信号 | 减小 d 再估 |
| 某阶系数标准误很大 | 阶多余 | 从短名单去掉该阶 |
| 常数项显著、差分后均值非零 | 差分序列有漂移 | 保留常数或漂移项,看软件设定 |
| 不同初值得到两套系数 | 似然多峰或不可逆边界 | 简化阶,或换精确似然 |
⚠️ 常见坑:把「所有系数都显著」当成成功标准。过拟合的模型可以让多余系数看起来擦边显著;真正的成功是残差白、滚动误差稳。不显著的高阶项,优先删。
💡 关键直觉:似然在样本内说话。它不知道你后面 8 周仓库会不会改流程。所以估计之后必须留出持出段,不要把全部历史都喂给似然再谈「很准」。
概念拟合(接口示意):
# 对差分阶 d=1、候选 ARMA(1,1) model = ARIMA(y, order=(1, 1, 1)) fit = model.fit(method="statespace") # 看 params、bse、arroots、maroots、resid
常数项与差分:有的实现对 d>0 的序列默认不含常数,有的把漂移放进差分方程。预测的长期水平会被这个选择改变。对发货量这种「差分后仍可能有缓慢增长」的序列,要显式决定要不要漂移,不能靠默认。潮位若已季节差分,常数往往接近 0,硬加常数会把高潮位基线抬歪。
短样本时精确似然更值。十几二十年的月度数据看起来不少,一旦 d=1 再加季节,有效长度又掉一截。这时不同软件的差异会被放大,汇报时应写明估计方法,而不是只贴一组 φ、θ。
四、条件最小二乘、精确似然,以及公共因子
条件最小二乘把前 q 个冲击当成 0,从第 q+1 个观测开始累残差平方。实现简单,短样本里对初始条件敏感:MA 记忆若真的只活一两步,影响还好;若 θ 较大,开头那几个 0 会污染一截。精确似然用状态空间把初始不确定度积进去,短月度序列更值。两者在长日频数据上通常靠近,不必迷信某一种,但报告里应写明,便于别人复现。
初值:软件常用矩估计或汉南-里桑类型的初值再牛顿迭代。撞到不可逆边界时,似然面平坦,换初值可能得到另一套几乎同样的 ACF。这不是随机 bug,是模型过剩。简化阶、检查是否过差分,比加大迭代上限有用。
公共因子:ARMA(1,1) 若 φ≈-θ,两边近似抵消,接近白噪声却用了两个参数。估计表上两个系数都「显著」、符号相反、绝对值接近,就该怀疑。短名单里应用 ARMA(0,0) 或纯低阶对照。信息准则有时仍会留下这对抵消参数,因为样本内总能再咬一点点。残差几乎同样白、持出几乎同样时,留简单的。
常数与方差是否计入 k,影响 AIC 的绝对数,但不影响同软件内排序。跨软件贴 AIC 数字比较没有意义。方差项有的实现叫 sigma2,有的吸收进似然常数。阅读时看系数表里的 φ、θ、常数/漂移即可,不要把优化器的内部缩放参数解释成业务弹性。
估计完成后立刻存残差、拟合值和信息准则,不要只存「最终阶」。诊断失败时你需要回到同一套残差,而不是重新拟合一次得到另一套随机初值。把随机种子或初值策略写进笔记,短样本尤其重要。
五、动手对照:打开估计表先看三行
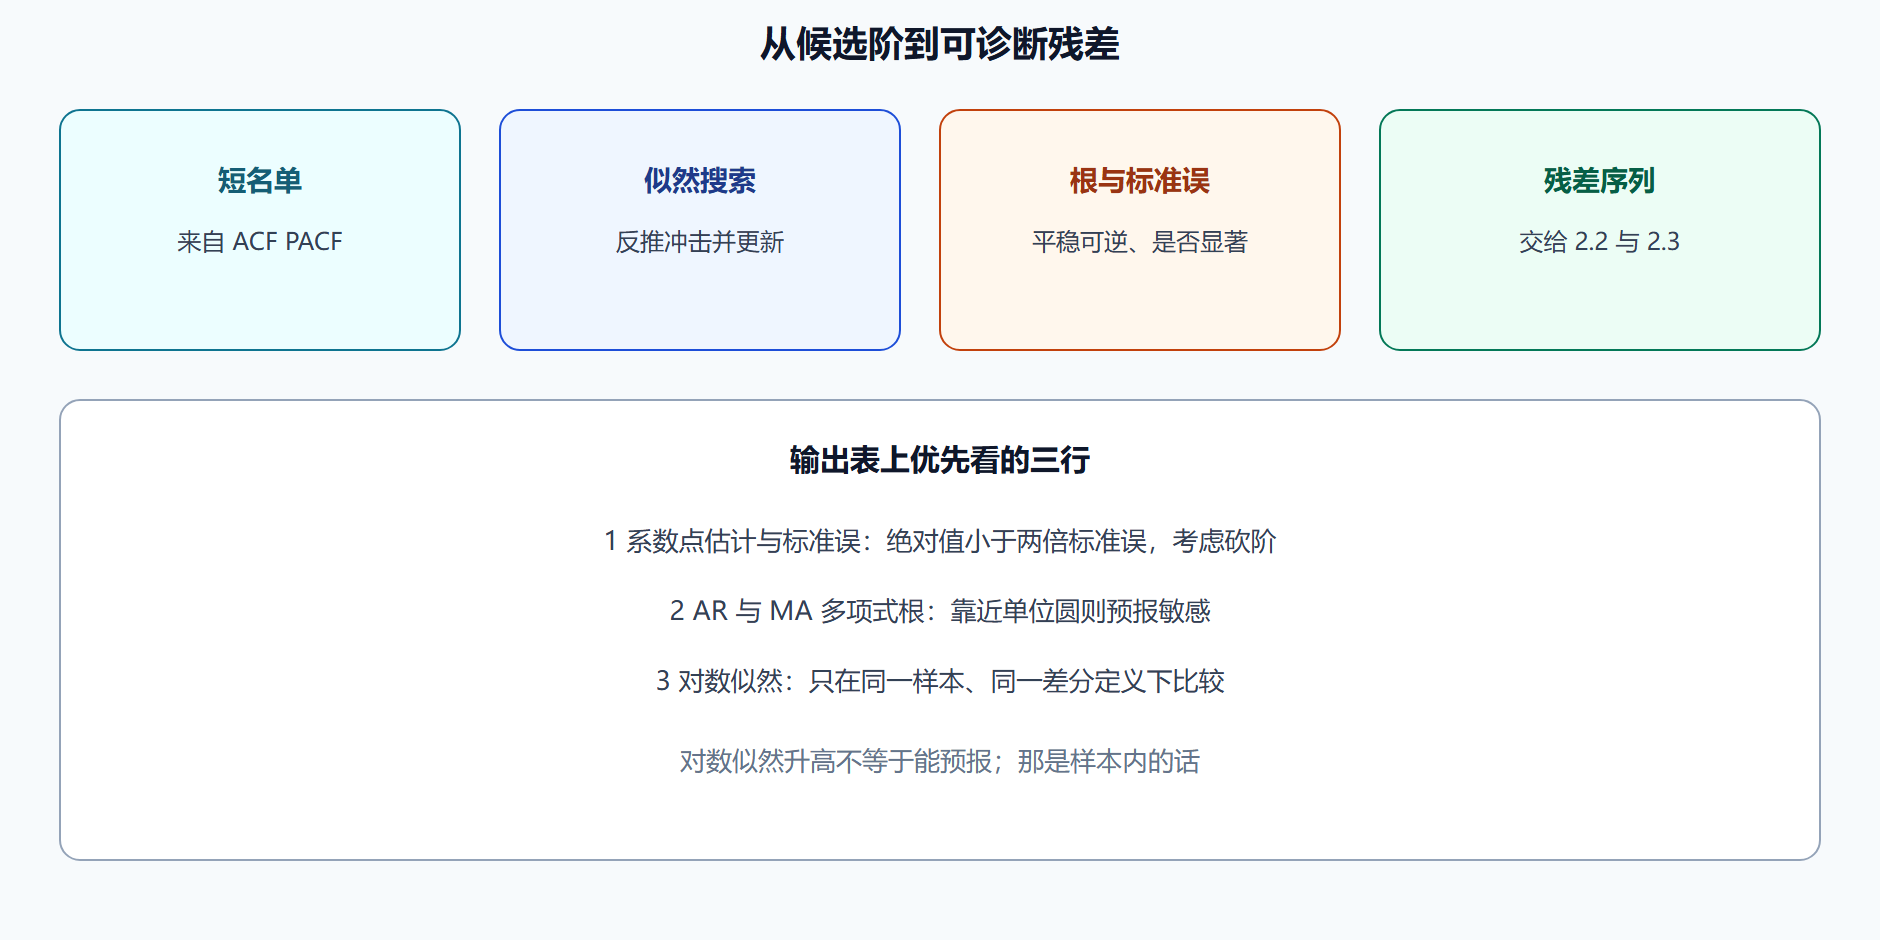
第一行:系数与两倍标准误,不显著的高阶项准备砍。第二行:AR/MA 根的模,贴 1 先查 d 或过差分。第三行:对数似然只在同一样本同一 d 下比较。θ 贴 -1 优先减 d。φ 贴 1 且 d=0 优先加差分。不要把「全部显著」当成功。
问题:为什么 MA 不能当普通回归?
冲击不可观测,必须迭代反推。初值差或不可逆边界会让 θ 乱跳,简化阶比加大迭代有用。
问题:短样本用哪种似然?
精确似然更值,条件最小二乘把开头冲击当 0,MA 记忆较长时会污染一截。报告里写明方法。
六、场景推演(示意,非真实序列)
对候选 ARIMA(1,1,1) 做精确似然。输出表:φ 标准误是否让系数站得住;θ 是否贴 -1;根的模是否 0.98。贴边先回定 d,不是加迭代。常数在 d=1 时当漂移读,潮位有界则否决长期直线,仓库扩容可留但折后分段。短月度用精确似然,条件最小二乘把开头冲击当 0 会污染 MA。不同初值得到两套系数,多半不可逆或公共因子,简化阶。把残差和准则存下来,不要只存最终阶,诊断失败要回到同一套残差。跨软件 AIC 绝对值不可比。似然升高只是样本内的话,持出段必须预先切开,不能吃光历史再谈很准。公共因子 φ≈-θ 时两个系数都显著也要删,留白噪声或纯低阶对照。
七、口令卡与计算备忘
口令:含 MA 必须迭代,根在圆外,似然只在同地形可比。条件最小二乘开头冲击当 0,短样本精确似然更值。AR 近 1 且 d=0 像欠差分,MA 近 -1 且刚差分像过差分。不显著高阶项删掉,全部显著不是成功标准。常数在 d=1 当漂移读,有界序列可否决。公共因子 φ≈-θ 留简单模型。存残差与准则,初值策略写笔记。跨软件不比 AIC 绝对值。持出必须预先切开,吃光历史的似然不能当预报成绩。把估计表三行(标准误、根、似然)当成打开输出的固定顺序。
八、原文要点补全
原文在估计阶段写:根据识别的 (p,d,q) 用最大似然等方法估计 φ 与 θ。纯 AR 还可用最小二乘或 Yule-Walker,一旦含 MA,误差不可观测,必须迭代。条件似然固定前段冲击,精确似然用状态空间处理初始不确定度,短样本更值精确。Hannan-Rissanen 一类两步法可当初值:先高阶 AR 近似再回归 MA。优化必须带着平稳与可逆约束,撞边界说明阶或 d 有问题。常数项与漂移因实现而异,读文档看作用在 y 还是差分。把原文「等方法」展开成可检查的输出表:点估计、标准误、根、似然,而不是只抄一个元组。估计不是完工,残差与持出才是。
对照表(补全动作)
| 输出表现象 | 更可能的原因 | 下一刀 |
|---|---|---|
| φ 总和接近 1 且尚未差分 | 欠差分 | 回定 d |
| θ 顶在负一附近 | 过差分或不可逆边界 | 减小 d 或减阶 |
| 某阶标准误大于点估计一半 | 阶多余 | 从短名单去掉 |
| 两套初值两套系数 | 似然多峰 | 简化模型 |
| 对数似然比另一 d 更大 | 不可比 | 改持出误差 |
| 常数显著但水位有物理上界 | 漂移不合理 | 用领域否决 |
| 根的模 0.98 | 贴单位圆 | 先查地形 |
| 短月度条件似然与精确似然差一截 | 初始冲击当零的代价 | 改精确似然 |
| 只保存了最终阶 | 无法复盘残差 | 同时存残差与准则 |
| 全部系数「显著」 | 可能过拟合 | 看残差与滚动 |
九、示意算术走一遍
打开一次 ARIMA(1,1,1) 输出:先看 φ 是否显著,不显著考虑砍到 (0,1,1);再看 θ 是否贴 -1,贴则回差分;再看根模,0.98 当作警报。短月度用精确似然,条件似然把开头冲击当零会让 MA 记忆污染一截。两套初值两套系数,简化模型而不是加大迭代上限。常数在 d=1 当漂移读,潮位否决,扩容仓可留但折后分段。残差必须存盘。似然升高不是上线理由。把这套打开顺序写成估计节的操作卡,现场就不会只抄一个元组交差。
十、打开输出表的顺序
先读约束是否生效:根模有没有顶在边界。再读标准误:哪一阶可以被砍。最后才读点估计的小数。这个顺序能防止「系数很好看所以完工」。短月度若两种似然差一截,交接里写明用了哪一种,后人才能复现残差。估计表、残差序列、准则值要一起存,只保存最终阶等于无法复盘。
要点串联
- 含 MA 就必须迭代:冲击不是现成自变量。
- 最大似然是实务默认:短样本优先精确似然。
- 平稳与可逆是硬约束:根贴单位圆时先改阶或改 d。
- 标准误用来砍阶:不显著的高阶项不要为了「模型更全」留下。
- AR 近 1 像欠差分,MA 近 -1 像过差分。
- 似然只在同一样本定义下可比:不要跨 d 直接比对数似然。
- 留持出段:估计吃光全部历史,后面的误差指标会撒谎。
下一节把残差摊开:独立性、同方差、正态性,哪一项坏了该回哪一步。