1.1 这座矿的身世与家底:Kaldi 是什么、凭什么用它
1.1 这座矿的身世与家底:Kaldi 是什么、凭什么用它
本节摘要:Kaldi 是约翰霍普金斯大学 Dan Povey 团队主导的开源语音识别工具包,用"C++ 内核 + 脚本外壳 + 食谱约定"的三层结构,把特征提取、声学建模、解码评估整条产线标准化。本节讲清它的来历、家底与适用边界,帮你判断这座矿值不值得开。承接教程导读的产线总览,通往 1.2 的动手建场。
这座矿是怎么被发现的
传说里,埃塞俄比亚牧羊人卡尔迪发现羊群啃了某种红色浆果后异常兴奋,咖啡由此传入人间。语音圈把开源工具包 Kaldi 借了这个名字——寓意"让人兴奋到睡不着的东西"。真实的起点在 Johns Hopkins 大学的一次语音识别研讨会,Dan Povey 带队把多年隐身在各家实验室里的识别流水线,重写成了统一框架,此后十余年由社区持续维护。
在 Kaldi 之前,研究者要在各家自研系统里重复造轮子:数据格式各玩各的,换个数据集等于重写半个系统。Kaldi 的贡献不是发明了某个算法,而是把"从音频到词错误率"这条产线上的每一道工序标准化了——音频怎么登记、特征怎么算、模型怎么训、解码图怎么组、错误率怎么算,全都有一致的做法。这就是"家底"的第一层含义:它是一座规划好的矿区,不是一堆散装设备。
家底的第二层是算法谱系。从经典的高斯混合模型加隐马尔可夫(GMM-HMM),到深度神经网络(DNN)、时延神经网络(TDNN),再到以 LF-MMI 目标函数为核心的链式模型,Kaldi 把这条演化线完整保留在生产可用的脚本里。你可以在同一条数据产线上,把老式选矿机和新式浮选机各开一遍,直接对比成色。
家底的第三层是底座技术:有限状态转换器(FST)。词典、语言模型、上下文规则、隐马尔可夫状态,全都能表示成转换器,再组合成一张解码图。第 5 章会专门拆这张图,这里只需记住:FST 是全场的黏合剂,也是 Kaldi 与多数端到端框架最不同的地方。
用淘金的行话说,这套设计把"判断力"分成了两处:声学模型负责掂量每粒矿砂的成色(这帧音频像哪个音素),解码图负责规划整条淘洗路径(这些音素组合成哪个词更合理)。前者是重装备,后者是路线图,两边在解码时刻汇合。理解了这个分工,后面每一章的内容都能找到自己的位置:第 3 章备矿是为重装备供料,第 4 章调试重装备,第 5 章画路线图并开炉。
拆开仓库看家底
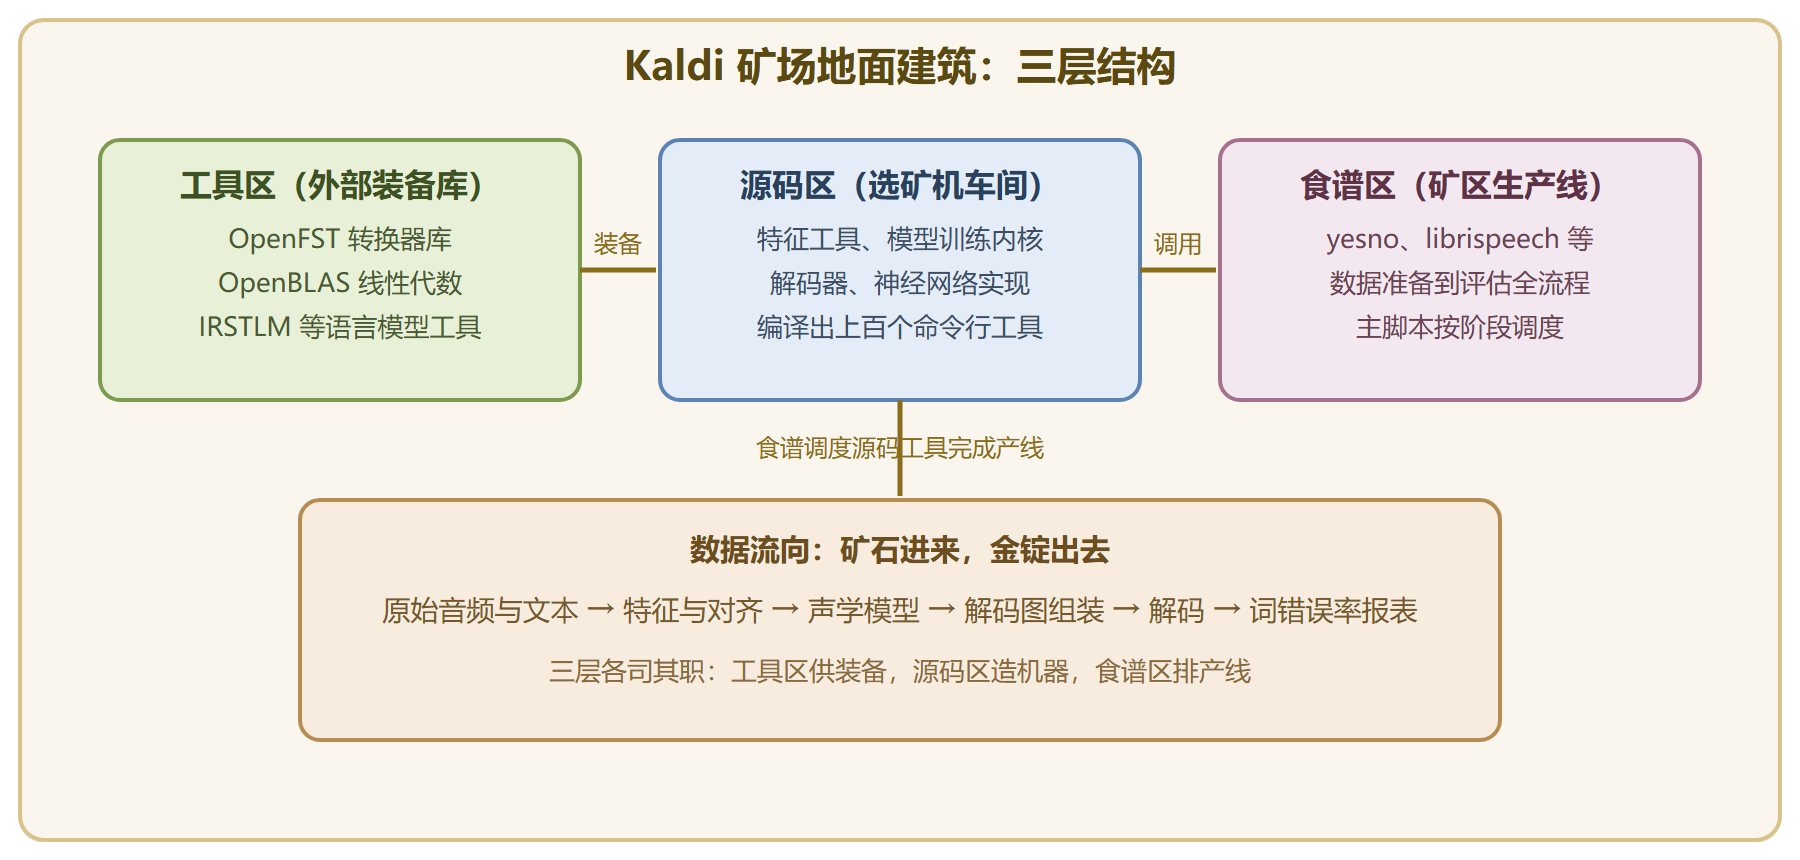
三层结构是读懂 Kaldi 的第一把钥匙:工具区放外部依赖,源码区放 C++ 内核,食谱区放整条产线的脚本。下图把这座矿的地面建筑标了出来。
图 Kaldi 三层结构与数据流向
把仓库拿下来之后,先看顶层有什么,再决定往哪走。第一次克隆不建议拉全部历史,浅克隆足够入门:
# 在家目录下建工作区并浅克隆(只取最新版本,省时省磁盘) mkdir -p ~/kaldi-field && cd ~/kaldi-field git clone --depth 1 https://github.com/kaldi-asr/kaldi.git kaldi # 预期输出末尾: # Receiving objects: 100% ... done. # Resolving deltas: 100% ... done. # 顶层结构一览(目录名即职责) ls kaldi # 预期输出: # COPYING egs misc scripts src tools windows
顶层里最值得记住的三个名字:tools(外部装备库)、src(C++ 内核)、egs(食谱,整条产线所在)。克隆完成后别急着编译,先到 egs 里逛一圈,数一数有多少条产线:
cd ~/kaldi-field/kaldi/egs && ls | head -n 8 # 预期输出(节选,随版本略有差异): # aidatatang_200zh # aishell # librispeech # timit # wsj # yesno
这一步的意义在于建立"矿区感":egs 下每个目录都是一条完整产线,中文语料(如 aidatatang、aishell)、英文语料(如 librispeech、wsj)、最小演示(yesno)各占一个矿区。后面所有章节的操作,都发生在某个食谱目录内部。
这座矿适合你开吗
选型要讲取舍。Kaldi 的强项是流程可控、可复现、对算力要求相对克制;弱项是入门陡、改动内核要懂 C++、生态重心已逐步转向研究维护。用一张表对照常见场景:
| 场景 | 用 Kaldi | 用端到端框架 |
|---|---|---|
| 定制小数据集,需要精细控制每道工序 | 合适,脚本层可自由改 | 往往要改模型代码 |
| 复现经典论文流程 | 合适,食谱即论文复现 | 视框架而定 |
| 快速出产品级服务 | 需要自己封装服务层 | 生态更现成 |
| 深度定制声学模型结构 | 需要动 C++ 或 nnet3 配置 | 改模型代码更直接 |
| 学习 ASR 全流程原理 | 首选,产线透明 | 过程偏黑盒 |
⚠️ 常见坑:教程与脚本版本不配套是新手最大事故源。社区脚本一直在演进,老教程里的参数在新脚本里可能已改名或废弃。动手前先确认自己克隆的版本与所参考教程的年份是否匹配,报错信息里出现"不存在 的选项"一类字样时,第一反应应是查版本差异,而不是怀疑自己敲错。
💡 关键直觉:把 Kaldi 当"带源码的产线"而不是"带接口的库"。它的正确打开方式是读懂食谱脚本的阶段划分,然后在副本上改,而不是试图背下所有命令行工具的参数。
勘矿问答
问:Kaldi 都"老"了,还有学的价值吗? 有,而且理由很实际。其一,工业界仍有大量在役系统是 Kaldi 或其变体搭建的,接手与优化它们需要看懂产线。其二,端到端框架的很多组件(词格、解码、语言模型融合)概念上直接继承自传统流水线,先学 Kaldi 再看新框架,等于先看解剖图再看 X 光片。其三,小数据定制场景里,经典流水线的数据效率往往更好——这恰好是淘金场最擅长的贫矿作业。
问:数学不好能学吗? 脚本层能跑通、能改参数、能读懂报表,这一层对数学的要求是"知道每个量在干什么"。想自己改目标函数、调模型结构,才需要补概率图模型与矩阵求导。建议的顺序是先把产线开起来,再按需回补理论——第 2 章就是为这个回补准备的。
问:必须要 GPU 吗? 跑通 yesno 与小规模 GMM 训练,纯 CPU 足够;到了链式模型阶段,没有 GPU 会慢到怀疑人生。入门期先用 CPU 把流程走顺,再决定是否租卡,是更经济的路线。
带走三句话
- 家底即结构:工具区供装备、源码区造机器、食谱区排产线,三层职责不混。
- 算法谱系完整:从 GMM-HMM 到链式模型,同一条产线可以轮流开不同时代的选矿机。
- 选型看控制欲:要流程透明、可复现、可细调,选 Kaldi;要快速出服务、不在意过程黑盒,端到端框架更省力。
下一节把场地真正平整出来:依赖、编译、验证,一道工序一道工序过。