1.2 平整场地:依赖、编译与验证的完整工序单
1.2 平整场地:依赖、编译与验证的完整工序单
本节摘要:Kaldi 的安装是两条编译线——工具区先装外部装备,源码区再编译 C++ 内核,顺序错了必翻车。本节给出可照抄的依赖清单、两条线的编译命令与验收方法,并整理高频编译事故的处置办法。承接 1.1 的三层结构,通往 1.3 的目录地图。
装备清单与工序单
先讲一个真实场景:一位新同学拿到教程,跳过所有说明直接敲编译命令,十分钟后在第一屏日志里看到"缺少 g++",于是装了 g++ 再跑,又提示缺 zlib,装了 zlib 再跑,再提示缺 OpenFST——折腾一下午,最后发现工具区根本还没编译。这不是他笨,是他没拿到工序单。挖矿前先清点装备,是矿场的第一条纪律。
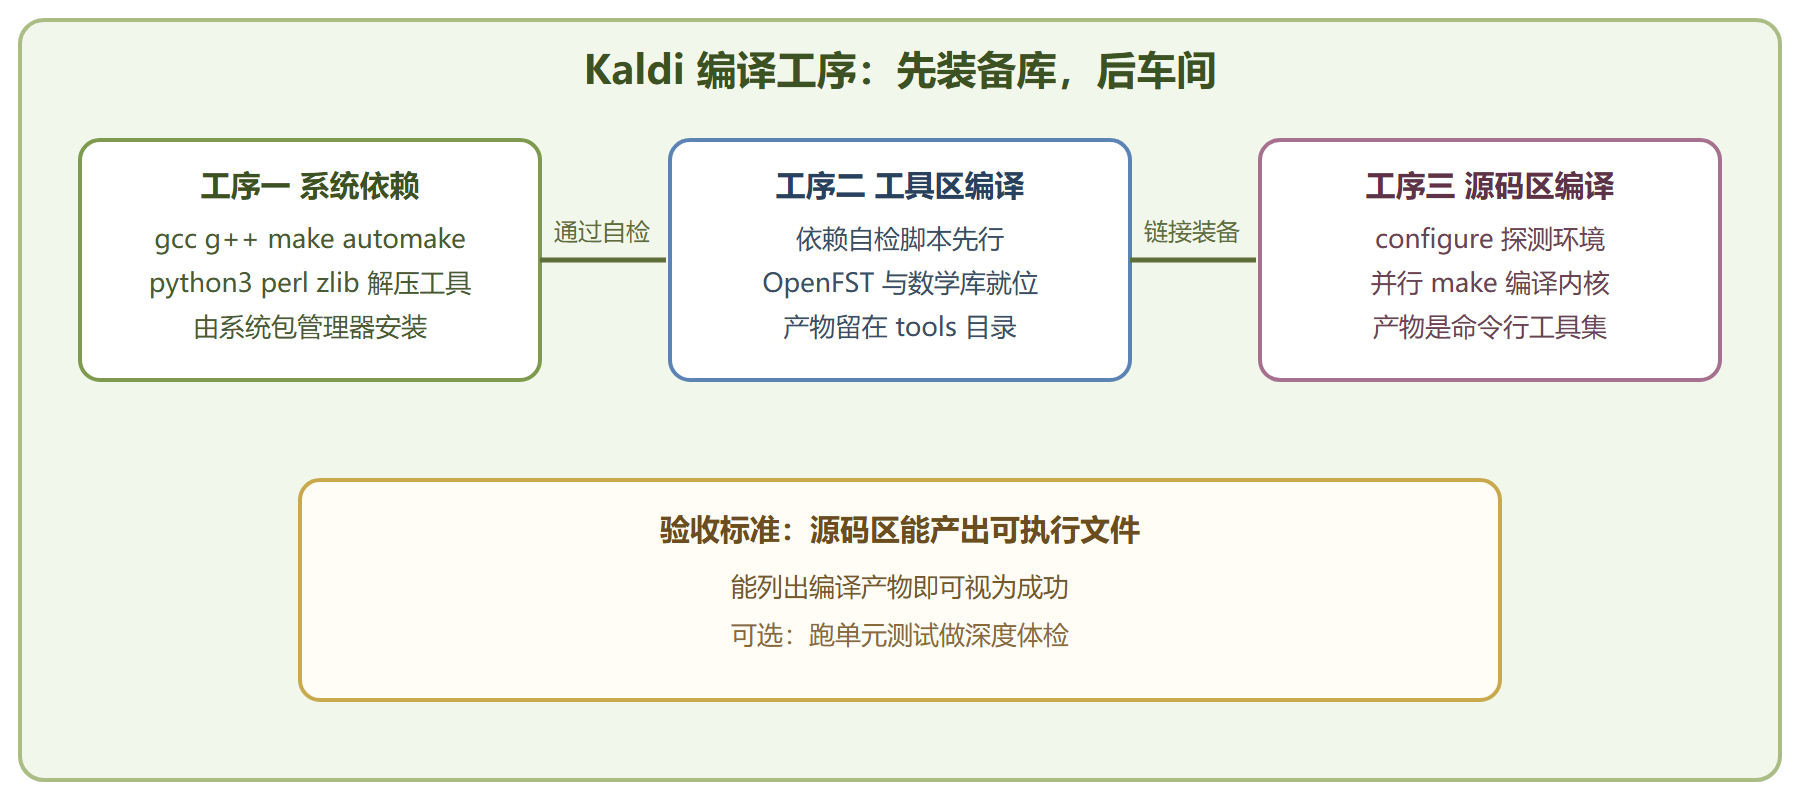
装备分三类。系统装备由系统包管理器安装:编译器、构建工具、脚本语言、压缩库。外部装备由 Kaldi 的工具区脚本下载并编译:OpenFST、线性代数库等。内核装备由源码区编译产出:上百个命令行可执行文件。三类装备的关系与先后顺序如下图。
图 两条编译线的先后关系
工序一:系统依赖
以 Ubuntu 长期支持版为基准。下面这组包覆盖了绝大多数场景,装完基本不会再被"缺少某某"打断:
# 系统依赖:编译器与构建链 sudo apt-get update && sudo apt-get install -y \ git git-lfs make automake autoconf g++ libtool subversion \ python3 python3-pip wget zip unzip zlib1g-dev \ gfortran sox libsox-fmt-all # 预期输出:每行末尾出现“正在设置 包名”或英文 Setting up, # 结束无 unable to locate 字样即为成功 # 快速自检:四个关键命令都要能打印版本号 g++ --version | head -n 1 python3 --version sox --version git --version
每项装备的用途值得记一遍,报错时能立刻定位该找谁:
| 装备 | 在产线上的角色 |
|---|---|
| g++ 与 make、automake | 编译 C++ 内核与外部工具的施工队 |
| git | 拉取源码与部分数据集 |
| python3 与 perl | 食谱脚本的双语工作语言 |
| sox | 音频格式转换与采样率调整的通用钳子 |
| zlib 与 zip、wget | 数据集下载与解压 |
| gfortran | 部分数值库的编译依赖 |
工序二:工具区编译
工具区自带依赖自检脚本,让它替你查漏:
cd ~/kaldi-field/kaldi/tools extras/check_dependencies.sh # 若有缺失,脚本会明确说“请安装 xxx”; # 全部就位时输出:all OK。 # 编译工具区(首次约十几分钟到半小时) make -j 4 # 预期输出末尾:Done. Make sure you have the path to the # tools in your environment variables.
如果想让源码区优先使用系统已装的 OpenBLAS,可以运行工具区提供的切换脚本;用哪个实现不影响后续流程,只影响数值库性能。装好 OpenFST 是关键里程碑——它是后面一切转换器操作的装备。
工序三:源码区编译
源码区先探测环境再施工,两步走:
cd ~/kaldi-field/kaldi/src ./configure --shared # 预期输出末尾会写出检测到的数学库与 OpenFST 路径, # 并提示成功生成构建配置 make depend -j 4 && make -j 4 # 编译时间视机器而定;结束后无 Error 字样即成功
有 NVIDIA 显卡且计划训练神经网络的,在配置阶段加显卡工具链路径参数后重新配置;纯 CPU 环境不必理会,Kaldi 会自动跳过显卡相关组件。
验收只看一件事:产物是否存在。
# 列出编译出的命令行工具(应有上百个) ls ~/kaldi-field/kaldi/src/bin | head -n 6 # 预期输出(节选): # align-text # compute-wer # copy-feats # fstaddselfloops # gmm-align-compiled # ... # 单文件级验证:让它打印一段特性数据到标准输出 echo "[ 1 2 3 ]" | ~/kaldi-field/kaldi/src/featbin/copy-feats ark:- ark,t:- # 预期输出:这行向量被原样打印出来,说明工具链活着
编译事故记录本
⚠️ 常见坑一:check_dependencies 反复报缺。多半是上一次安装半途而废,包管理器状态脏了。先跑一遍修复命令再重来。常见坑二:OpenFST 相关报错出现在源码区阶段,说明工具区没编完就急着编源码,回到工具区补完工序。常见坑三:虚拟机磁盘被编译产物塞满,工具加源码加数据集预留几十吉字节才稳妥,磁盘写满的表现是"莫名其妙的编译错误"。
变式做法:多人共用的服务器上,可以把 Kaldi 装到公共目录,各自只在食谱目录工作;也可以用容器镜像把环境固化,避免每次重装。两条路都保留"工序单"思想:先装备、后内核、再验收。
环境问答与体检脚本
问:能在苹果芯片的机器上装吗? 官方主线面向 x86 架构的 Linux。苹果芯片上通常走容器或远程服务器的路子,本机直装需要处理架构差异,不建议入门期折腾。问:Windows 怎么办? 两条主流路:用 Linux 子系统,或在虚拟机里装 Ubuntu。子系统方案磁盘性能略差但日常够用;仓库里也有 Windows 目录提供参考支持,属于进阶选项。问:装到一半断了要重来吗? 不用,两条编译线都支持增量续编,直接重跑同一条命令,已完成的部分会跳过。
把验收动作固化成一个小体检脚本,每次开新机器都先跑一遍:
# 环境体检:四项全过再开工 check_env() { # 第一项:内核工具是否存在且可执行 local bin_dir=~/kaldi-field/kaldi/src/bin [ -d "$bin_dir" ] && ls "$bin_dir" | wc -l # 第二项:工具区自检 (cd ~/kaldi-field/kaldi/tools && extras/check_dependencies.sh | tail -n 1) # 第三项:磁盘余量(单位吉字节) df -BG ~ | awk 'NR==2 {print $4}' # 第四项:内存余量(单位吉字节) free -g | awk 'NR==2 {print $7}' } check_env # 预期输出(示例): # 120 <- 可执行文件数量,超过一百即健康 # all OK. <- 依赖自检通过 # 80G <- 磁盘余量,建议三十吉字节以上 # 6 <- 可用内存,小任务至少几个吉字节
四项输出的判读标准:工具数量过百说明源码区编译完整;自检通过说明装备库没缺件;磁盘与内存的余量决定你后面能开多大的矿——第 4 章的神经网络训练对内存尤其敏感。把体检变成习惯,很多"训练到一半暴毙"的事故可以在开工前拦下。
工序验收单
- 顺序不可换:系统依赖 → 工具区 → 源码区,任何一步没验收就推进,报错都会向后传染。
- 验收看产物:依赖自检输出 all OK、源码区能列出可执行文件,比盯着滚动日志靠谱。
- 报错先定位工序:把报错关键词对照三条工序,先判断它属于哪条线的责任,再动手搜。
场子平好了,下一节拿着地图逛矿区:目录怎么分工、食谱怎么组织、主脚本怎么调度。