- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:把 Kaldi 语音识别当成一座淘金场
在语音圈,见面礼往往不是递名片,而是问一句:yesno 跑通了吗?跑通了,才算拿到了矿区的入场券。圈内人把 Kaldi 的示例工程叫"食谱",把训练叫"煲汤",这些黑话背后藏着同一件事——Kaldi 是从原矿直达金锭的完整生产线,而不是一颗即插即用的螺丝钉。这套教程换一副眼镜看它:把语音识别训练当成一场淘金,音频是矿石,特征提取是破碎筛分,声学模型是选矿机,解码是出炉,每道工序都有质检。顺着这条产线走一遍,Kaldi 那张著名的"劝退目录表"会变成一张清晰的矿场平面图。
一句话定位:这是一套以"淘金产线"为主线的 Kaldi 实战教程——从搭好选矿场、认清矿石、备矿筛分、训练选矿机,到开炉解码、成色鉴定与增产排障,把开源语音识别工具包 Kaldi 的完整工作流走通并讲透。
这个教程解决什么问题
Kaldi 由约翰霍普金斯大学的 Dan Povey 团队主导开发,是学术界和工业界沿用多年的开源语音识别工具包。它的名声与它的门槛同样突出:源码是 C++,流程靠 shell 脚本串接,知识靠有限状态转换器(FST)黏合。初学者最常见的三种死法,本教程都有针对性的解法。
第一种死在编译,依赖缺一个就全盘卡住;第二种死在目录,工具、源码、食谱各占一层,不知道该从哪里下手;第三种死在报错,数据文件格式差一个空格,训练脚本就罢工。对应地,这套教程把环境搭建拆成可回查的工序单,把目录结构讲成矿区地图,把排错经验整理成事故记录本,而不是让你在报错日志里独自淘金。
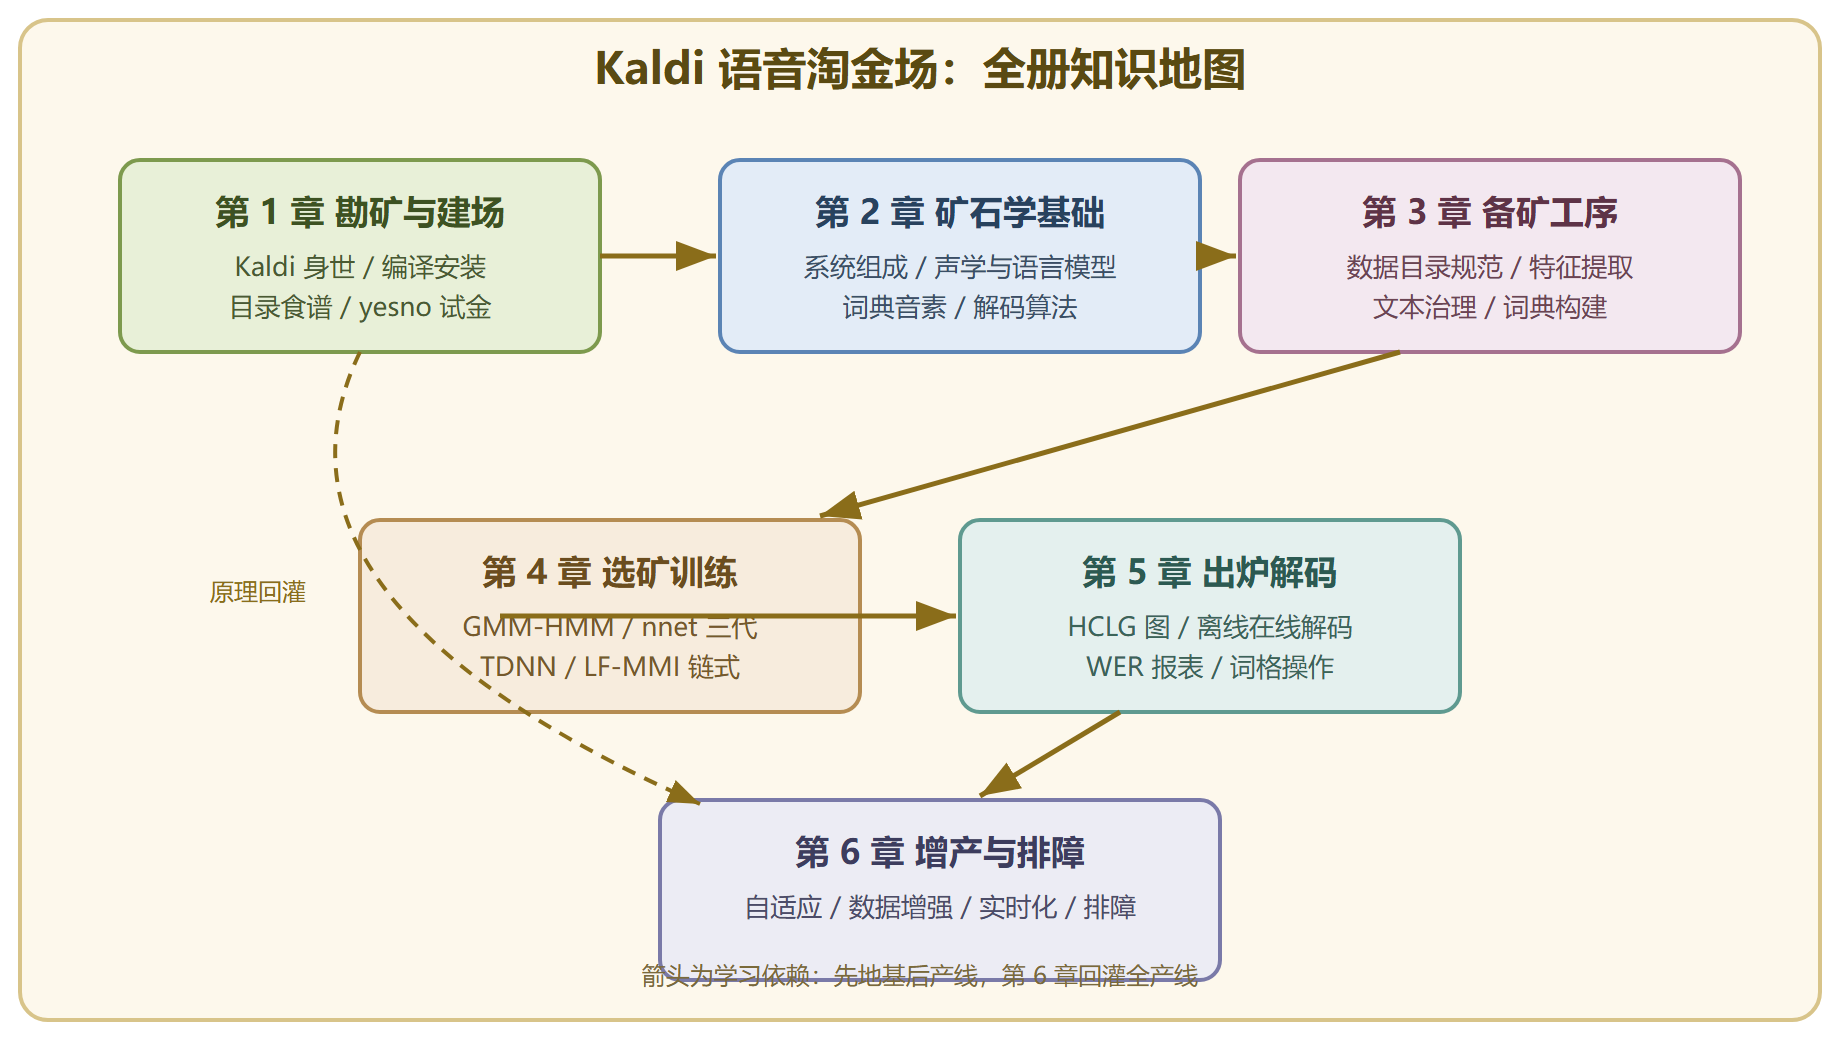
全册遵循同一条主线:先勘矿建场(认识 Kaldi、编译安装、跑通最小的 yesno 产线),再学矿石学(语音识别的原理地基),然后备矿(数据准备与特征提取),接着选矿(GMM-HMM、TDNN、链式模型三级训练),最后出炉(解码图、解码与词错误率评估)并增产(自适应、数据增强、实时化与排障)。每章承接上一章的产物,产线不断线。
适合谁读
- 有 Linux 命令行基础、想入语音识别门的研究生或工程师
- 用过 Kaldi 跑通食谱、但看不懂脚本在做什么的"半跑通"用户
- 需要训练自有中文语料、做定制识别系统的团队开发者
- 想理解传统 ASR 流水线、以便对照理解端到端新框架的进阶读者
学完你能做什么
- 独立完成 Kaldi 的依赖安装、源码编译与环境验证
- 看懂食谱目录的分工,把 yesno 从数据准备一路跑到词错误率报表
- 按 Kaldi 规范登记自己的语料:音频清单、转写文本、说话人映射、发音词典
- 说清 MFCC 特征、GMM-HMM、TDNN、链式模型各自在产线上的角色
- 构建 HCLG 解码图,完成离线解码,读懂词错误率报表里的每列数字
- 用说话人自适应、数据增强和词格重打分为产线增产提效
全册知识地图
六座矿场环环相扣:勘矿建场是地基,矿石学是理论地基,备矿喂给选矿,选矿喂给出炉,增产回灌全产线。
图 教程知识地图与学习依赖关系
怎么用这个教程
建议按章顺序读,产线前后相接,跳章容易断链。第 1 章和第 3 章必须动手:一边读一边在自己的 Linux 环境(推荐 Ubuntu 长期支持版)里敲命令,编译一次、登记一批自己的音频,比读十遍文档管用。第 2 章是理论地基,可在跑通 yesno 之后回头精读,把"为什么这么算"补上。第 4、5 章是产线核心,建议对照 yesno 产出的目录边看边查。第 6 章按需取用,遇到瓶颈再来翻。
每章开头有一张"主线交代",结尾有"下一章的接力",用来保持产线不断线;每节开头先用一句话点明本节在产线上的位置。教程中提到的命令都以可直接敲入的形式给出,输出示例注明了预期结果,方便对照自查。
金句收尾:矿石不会自己变成金锭,语音数据也不会自己变成识别系统——中间每一道工序,都值得你看一眼。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...