2.1 从矿石到金锭的流水线:识别系统的组成
2.1 从矿石到金锭的流水线:识别系统的组成
本节摘要:语音识别在数学上是在找"给定声音时最可能的词序列",工程上被拆成声学模型、发音词典、语言模型、解码器四块积木。本节把四块积木的接口关系与训练、解码两阶段的对称结构讲清,为后续三节的逐个深入搭好框架。承接第 1 章的 yesno 沙盘,是第 2 章的地基节。
学习目标
阅读完本节,你应当能够:
- 写出识别问题的概率表述,并指出每个因子对应哪块积木
- 画出从波形到词序列的数据流图,标出每步的输入输出
- 解释训练阶段与解码阶段为什么是"互为镜像"的关系
- 说明四块积木中哪一块可以独立升级而不动其他块
一、问题与直觉:听写机器的拆解
如果让你造一台听写机器,最直接的想法是逐帧分类:把声音切成小片,每片判断一个字。这条路走不通,原因有二。其一,声音与文字没有稳定的逐帧对应关系——同一个字说得快慢不同、口音不同,波形差异巨大。其二,人说话有协同发音现象,一个音会被前后音"染色",单看一小片根本认不出它。
可行的思路是反过来问:给定一句话的文字,这段声音有多大可能听起来像这样?再把"这句话像不像人话"的概率乘上去,对不同候选句子各算一个总分,选总分最高的。这就把"从声音找文字"的正向难题,变成"从文字给声音打分"的反向评估题——评估比生成容易,这正是统计识别框架的聪明之处。
用符号写出来:最优词序列正比于声学概率乘以语言概率,声学概率又通过发音词典拆解到音素层面。三个概率因子各自由一块积木负责:声学模型算"音素发出来像这声音的概率",发音词典负责"词拆成音素"的映射,语言模型算"词序列像人话的概率",解码器负责把三者组合起来搜索最优。
二、四块积木与数据流
图 识别产线全景:训练与解码互为镜像
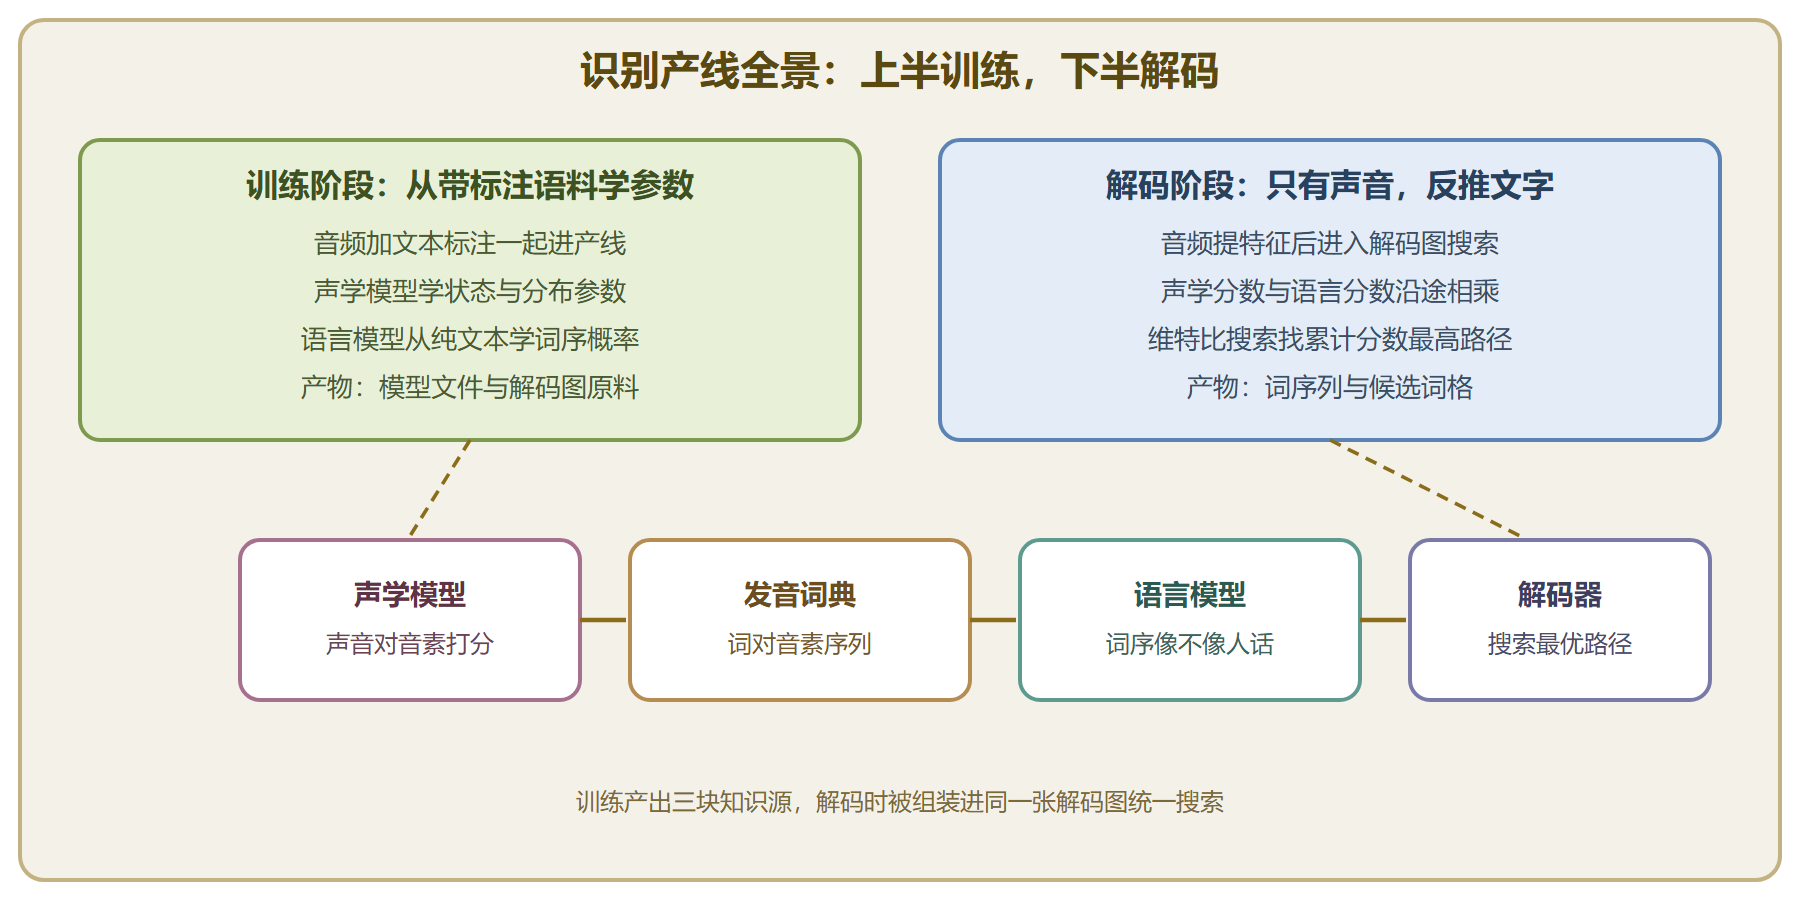
四块积木的接口关系可以用一句淘金行话记:声学掂矿砂的斤两,词典管怎么拆矿,语言管矿脉走向,解码器按图淘洗。前后衔接靠的是统一的中间货币——音素序列。声学模型输出音素层面的分数,词典把词换算成音素序列,两边的账才能对上。
接口清晰带来一个工程红利:积木可以单独升级。Kaldi 生态里最常见的升级就是只换打分器——高斯混合换神经网络,词典与语言模型原封不动,产线照跑。第 4 章的三代训练流程,本质就是三次只换打分器的升级。
再说说特征在产线上的位置。波形进厂第一站不是声学模型,而是特征提取:把连续波形按固定步长切片,每一片算出一组数(比如梅尔倒谱系数),一段音频就变成一串向量。声学模型吃的是这串向量而不是波形本身。把特征独立成一道工序,好处是算一次反复用——训练、对齐、解码共用同一批特征文件,也意味着特征参数一旦改动,后面所有产物都要重算。这就是第 1 章日志里特征阶段排在训练之前的原因。
训练与解码的镜像关系值得展开一句。训练阶段你手里有音频也有文字,声学模型学的是"已知文字的情况下,声音该怎么分布";解码阶段文字缺席,系统反着找"哪段文字最能解释这段声音"。方向相反,组件相同:特征提取一样、词典一样、音素骨架一样,变化的只是"文字已知还是未知"。理解这个镜像,你就明白为什么对齐文件能当训练产物——训练时文字已知,把每一帧贴上音素标签是可行的,这份标签又成了下一代神经网络的监督信号。
常见疑问三连
问:为什么不端到端一步到位,非要拆积木? 拆开是为了数据效率与可诊断性。各块积木可以单独换、单独测、单独归因,出问题时能定位到"是耳朵聋了还是没文化"。端到端模型省了拆装的麻烦,但训练要吃海量数据,出了错也难说清哪个环节的锅。两条路线各擅其场,第 6 章末尾会再对比。
问:四块积木里哪块最贵? 训练期的瓶颈几乎总在声学模型,尤其上了神经网络之后;解码期的瓶颈在解码器搜索与语言模型查表。这个分布解释了后面章节的篇幅安排——第 4 章整章讲声学训练,解码只占一章。
问:词典也算模型吗? 它不带可学参数,但它是知识源,错误词典带来的损失不亚于错误模型。漏词、错音标、不一致的音素表,每一种都会在训练或解码时炸出来。第 3 章建词典那一节会用整节的篇幅伺候它。
三、用玩具例子把账算一遍
道理要落到数字上才算懂。写一个十行的演示:两个候选句子的声学与语言概率都是拍脑袋给的,看总分如何决出胜负:
# 玩具解码器:两个候选句子,各算一个总分 # 声学概率:这句话听起来像这段声音的可能性(假设值) # 语言概率:这句话本身的先验可能性(假设值) candidates = { "识别 语音": {"acoustic": 0.020, "lm": 0.010}, "识别 雨": {"acoustic": 0.030, "lm": 0.001}, } for sent, p in candidates.items(): score = p["acoustic"] * p["lm"] # 对数域里就是相加 print(f"{sent}: 声学 {p['acoustic']} x 语言 {p['lm']} = {score:.6f}") # 输出: # 识别 语音: 声学 0.02 x 语言 0.01 = 0.000200 # 识别 雨: 声学 0.03 x 语言 0.001 = 0.000030 # 结论:第二句虽然更像这段声音,但太不像人话, # 总分落败——语言模型在这里一票定乾坤
这个例子揭示了产线的核心张力:声学分数管局部像不像,语言分数管全局通不通,两个分数量纲不同,直接相乘时隐含了一个权重。真实系统里这个权重可调,调偏了会出现"句子很通顺但内容全错"或"词都对但语序怪异"两种典型病症,第 5 章打分时还会回到这里。
真实产线里每个阶段的工具都能对号入座,下面这张对照表把第 1 章的沙盘与本节的积木接起来:
阶段 主要工具(示意名) 积木归属 特征提取 特征提取、统计量计算 为声学模型备料 词典与语法 语言资源准备脚本 词典与语言模型 声学训练 单音素、三音素、网络训练脚本 声学模型 图组装 解码图构建脚本 三块积木总装 解码评估 解码与打分脚本 解码器加评估
⚠️ 常见坑:把语言模型当成"纠正错别字的插件"。它是先验,不是补丁,介入时机在打分阶段而非输出之后。输出后再改字的方案属于后处理,两者别混。
本节要点回顾
- 识别是搜索:在概率地图上找总分最高的词序列,不是逐帧认字。
- 三块知识源:声学模型、发音词典、语言模型各管一段,音素序列是通用货币。
- 镜像结构:训练阶段"有标注学参数",解码阶段"无标注反推文字",方向相反、组件相同。
- 可升级性:接口稳定让打分器可以单独换代,这是传统流水线长寿的秘密。
下一节钻进第一块积木的内部:隐马尔可夫模型怎么用状态刻画时间,高斯混合与神经网络怎么为状态打分。