2.2 选矿机的心脏:从隐马尔可夫到时延神经网络
2.2 选矿机的心脏:从隐马尔可夫到时延神经网络
本节摘要:声学模型回答"这段声音对应哪个音素状态"。Kaldi 用隐马尔可夫模型刻画音素的时间结构,用高斯混合或神经网络为每个状态打分,用三音素与状态绑定解决协同发音与数据稀疏两大矛盾。本节承接 2.1 的积木框架,深入第一块积木的内部构造,为第 4 章的三代训练流程备足理论。
先看一台老式选矿机
想象一台只有三个档位的筛矿机:矿砂从进料口进来,依次经过粗筛、中筛、细筛,每个档位停留的时间不固定,但顺序不会颠倒。音素的发音过程与此神似:一个音素在时间上展开为若干个隐状态,状态之间按固定方向转移,每个时刻你只能观察到一帧特征(筛出来的矿砂成分),看不到当前处于哪个档位——这就是"隐"马尔可夫的来历。
马尔可夫性指"下一站只取决于当前站",与走了多少弯路无关。这个简化让模型参数量大减,也让动态规划算法有了用武之地。一个隐马尔可夫音素模型由三样东西定义:一组隐状态、状态间的转移概率、每个状态生成观测的概率分布。训练的目的是从大量标注音频中把这三样东西估出来。
教科书把隐马尔可夫的问题归成三个:给定模型算某段观测的概率(评估),给定模型与观测找最可能的隐状态路径(解码),从数据学出模型参数(学习)。三个问题恰好对应产线的三个动作:评估对应打分,解码对应对齐,学习对应训练。第 1 章 yesno 日志里的似然值与对齐文件,就是评估与解码两个动作的产物。
高斯混合与神经网络:两代打分器
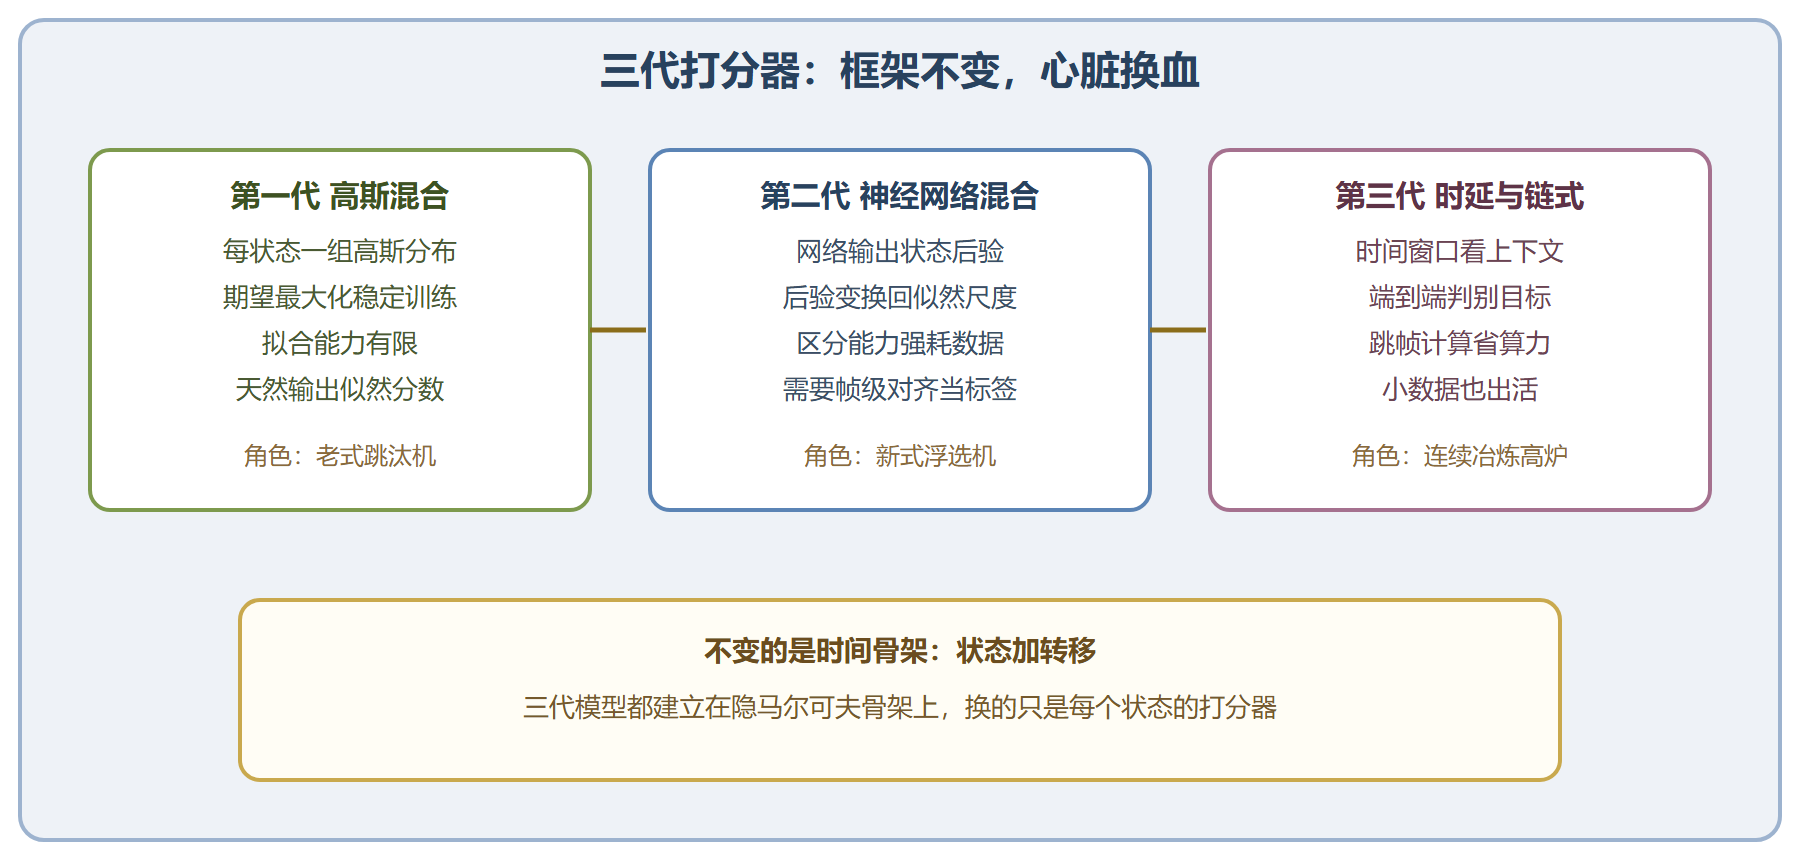
隐状态自己不会发声,需要配一个"打分器"回答:这帧特征在这个状态下出现的概率有多大。经典答案是高斯混合模型——用若干个多元高斯分布加权叠加去拟合一帧特征在某个状态下的分布形状。一个状态配一组均值向量与协方差矩阵,状态与状态之间的分布彼此不同,打分才有区分度。
高斯混合的好处是数学性质干净、可用期望最大化算法稳定训练;短板是拟合能力有限,且特征维度一高,参数量平方级膨胀。神经网络的入场点正在这里:用一个多层网络直接输出"这帧属于各状态的后验概率",再用一个简单变换把后验转成类似似然的分数,塞回隐马尔可夫框架继续用。框架没换,打分器换了——这就是所谓混合架构。
从全连接网络到时延神经网络(TDNN),进化方向是"让网络看得见时间上下文"。全连接网络每帧独立打分,看不见前后;时延网络在时间轴上开窗口,当前帧的判断可以参考前后若干帧,正好对症协同发音这个老毛病。再往后,链式模型干脆改动训练目标与网络结构,把整条产线的效率又抬了一级,细节留给第 4 章。
图 声学模型三代打分器对照
三音素与状态绑定:对付协同发音
同一个音素站在不同的邻居旁边,发音就会变形,语言学把这种现象叫协同发音。建模上把"左邻音素加自身加右邻音素"打包成一个三音素单元,同一个音素就有了几百种化身,区分度上去了,新麻烦跟着来:多数三音素组合在训练语料里只出现寥寥几次,参数根本估不准——这就是数据稀疏。
解法是状态绑定:把发音情况相似的三音素状态挂到同一个物理状态上共享一套打分参数,判断"谁跟谁相似"的工具是决策树。树的每个节点问一个关于上下文的问题(左边是不是鼻音、右边是不是元音之类),叶子上落着一组绑定在一起的状态。绑定让参数量与数据量重新配平,也让没见过的三音素能顺着树找到近似亲戚——词典里没有的组合不至于无家可归。
用一个小计算演示"为什么绑定不可缺"。设音素表有四十个音素,三音素组合理论上有六万多种,若每种再拆三个状态、每状态配几十个参数,参数量瞬间失控;而决策树把有效状态数压到几千个,每个状态平均能分到成千上万帧训练数据。参数变少、每份参数的证据变多,模型反而更准——这是传统流水线里最值得反复咀嚼的一次取舍。
把这笔账交给程序算,比盯着公式更有体感:
# 算一算状态绑定前后的账:参数量与数据量的配平 phones = 40 # 音素表规模,中文常用音素集大约这个量级 triphones = phones ** 3 # 左邻 + 自身 + 右邻 的理论组合数 states = triphones * 3 # 每个三音素再拆成首、中、尾三个隐状态 print("三音素组合数:", triphones) # 输出:64000 print("不绑定时的状态总数:", states) # 输出:192000 frames = 10_000_000 # 假设训练语料共一千万帧 tied = 4000 # 决策树绑定后的有效状态数(典型量级) print("绑定后每状态平均帧数:", frames // tied) # 输出:2500 print("不绑定时每状态平均帧数:", round(frames / states, 1)) # 输出:52.1
结论一目了然:不绑定时平均每个状态只摊到五十来帧,参数根本估不准;绑定后每状态有两千五百帧打底,估计稳了。决策树问的每个上下文问题,本质上都是在给"哪些状态可以共用一套参数"划界。
⚠️ 常见坑:把"高斯数越多越好"当成信条。高斯分量数、状态数、树问题集都要与数据量匹配,小语料上堆参数只会过拟合,训练日志里似然漂亮、测试错误率难看,就是典型症状。
亲手算一次维特比
三个基本问题里的"解码",用维特比算法五帧三状态就能算明白。下面的演示直接可跑:
# 玩具维特比:三个状态,五帧观测 # 发射分数:每帧在各状态下的打分(假设已由打分器给出) # 转移矩阵:留在原地与前进到下一状态的概率 import numpy as np emit = np.log(np.array([ # 发射分数取对数,乘法变加法 [0.6, 0.3, 0.1], [0.2, 0.6, 0.2], [0.1, 0.3, 0.6], [0.5, 0.4, 0.1], [0.2, 0.5, 0.3], ])) stay, move = np.log(0.6), np.log(0.4) # 自环与前进的转移对数分 T, S = emit.shape dp = np.full((T, S), -1e9) bp = np.zeros((T, S), dtype=int) dp[0] = emit[0] # 首帧初始化 for t in range(1, T): for s in range(S): cands = [dp[t-1, s] + stay, # 留在原状态 dp[t-1, s-1] + move if s > 0 else -1e9] # 从前一状态来 bp[t, s] = int(np.argmax(cands)) dp[t, s] = max(cands) + emit[t, s] # 回溯最优路径 path = [int(np.argmax(dp[-1]))] for t in range(T - 1, 0, -1): path.append(bp[t, path[-1]]) print("最优状态序列:", path[::-1]) print("路径累计对数分:", round(float(dp[-1].max()), 3)) # 输出: # 最优状态序列: [0, 1, 2, 1, 1] # 路径累计对数分: 约 -6.7(随精度略有差异)
逐行看这段代码:动态规划表每一行是一帧,每格存"走到这一帧落在这个状态的最佳累计分";回溯指针记录这个最佳是从哪来的;最后从末帧最高分倒着走回去,就是最优路径。真实解码器面对的是几百万个状态与几千帧,但每一格做的事与这五行循环完全一致,第 2.4 节把这套填表推广到完整解码图。
带走四句话
- 骨架与心脏分离:隐马尔可夫管时间结构,打分器管帧级判断,两者可独立演进。
- 三音素治协同发音:上下文打包建模,代价是组合爆炸,再靠状态绑定拉回来。
- 换代只换心脏:从高斯混合到时延网络,框架与接口始终未变。
- 对齐是硬通货:网络训练依赖上一代模型给出的帧级对齐,代际接力由此实现。
声学模型管住了"音",但一句话通不通顺它不管。下一节请出语言模型与发音词典,看"词"层面的两块知识源如何接力。