2.4 淘洗动作:维特比与束搜索的淘金术
2.4 淘洗动作:维特比与束搜索的淘金术
本节摘要:解码是在概率地图上找最优路径的搜索问题。维特比算法用动态规划保证"全图精确最优",束搜索用宽度换速度保证"工程可用",词格则是搜索过程顺手留下的副产品。本节把三者的机理与参数讲透,是第 5 章解码实操的理论前站,也是第 2 章的收口。
一盘沙子怎么淘
一盘沙子要淘出金子,笨办法是把所有可能的砂粒组合都试一遍。解码面对的正是这种组合爆炸:一句话几百帧,每帧可能对应几十个状态,路径总数随帧数指数增长,全宇宙的算力也穷举不完。好消息是这张概率地图有特殊的结构——时间只能向前流,每个格子只能从上一帧的有限个格子走来。利用好这种结构,就诞生了两大淘洗术。
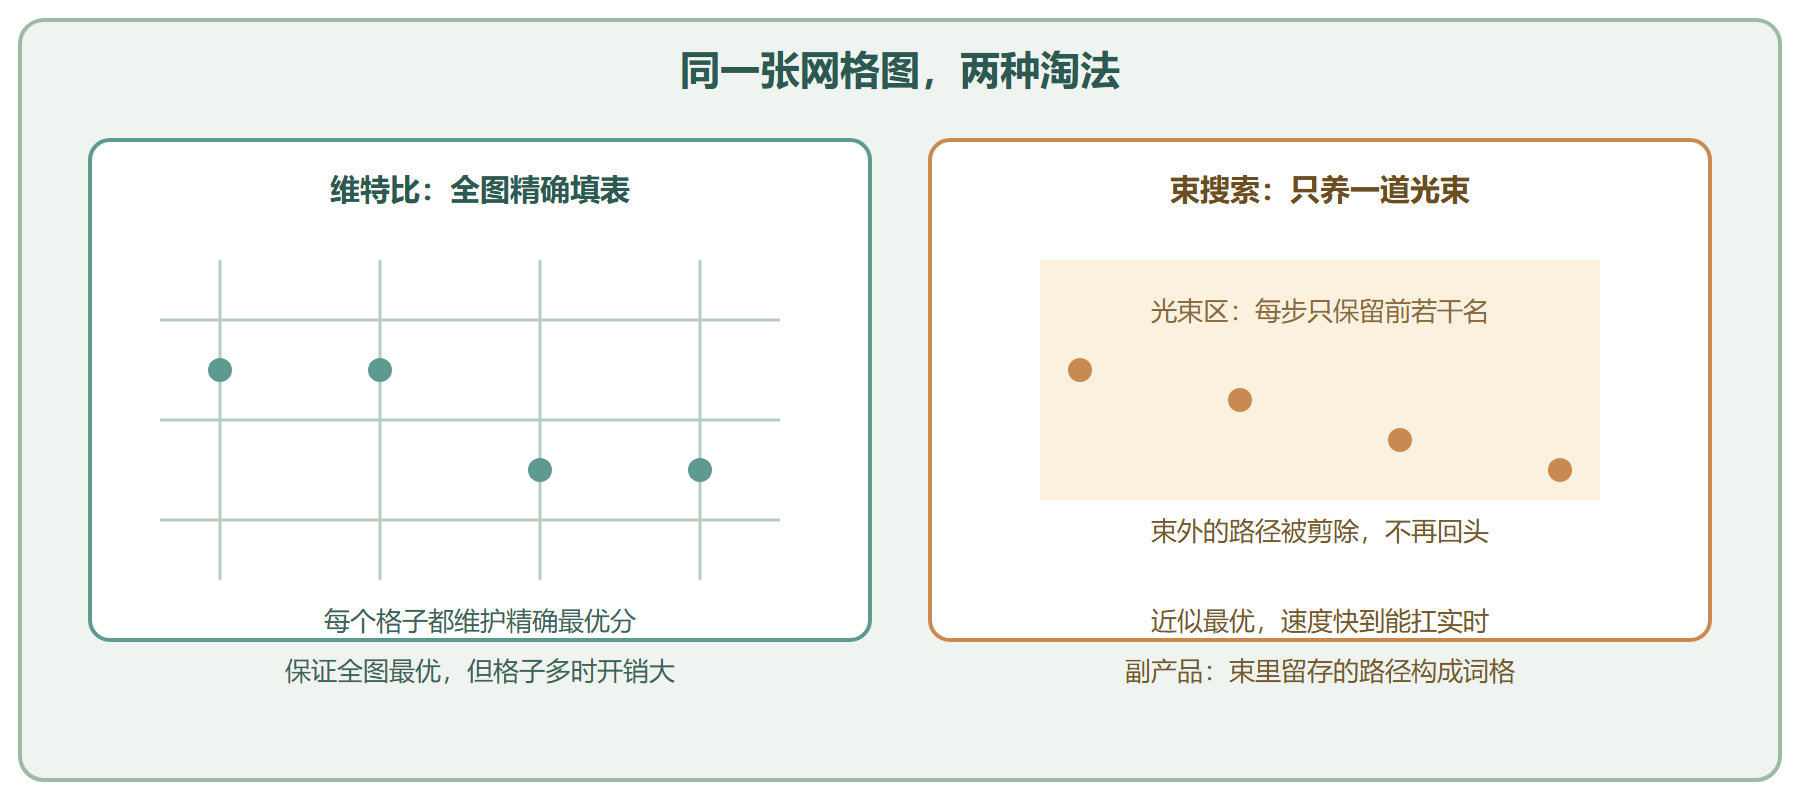
第一术是维特比算法,2.2 节已用五帧玩具算过一遍,这里把直觉再压缩一次:到任何一个格子的最优路径,必然由"到前一行某格子的最优路径"延伸而来。于是逐行填表,每格只记一个最优分数与一个回溯指针,整张表填完,最优路径自动浮出。计算量从指数级降到行数乘列数的乘积级,这是动态规划送给识别领域的礼物。
维特比给的是精确最优,但它有个隐含前提:图里每个时刻的状态集合不能太大,否则表本身放不下。真实解码图动辄几百万状态,逐格维护精确分数的内存与时间开销仍然吃不消,于是第二术登场——束搜索。
束搜索:只淘有希望的那条矿脉
束搜索的思路朴素:每一轮把所有活着的路径按分数排队,只保留前若干名,其余直接淘汰。保留的集合像一道随时间推进的光束,故称束。被淘汰的路径理论上仍有翻身可能,但经验表明分数垫底的路径几乎不可能最终登顶,舍弃它们换来的速度非常划算。
# 玩具束搜索:字表三个候选,每步只留前两条路径 import math vocab = {"识", "食", "实"} # 每一步的候选字 beams = [("", 0.0)] # 初始:空路径,分数为零 trans = { # 一步的"语言分"假设值(对数域) ("", "识"): -0.1, ("识", "语"): -0.2, ("识", "雨"): -1.2, ("食", "语"): -0.3, ("实", "雨"): -0.9, } # 为演示简单,声学分统一设为 -0.5 for step in range(2): cands = [] for prefix, score in beams: for w in vocab: s = score - 0.5 + trans.get((prefix[-1:] if prefix else "", w), -2.0) cands.append((prefix + w, s)) cands.sort(key=lambda x: -x[1]) beams = cands[:2] # 束宽为二:只留前两名 print(f"第 {step+1} 步保留:", beams) # 输出: # 第 1 步保留: [('识', -0.6), ('食', -1.1)] # 第 2 步保留: [('识语', -1.3), ('食语', -1.6)] # 解读:'实' 起步分数垫底被剪掉, # '雨' 因语言分太低从未进过束——这就是剪枝在干活
数一数这段代码的账:字表三个、步数两步,穷举九条路径;束宽二让每步只养两条活路径,搜索量被压住。束宽越大,保的路径越多,结果越接近精确最优,代价是速度线性变慢。真实解码器里的束宽以百计,配合"最大活跃路径数"一起控制内存。
图 维特比全图与束搜索光束的对照
词格:淘洗过程顺手捞的副产物
束搜索每一步都养着一批活路径,结束时如果不止留一条,而是把所有高分的存活路径连同分数一起打包,就得到了词格——一张记录着"哪些词序列曾被认真考虑过"的压缩地图。它的价值在第 5 章会充分展开:换语言模型重新打分、抽候选列表、做置信度分析,原料都是它。可以说维特比给你金锭,束搜索还附赠尾矿。
解码器内部:令牌怎么跑
工程实现里,束搜索常用"令牌传递"来落地。想象每个活跃路径是一枚令牌,令牌上刻着累计分数与来历。每一帧到来时,令牌沿着解码图的弧向前跳,跳一步吃一次声学分与语言分,跳完清点所有令牌,分数垫底的没收,留下来的继续跑。网格图上抽象的"格子",在实现里就是令牌停留的图节点;所谓束宽,就是每轮清点后允许存活的令牌名额。
这个视角把两件看似无关的事统一了:解码图的规模决定令牌能跳多远,束宽决定令牌留多少。第 5 章讲解码图组装时会看到,图的规模动辄几十万节点,而令牌同时只养几千枚——图是全部可能性,束是当下的注意力,解码就是注意力在可能性地图上的移动过程。
从玩具到真实:网格图换成解码图
玩具例子里的网格是整齐的矩阵,真实解码图远比它崎岖:词与词之间隔着静音弧,静音可以在任何词边界停留任意时长;每个词内部又展开成音素状态链;跳过某个词的捷径弧也存在——人说话会吞词。维特比与束搜索的算法完全不变,变的只是"格子"的连接方式。这也是为什么第 5 章要先花一整节组装解码图:搜索算法早熟,图的工艺才是解码质量的另一半。
参数速查与工程手感
解码速度与质量的平衡,全落在几个参数手里。把它们当成矿场的秤与阀,调之前先知道各自管什么:
参数 默认量级 管什么 调大的后果 束宽 十到二十级 搜索的宽度 更准但更慢 最大活跃路径数 数千 同时存活的路径总数上限 内存与时延上升 语言模型权重 十上下 语言分与声学分的配比 句子更通顺、内容更保守 词插入惩罚 零附近 抑制多吐词 减少插入错误 最大词格深度 数十 词格每节点保留的弧数 词格更肥、重打分余地更大
手感是试出来的。实践套路是先固定其余参数,只动一个,画一条"参数对错误率"的曲线,找拐点而不是极值点。语言模型权重与词插入惩罚常常联动调整,前者管分数量纲,后者管输出长度,两个一起动容易看不出各自贡献。另外记住评估集要够分量,几十句话的测试集上,一两个词的波动就能把参数结论整个翻转,调参前的第一件事往往是先把评估集做扎实。
⚠️ 常见坑:把束宽调小当加速手段却在小测试集上看效果。束搜索的损失在困难长句上才显现,短句浅任务上几乎无感,结论容易下反。评估调参必须覆盖长句与噪音频段。
💡 关键直觉:解码器里真正的哲学是"尽早剪掉明显没戏的路径"。这一思想从束宽到词格深度一以贯之,理解了它,参数表就不是死记的表格,而是一组可推导的旋钮。
带走四句话
- 维特比是精确解:靠时间结构与最优子结构,把指数搜索压成多项式填表。
- 束搜索是工程解:宽度换速度,损失可控,副产品是词格。
- 参数各有管辖:束宽管搜索,语言权重管配比,插入惩罚管长度,别混着调。
- 一次只动一个秤砣:调参纪律比调参技巧重要。
至此第 2 章的四块积木讲完。下一章回到地面:真实语料的登记、筛分、化验与建图谱,是把这些理论喂进机器之前的全部杂活。