2.3 淘金手感:语言模型与发音词典
2.3 淘金手感:语言模型与发音词典
本节摘要:语言模型为词序列提供"像不像人话"的先验概率,发音词典把词拆成音素序列,两块知识源在音素这个接口上与声学模型会合。本节讲清 n 元语法的条件概率直觉、平滑与回退的必要性、困惑度的读法、神经语言模型的增益方式,以及词典与音素集设计的自由度。承接 2.2 的声学积木,通往 2.4 的解码算法。
老矿工的矿脉笔记
英语圈有个流传甚广的例子:同一串声音,既可以听成"recognize speech"(识别语音),也可以听成"wreck a nice beach"(毁掉一片好海滩)。两句的音素序列几乎相同,声学模型根本分不出高下,但任何人都会选前一句——因为后者作为指令荒谬透顶。这份"什么话配出现在什么场合"的判断力,就是语言模型。它像老矿工的矿脉笔记:单看一块矿石认不准成色,知道这片矿脉的走向,判断就稳了。
词打错了也念得通?给个中文的对照实验:"我在故宫博物院看展览"与"我在故宫博物院看斩览",声学分数可能接近,但"斩览"在任何语料里几乎不出现,语言分数一票否决。识别系统的稳健性,一半来自声学,一半来自这份语感。
n 元语法:把语感写成条件概率
语言模型的任务是给一个词序列算概率。整句连乘不可行,简化假设登场:下一个词只依赖前面有限的几个词。只看前一个词叫二元语法,看前两个叫三元语法。条件概率直接从语料数频次估计:"的"后面接"时候"的次数,除以"的"出现的总次数。简单粗暴,但在数据充足时出奇地有效。
阶数越高,能捕捉的搭配越远,代价是组合爆炸与数据稀疏——三元组合百万计,四元组合上亿计,而语料永远不够大。工程默认从三元起步,重要任务上到四五元,再往上性价比骤降。
| 阶数 | 能捕捉的语言现象 | 参数量级 | 数据需求 |
|---|---|---|---|
| 一元 | 词频本身 | 词表规模 | 小语料即可 |
| 二元 | 相邻搭配 | 词表平方量级 | 中等语料 |
| 三元 | 一步的隔词影响 | 词表立方量级 | 大语料 |
| 四元及以上 | 更远依赖 | 急剧膨胀 | 海量语料加平滑 |
零概率是 n 元语法的死穴:只要某个搭配在训练语料里没出现,整句概率直接归零,再通顺的句子也会被判死刑。平滑技术负责把概率质量从常见搭配匀给没见过的搭配,回退策略则在高阶组合缺失时退回低阶估计。这两样不是可选优化,是 n 元语法能用的前提。
模型文件常用 ARPA 格式存放,看一眼真实格式,平滑与回退就落地了:
# ARPA 三元语法片段(节选,注释为后加) \data\ ngram 1=6 # 一元条目数 ngram 2=6 # 二元条目数 ngram 3=2 # 三元条目数 \1-grams: -2.3010 识别 -0.5 # 对数概率 词 回退权重 -1.9031 语音 -0.6 -3.0000 展览 -0.4 \2-grams: -1.2000 识别 语音 -1.5000 语音 展览 \3-grams: -0.7000 识别 语音 展览 \end\ # 解读:对数域存储避免下溢;回退权重在低阶条目上, # 高阶查不到时按它退回低阶概率
困惑度:给语感称重
语言模型的好坏用困惑度衡量,直观理解是"平均每一步在多少个词里犹豫"。困惑度从一百降到八十,相当于每步的犹豫范围缩水两成,解码时瞎撞的空间随之缩小。两个要点值得记住:其一,困惑度必须在同词表、同测试集上比较才有意义;其二,困惑度下降通常带来错误率下降,但不是线性关系,后期改进的收益会越来越薄。
神经语言模型:语感升级
n 元语法只记得住固定窗口,稍远的依赖就失忆。循环神经网络语言模型把"前文"压缩成一个隐状态随身携带,理论上能记住整句语境,困惑度普遍比 n 元低一截。代价是逐词计算慢,不适合塞进解码图里实时用。
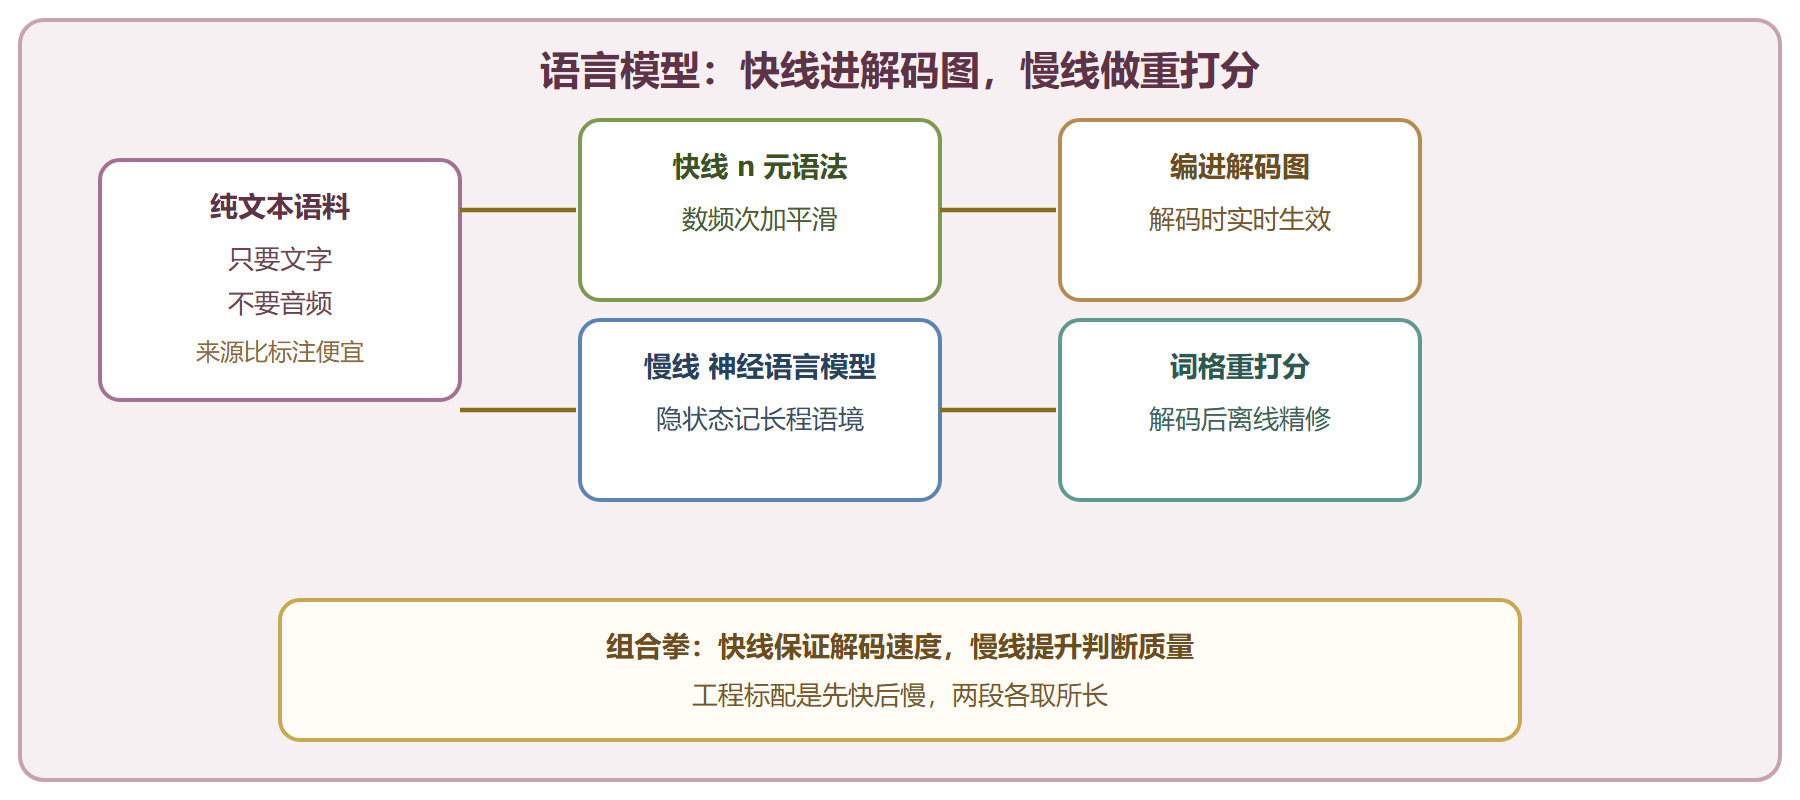
工程上的和解方案是两段式:先用 n 元语法跑一遍解码生成词格(候选句子的压缩表示,详见第 5 章),再用神经语言模型对词格里的候选路径重新打分,好答案从候选池里被捞出来。这一手叫词格重打分,花小钱办大事,是第 6 章增产工具箱里的常客。
# 两段式重打分的玩具演示:词格存了三条候选路径 paths = { "识别 语音 展览": {"acoustic": -30.2, "ngram": -8.5}, "识别 雨 展览": {"acoustic": -29.8, "ngram": -9.9}, "识别 语音 斩览": {"acoustic": -30.0, "ngram": -9.4}, } # 第一段:n 元语法已经选出了第一条路径 best_ngram = min(paths, key=lambda p: paths[p]["acoustic"] + paths[p]["ngram"]) # 第二段:神经语言模型给出更准的语言分(假设值) rnnlm_scores = {"识别 语音 展览": -6.1, "识别 雨 展览": -12.7, "识别 语音 斩览": -13.3} best_rnnlm = min(paths, key=lambda p: paths[p]["acoustic"] + rnnlm_scores[p]) print("n 元选出:", best_ngram) # 输出:识别 语音 展览 print("重打分后:", best_rnnlm) # 输出:识别 语音 展览(优势被放大) # 解读:好路径在神经语言模型下分数更高, # 差路径被进一步压低,候选池的排序更可靠
图 语言模型两条供给线与重打分流程
发音词典:词与音素的换算表
声学模型只认音素,应用层只认词,词典就是两张货币之间的汇率表。每行一个词条:词、音素序列,可附加音素变体应对一词多音。
# 词典片段(示意,注释为后加) 识别 sh i2 b i4 # 词 音素序列,带声调标记的中文音素 语音 y u3 y i1 展览 zh an3 l an3 yesno Y EH S N OW # 英文词同理,换一套音素表 <sil> SIL # 静音条目:词典也要收录"没话"的发音
词典的编写自由度比想象中大。切多大粒度算一个"词"(整词、子词、字)由任务定:小任务直接整词入库,大词表任务用子词拆解以控制规模;音素集是自定的符号系统,只要训练与解码用同一套,叫什么名字都行。真正不可妥协的是三条硬约束:文本标注里的每个词都必须能在词典里查到;词典里的每个音素都必须在音素表里注册;静音与噪声条目要显式建模,不许凭空消失。
💡 关键直觉:语言模型的词表、词典的词表、训练文本的词表,三者必须对齐成一套账本。三张账本对不上的典型症状是:训练时大量词被当成词典外词丢弃,模型学到的东西比语料少一截。词典外词的治理是数据准备的重头戏,第 3 章专门处理。
带走五句话
- 语言模型是先验不是补丁:它在打分阶段介入,与声学分数相乘(对数域相加)共同决定路径。
- 平滑回退是命门:没有它们,没见过的搭配直接判零,整句报废。
- 困惑度看相对值:同词表同测试集才能比,绝对数字没有跨任务意义。
- 两段式是工程正解:n 元进解码图保速度,神经模型重打分保质量。
- 词典是汇率表:词表、音素表、文本标注三张账本必须一致。
三块知识源到齐,下一节看解码器怎么把它们组装成一张概率地图,并在图上把最优路径淘出来。