3.1 矿石登记造册:数据目录规范与数据集划分
3.1 矿石登记造册:数据目录规范与数据集划分
本节摘要:Kaldi 数据目录靠五份清单文件说话——音频映射、转写标注、说话人映射、反向索引、录音分段。格式是铁律,校验是闸门。本节逐份拆解清单格式,示范把自制语料登记入册的完整过程,并讲清数据集按说话人划分的原则。承接第 2 章的原理地基,是第 3 章备矿的第一道工序。
学习目标
阅读完本节,你应当能够:
- 手工写出五份清单的合法示例行,说明每列的含义
- 用校验与修复脚本体检并修复一个数据目录
- 解释话语标识与说话人标识的命名约定及其用途
- 按说话人把语料切成训练、开发、测试三份,并说明为何不能按句切
一、五份清单:数据目录的账本
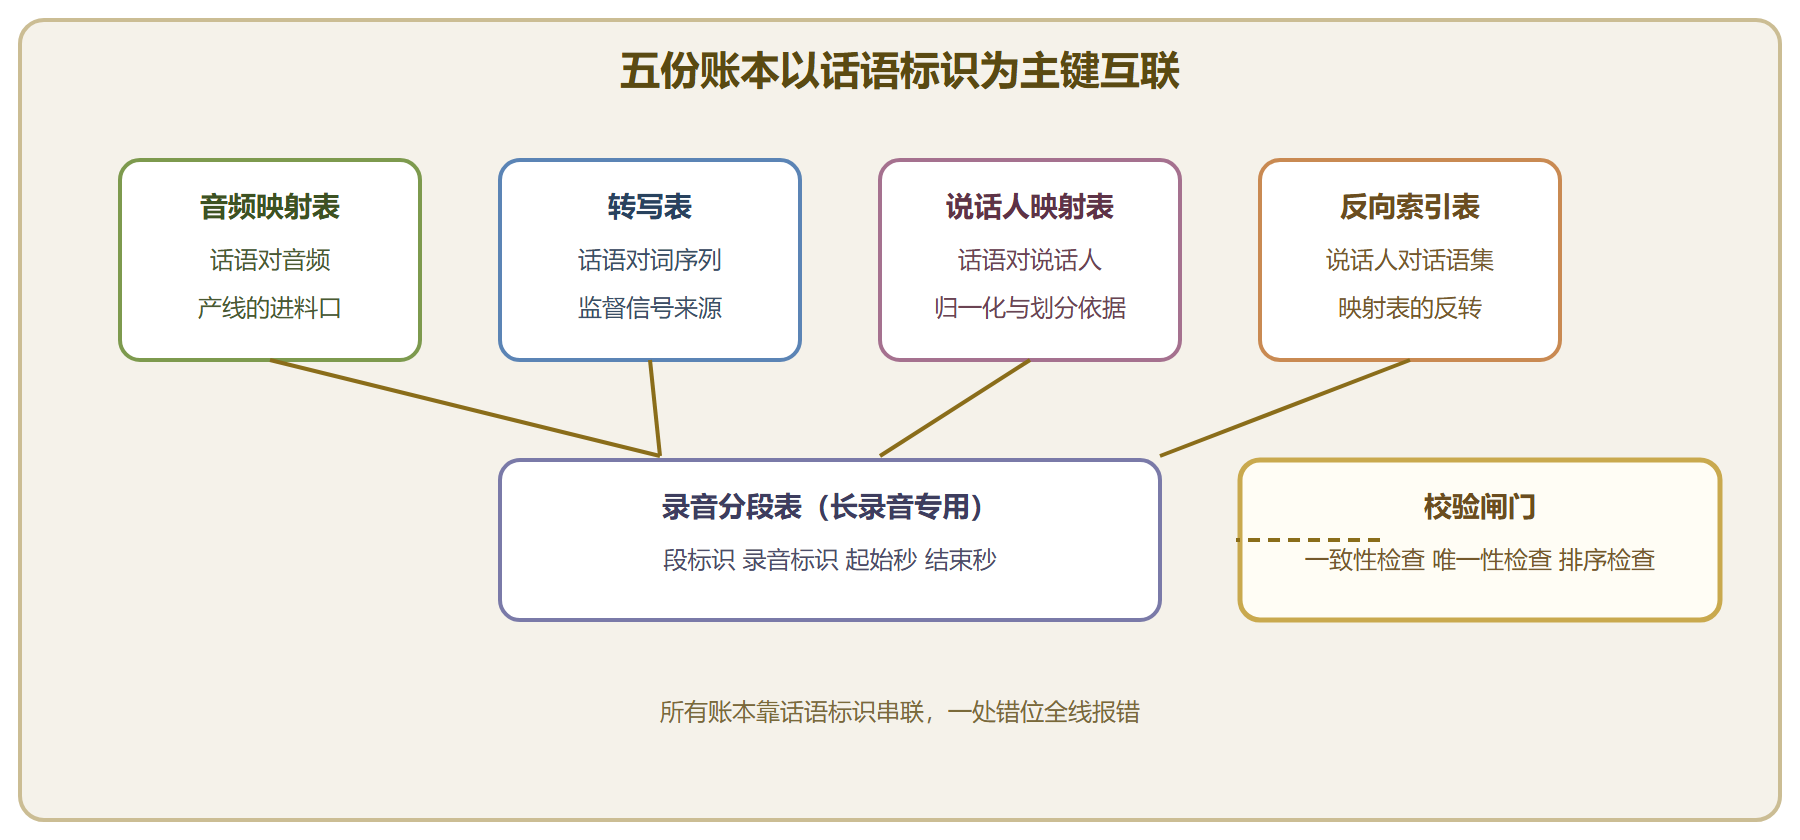
矿场收矿先登记,Kaldi 收数据也是。一个数据目录就是一堆清单文件,每份清单一行一条记录,字段间用空格分隔,键在前值在后。四份必备清单构成基本账本:音频映射表记录"哪句话对应哪个音频",转写表记录"哪句话说了什么",说话人映射表记录"哪句话是谁说的",反向索引表按说话人汇总话语清单,是第三份表的反转视图。
# 音频映射表:话语标识 音频来源(本地路径或管道命令) speakerA_0001 /data/wav/speakerA_0001.wav speakerA_0002 /data/wav/speakerA_0002.wav # 转写表:话语标识 逐词转写(词与词典对应) speakerA_0001 今天 天气 不错 speakerA_0002 明天 继续 训练 # 说话人映射表:话语标识 说话人标识 speakerA_0001 speakerA speakerA_0002 speakerA # 反向索引表:说话人标识 该说话人的全部话语标识 speakerA speakerA_0001 speakerA_0002
两份账本之间有几条隐含的契约。话语标识全局唯一且贯穿所有清单;转写表里的词必须能在发音词典里查到;说话人标识在反向索引里出现的话语集合,必须与映射表完全互逆。校验脚本检查的就是这些契约,一个字段的错位都会被揪出来。
第五份清单是录音分段表,长录音场景专用。一场两小时的会议录音是一个音频文件,但里面有几百句话,登记时用分段表把每句的起止时间切出来:一行一段,记录段标识、所属录音、开始秒、结束秒。有分段表时,音频映射表的键从话语换成录音,话语与音频的对应关系交由分段表完成。短录音一句一文件的语料用不着它,但真实项目里"先录长音频再人工切分"的做法很常见,这份清单就绕不开。
话语标识的命名习惯值得遵守:说话人前缀加序号。好处一望而知——看名字就知道归谁管,按说话人筛选时一行文本处理就够。标识里避免空格与特殊符号,只用字母数字加下划线,能省去无数转义麻烦。
图 数据目录账本关系与校验闸门
二、实操案例:把三十条自制录音登记入册
背景:你用手机录了三十条短句,每句一个音频文件,另有一份逐句文本。目标:产出能通过校验的数据目录。操作分四步,每步都有验收点。
第一步统一音频格式。手机录音常是四万八千赫兹采样、双声道,产线偏好一万六千赫兹单声道,用通用音频工具批量转换。第二步生成清单,从文件名提取说话人与序号拼出话语标识,文本按行对齐生成转写表。第三步生成说话人映射与反向索引。第四步过闸门。
# 第二步与第三步的生成脚本(在语料目录内执行) cd /data/my_corpus for f in wav/speakerA_*.wav; do utt=$(basename "$f" .wav) # 话语标识取文件名 spk=${utt%%_*} # 下划线前是说话人标识 echo "$utt /data/my_corpus/$f" >> wav.scp echo "$utt $(cat txt/$utt.txt)" >> text echo "$utt $spk" >> utt2spk done # 反向索引用现成工具从映射表反转生成 utils/utt2spk_to_spk2utt.pl utt2spk > spk2utt wc -l wav.scp text utt2spk spk2utt # 预期输出:四个文件的行数完全一致(各三十行)
结果:四份清单行数一致,进入闸门。
# 第四步:体检与修复 utils/validate_data_dir.sh data/my_train # 若输出报错清单(如某条话语在转写表缺失), # 先修数据再复检;全部通过时输出成功提示 utils/fix_data_dir.sh data/my_train # 预期输出(健康时): # 不一致条目数为零,目录排序与索引重建完成
解读行数一致这个验收点:四份账本以话语标识为主键,任何一份多行少行都意味着主键失配。修复脚本的策略是"宁缺毋滥"——把对不上的条目整行丢弃并报告数量,丢三五条是数据噪音,丢一半就是生成脚本有毛病,要回到上游查。
变式:如果音频是长录音,第二步改为生成分段表,音频映射表的键换成录音标识,其余流程不变;如果转写文本里混有标点与英文缩写,先去做 3.3 节的文本治理,再回来登记。
三、划分矿区:训练、开发、测试三份地
登记完的语料要切成三份:训练集喂模型,开发集调参数,测试集只在最后称重。常用比例大约八比一比一,小语料可以七比一比半成灵活调整。划分的关键原则只有一条:按说话人切,不按句子切。同一个人的声音进了训练集又进测试集,等于考试前发过答案,开发集上的错误率会漂亮得虚假,上线后原形毕露。
# 按说话人切分的核心逻辑(示意脚本) cut -d' ' -f2 utt2spk | sort -u > all_speakers # 随机抽取一成说话人做开发集,再抽一成做测试集 shuf --random-source=<(yes 42) all_speakers > shuffled head -n 3 shuffled > dev_spk sed -n '4,6p' shuffled > test_spk # 按说话人名单过滤四份清单,分别写入三个目录 for split in dev test; do grep -F -f ${split}_spk utt2spk > data/${split}/utt2spk # 其余三份清单按同一批话语标识过滤…… done # 剩下的说话人全部归训练集
⚠️ 常见坑一:转写表里的词与词典对不上。登记时不查词典,训练时才会发现一堆词典外词,返工成本高数倍。坑二:把测试集当开发集反复调参,指标虚低(虚好),真测试时大跌眼镜。坑三:说话人跨集泄漏,自查方法是把三个集合的说话人名单两两求交集,交集必须为空。
💡 关键直觉:数据目录的价值在于"可校验"。手写清单的自由度看着大,实际上你只是在填一张关系型数据库的表——主键是话语标识,外键是说话人标识与音频来源。用数据库的眼光看清单,格式要求就不再是死记的规矩。
本节要点回顾
- 五份清单一个主键:话语标识贯穿全部账本,行数一致是最低验收线。
- 校验先于训练:闸门不过,后面所有工序都在给错误数据镀金。
- 划分按说话人:防止声音泄漏导致的虚假指标,三集合说话人交集必须为空。
- 命名即元数据:标识前缀带说话人,一行文本处理就能完成按人筛选。
登记入册的矿石还是原始波形,下一站破碎筛分:波形怎么变成声学模型爱吃的向量串。