3.2 破碎筛分:MFCC 与 FBank 特征提取、CMVN 均质
3.2 破碎筛分:MFCC 与 FBank 特征提取、CMVN 均质
本节摘要:特征提取把连续波形磨成向量串——分帧加窗、算谱、梅尔滤波、取对数,再到倒谱或滤波器组两组特征,最后用倒谱均值方差归一化抹平信道差异。本节讲透每道子工序的参数与动机,给出配置文件与验收命令,并说清两组特征的选型依据。承接 3.1 的登记入册,为第 4 章训练备料。
把大石头磨成细沙
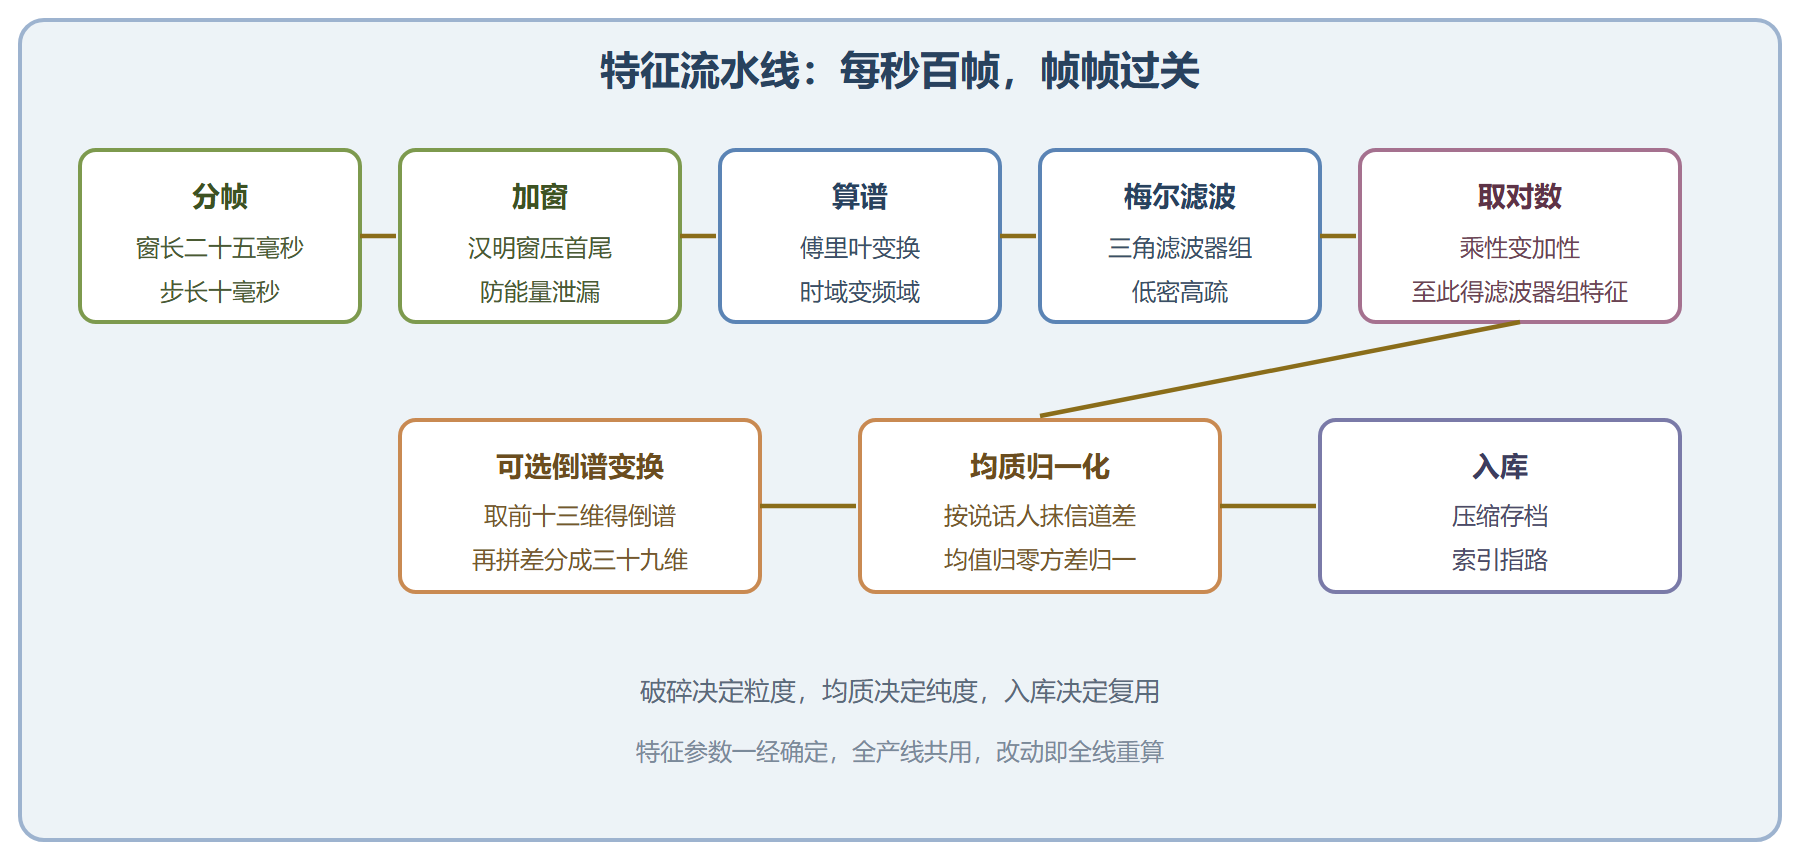
登记入册的矿石还是整块的:一段几秒的波形,是个上万点的数字序列。声学模型消化不了这么粗的料,破碎筛分的第一步是分帧——按固定窗长切窗,窗与窗之间错开一小步。通行参数是窗长二十五毫秒、步长十毫秒:每秒音频出一百帧,每帧四百个采样点(按十六千赫兹算)。窗长决定"每口嚼多大",步长决定"嚼多密",两个参数写进配置文件,全产线共用。
分完帧要加窗。直接截断的帧在首尾有突变,谱能量会泄漏到别的频段,像筛子漏砂。窗函数(常用汉明窗)把每帧首尾平滑压到零,谱就干净了。加窗之后做傅里叶变换,时域的一帧变成频域的一条能量分布曲线——矿砂被磨出了成分谱。
接下来是梅尔刻度的滤波器组:在频轴上铺一排三角形滤波器,低频密、高频疏,模拟人耳对音高的非线性感知——低频的细微差别人耳分得清,高频要差很多才察觉。每帧的谱经过这排滤波器,压缩成几十个频带的能量。再取对数,把乘性关系变成加性关系,也把动态范围压到模型好处理的量级。
到这一步得到的向量串叫滤波器组特征(常记作 FBank)。在它基础上再做一次离散余弦变换,把能量分布的"包络"与"细节"分开,取前若干维,就是梅尔倒谱系数(MFCC)。一次变换,两种产品:滤波器组保留全部频带能量,信息更足;倒谱压缩了维度、相邻维去相关,更适合高斯模型这类假设各维独立的打分器。
图 破碎筛分流水线:从波形到入库特征
差分与拼接:给特征加上时间感
单帧特征是静态照片,听感里大量信息藏在变化里——音素的边界、语调的走向。差分特征补的就是这一维:每帧前后各取几帧同维数值,按权重相减,得到"这一维正在变快还是变慢"的一阶差分;对差分再差一次,得二阶差分。十三维倒谱拼上两个差分,三十九维向量才是喂给经典模型的完整口粮。
滤波器组特征通常不拼差分(神经网络自己看得见上下文帧),但会拼其他辅助特征:基频、能量、说话人向量。拼接的通用逻辑是"把不同来源的向量按维并排",第 6 章讲自适应时还会用到这一手。
均质:CMVN 抹平信道差异
同一句话,会议室麦克风录的与手机录的,特征分布能差出一截——信道、麦克风、说话人嗓音条件的差异都叠在特征上。倒谱均值方差归一化的做法直白:对每个说话人(或每条录音)的全部帧,逐维减均值、除标准差。信道的影响大多表现为乘性偏置,落在对数域就是加性偏移,减均值正好抵掉。
归一化的粒度是说话人级——这正是 3.1 节坚持登记说话人映射的原因之一。没有说话人信息就只能按录音归一,短录音的统计量不稳,效果打折。另一种更强的是基于模型的自适应(第 6 章展开),入门阶段掌握说话人级归一化已够用。
配置与验收
特征参数集中在配置文件里,一份配置一个产出口径。看懂一份真实的配置:
# 特征配置(放在食谱的配置目录内) --use-energy=false # 不用能量维,改用零阶倒谱 --num-mel-bins=23 # 梅尔滤波器个数:二十三为经典值 --num-ceps=13 # 保留前十三维倒谱系数 --low-freq=20 # 滤波下限:二十赫兹以下无语音信息 --high-freq=7600 # 滤波上限:十六千赫兹采样时约七千六 --sample-frequency=16000 # 采样率口径,与音频实际一致
提取与归一化两步走,然后验收帧数:
# 提取特征并算归一化统计量(在食谱目录内) steps/make_mfcc.sh --nj 4 --mfcc-config conf/mfcc.conf data/my_train steps/compute_cmvn_stats.sh data/my_train # 预期输出:进度条走完,数据目录下新增特征索引与统计量索引 # 验收:看某句话的特征到底有多少帧、多少维 feat-to-len scp:data/my_train/feats.scp ark,t:- | head -n 3 # 预期输出(示例): # speakerA_0001 217 # speakerA_0002 184 # speakerA_0003 256 # 每行是话语标识加帧数,帧数应约等于音频秒数乘一百
帧数验算是道便宜的保险:一句两秒的话出二百帧上下,对不上就是采样率或配置出了问题。特征本体存在压缩档案里,索引文件只记"哪句话的特征在哪一段",训练时按索引随机读取,几万小时语料也能高效访问。
存储细节还有两处值得知道。其一,特征在档案里默认做了有损压缩(类似把浮点压成低精度整数再存偏移),体积缩到约三分之一,精度损失对训练无可感知影响,但若要做特征级数值实验,记得有"无损拷贝"选项。其二,多路并行提取时每路各写一个档案,索引文件自动合并——所以并行度随手调,不会乱账。这两处平时不必惦记,排查"特征数值怎么对不上"类问题时才用得上。
差分之外的另一种补时间感的思路也顺带交代:与其手工拼差分,不如让模型直接看前后几帧——神经网络时代普遍这么干,这也解释了为什么滤波器组特征搭配网络时不再需要差分。旧工艺为新工艺让路,但"给模型时间上下文"这个需求本身从未变过。
选型:倒谱还是滤波器组
| 维度 | 梅尔倒谱 | 滤波器组特征 |
|---|---|---|
| 维度 | 十三维加差分,共三十九 | 通常四十到八十维 |
| 去相关 | 有(离散余弦变换的功劳) | 无,各维相关性强 |
| 信息保留 | 丢掉部分谱细节 | 全频带能量都在 |
| 经典搭档 | 高斯混合模型 | 神经网络类模型 |
| 对卷积噪声 | 较稳 | 更敏感,靠归一化补 |
选型经验一句话:走高斯混合老路线用倒谱,走神经网络新路线用滤波器组。神经网络不怕维间相关,反而嫌倒谱把信息压丢了。链式模型时代干脆普遍改用滤波器组,第 4 章的训练流程会看到这条分界线。
⚠️ 常见坑一:改了特征配置忘了重算,新旧特征混在一个目录里,训练日志的似然值会莫名跳动。坑二:采样率口径不一致,配置写一万六、音频实际四万八,帧数验算直接露馅。坑三:归一化统计量缺失或粒度错乱,症状是某几个说话人的识别结果系统性变差。
工序交接单
- 粒度三参数:窗长、步长、滤波器个数,写进配置,全产线一个口径。
- 两代特征两条路:倒谱配高斯,滤波器组配网络,别串台。
- 归一化靠说话人:映射表登记不全,均质这道工序就残废。
- 帧数验算是最便宜的质检:一除一比,采样率与配置错误当场现形。
特征入库,下一道工序伺候标签:转写文本里的标点、数字、生僻词,怎么治理成与词典对齐的干净标注。