3.3 化验单治理:文本归一化与词典外词处理
3.3 化验单治理:文本归一化与词典外词处理
本节摘要:转写文本是监督信号的化验单,脏得超乎想象——标点、数字、全半角、生僻词、英文缩写混在其中。本节给出归一化的规则清单与落地脚本,讲透词典外词的三种处置策略与覆盖率检查,把"标注"治成与词典严格对齐的"口粮"。承接 3.2 的特征入库,通往 3.4 的词典构建。
化验单上的乱码
先看一份真实的原始转写,感受一下什么叫"没法直接喂":
# 原始转写(手机语音输入的典型形态) 呃,今天这个会是第3次的吧?time是下午2点。 Lily那边说budget可能要砍20%…… 你把PPT发我一下,谢谢!
四句话,问题凑齐了一桌:语气词与重复口头禅、阿拉伯数字、中英混排、标点连写、英文人名与缩写。声学模型要的是"说出口的词的序列","3"不是词,说出口的是"三";"呃"要不要建模得有明确决策;"budget"得先确定读音进词典。文本治理要做的,就是把这张化验单洗成产线能吃的形态。
治理的目标口径只有一条:文本里出现的每个符号,都必须是词典里登记过发音的词。达不到这条,训练时轻则丢词、重则整句被弃。
图 文本治理工序与词典外词的三条出路
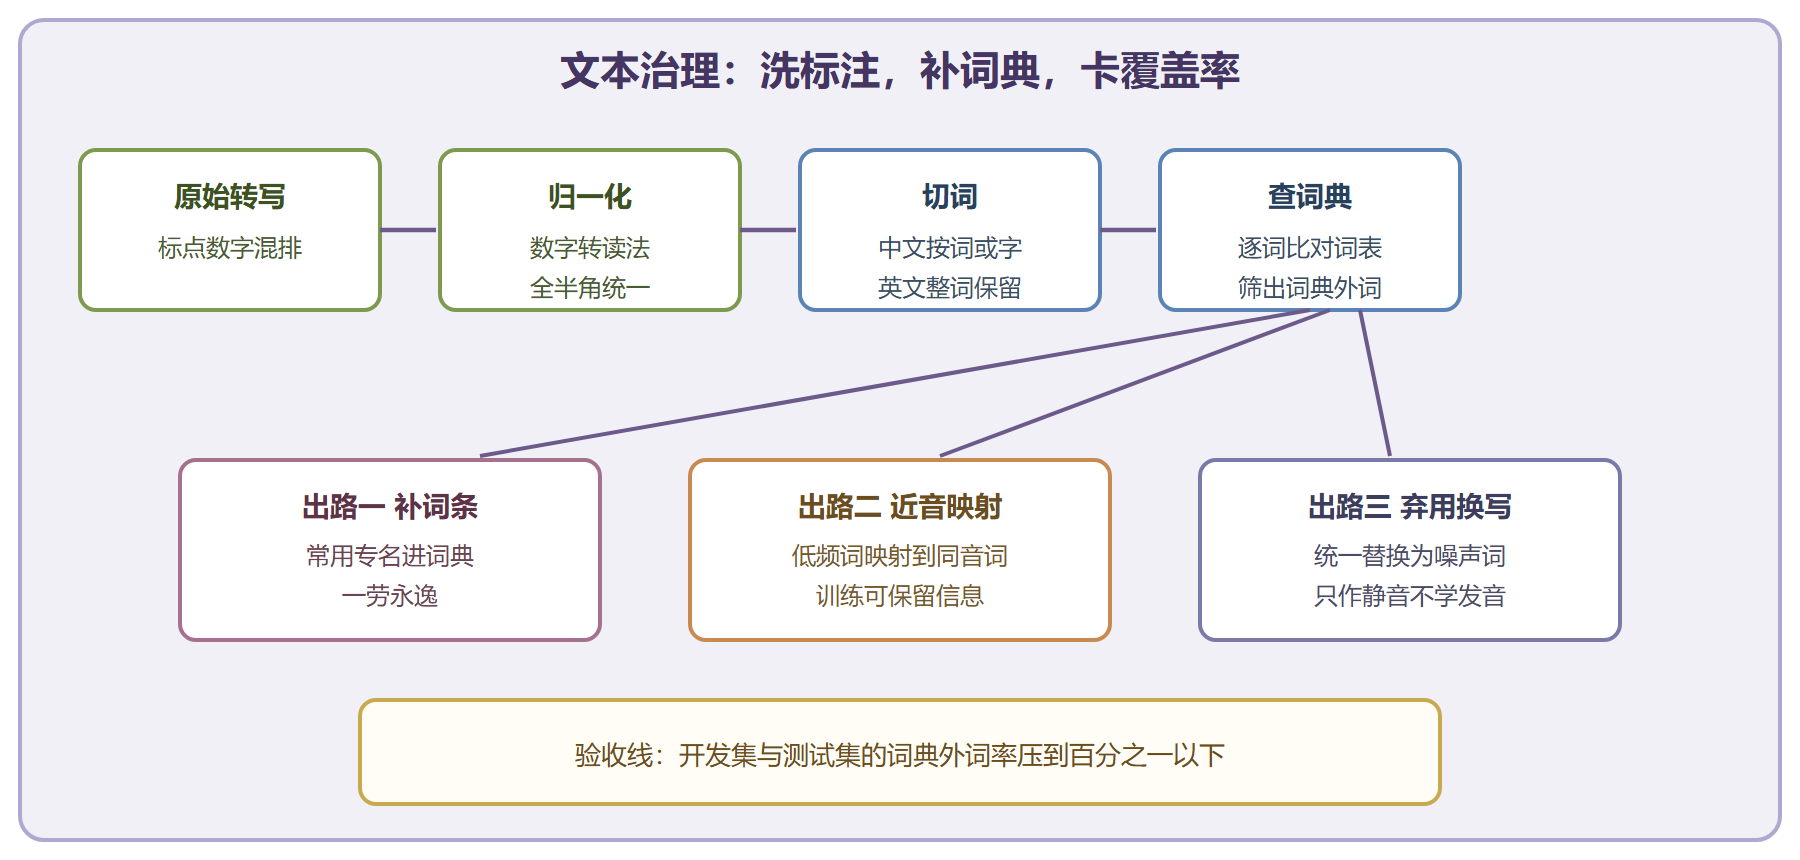
归一化规则清单
把治理动作列成规则,逐条有依据,执行才有章法。
# 文本归一化脚本骨架(示意,规则按任务增删) import re def normalize(line: str) -> str: # 第一步:全角转半角(数字与字母统一口径) line = line.translate(str.maketrans( "0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ", "0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ")) # 第二步:去标点(训练文本不要标点,模型不学标点发音) line = re.sub(r"[,。?!、;:,.?!;:…]", " ", line) # 第三步:数字转读法(简单版:逐位转中文,复杂版按数额规则) line = re.sub(r"\d", lambda m: "零一二三四五六七八九"[int(m.group())], line) # 第四步:语气词策略(示例:句首呃删除,句中保留待定) line = re.sub(r"^呃\s+", "", line) # 第五步:压空白,多个空格合一 return " ".join(line.split()) for raw in ["呃,今天这个会是第3次的吧?", "你把PPT发我一下,谢谢!"]: print(normalize(raw)) # 输出: # 今天这个会是第三次的吧 # 你把PPT发我一下 谢谢
规则之外还有两个大决策。其一,语气词建模与否:目标若是识别自然口语,呃嗯啊要进词典并标注;目标若是朗读式识别,删掉更省事——但删掉的词对应的音频段必须同时处理,否则文本与音频对不齐。其二,中文切词粒度:按词建模词表大、语言模型准,按字建模词表小、生僻字免疫,工程上常用折中——高频词整词、低频内容拆字。
英文混排的治理容易轻敌:大小写统一成小写还是保留(缩写词有意义)、连字符拆不拆、撇号词(缩写形式)展开与否,都要写成固定规则。规则不怕简单,怕的是同一批语料前后用了两套。
词典外词:三种处置与一条验收线
词典外词指文本里出现、词典里没有的词。来源无非几类:专名与术语、错别字、生僻低频词、外来语。处置策略按频率分流:高频外词(往往是任务核心词)补进词典;低频外词映射到发音相同的已有词;实在不值得管的,统一替换成噪声词,模型把它当杂音处理。
覆盖率检查是这道工序的验收闸门,量化回答"词典够不够用":
# 统计开发集的词典外词率(示意流程) # 第一步:合并训练文本建词表 cat data/my_train/text | awk '{$1=""; print}' | tr ' ' '\n' | \ sort | uniq > vocab_train.txt # 第二步:抽开发集的词并比对 cat data/my_dev/text | awk '{$1=""; print}' | tr ' ' '\n' | \ sort | uniq > vocab_dev.txt comm -13 vocab_train.txt vocab_dev.txt > oov_dev.txt # 第三步:算外词率 total=$(wc -l < vocab_dev.txt); oov=$(wc -l < oov_dev.txt) echo "开发集外词率: $(echo "scale=2; $oov * 100 / $total" | bc)%" # 预期输出(示例): # 开发集外词率: 3.00% # 超过百分之一就该动手:先看外词清单里前几十个高频词
解读这份输出有讲究:外词率按"词种类"算只是第一步,还要按"词出现次数"算一次——种类多但都只出现一次,杀伤力有限;少数高频外词反复出现,才是重点狙击对象。把外词清单按频次排序,前几十个逐个人工裁决,性价比最高。
变式做法:面向垂直领域(医疗、法务)时,与其追着外词打补丁,不如先导一份领域术语表进词典;语料极大时,低频词直接切到字级建模,外词问题自动消解大半。
治理问答两则
问:转写文本和音频对不齐怎么办? 表现为训练时大量帧被标成同一个音素、似然值停滞。排查顺序:先看有没有整句的转写错位(文件名对应错了是重灾区),再听几条可疑音频人工核对,最后查静音策略——文本删了语气词但音频里那半秒还在,也是隐性错位。错位少量可容忍,批量出现必须回炉。
问:词表到底多大合适? 没有标准答案,但有两条经验边界。词表小于语料能支撑的规模,语言模型欠拟合,句子生硬;词表盲目求大,大量词条只有一两次出现,语言模型与词典都在给稀词付维护费。按词频排序截取、让低频尾部落到字级或子词级,是常用折中。
⚠️ 常见坑一:训练集与测试集用了不同的归一化规则,等于两边说的不是同一种语言,错误率会莫名偏高且查无实据。坑二:补词条只补了词典忘了补语言模型训练文本,解码图里的词没有语言分,识别时永远排不上号。坑三:把标点直接删掉却没检查音频与文本对齐,遇到标点处有明显停顿的句子,静音建模会受影响。
带走几条规矩
- 一个任务一套规则:归一化规则写进版本库,训练测试同源。
- 外词按频次分流:高频补词条,低频近音映射,杂音归噪声。
- 两条线算覆盖率:词种类与出现次数各算一次,狙击高频项。
- 切词粒度是设计决策:词表规模、语言模型容量、生僻词免疫,三者权衡。
标注洗干净了,最后一道备矿工序是给每个词配上发音——词典与音素集怎么从零建起,下一节交底。