4.1 老式选矿机:GMM-HMM 的五段接力训练
4.1 老式选矿机:GMM-HMM 的五段接力训练
本节摘要:高斯混合加隐马尔可夫的经典训练是五段接力——单音素起步、差分特征三音素、线性判别变换、说话人自适应,每一段吃上一段的对齐、产出更精的对齐。本节把五段的输入输出、关键参数与日志读法讲透,这是理解后续神经网络训练的因果前提。
五段接力是怎么跑起来的
第一段单音素训练是整条流水线的"零号机"。它不需要任何先验对齐,靠期望最大化算法从零起步:先随便给模型参数一个初始值,用这个不太行的模型把训练音频逐帧对齐到音素状态(期望步),再按对齐结果重新统计每个状态的特征分布、更新参数(最大化步),两步交替,模型与对齐互相成全,几十轮后双双收敛。
单音素模型故意不做上下文区分——"啊"不管前后是什么都当成同一个"啊"。粗,但稳:参数少,小数据也能训出个样子。它的历史使命有两个:自己先当一个能用的识别器,更重要的是为下一段提供初始对齐。
# 零号机训练(在食谱目录内) steps/train_mono.sh --nj 4 --cmd "run.pl" \ data/my_train data/lang exp/mono # 参数解读: # 并行度四;执行器本地跑 # 训练目录 语言目录 输出目录 # 预期输出:日志滚动,末尾写出模型与最后迭代轮的对齐 # 用零号机给训练数据打帧级标签 steps/align_si.sh --nj 4 data/my_train data/lang exp/mono exp/mono_ali # 预期输出:对齐目录生成,内含逐句的帧级状态序列
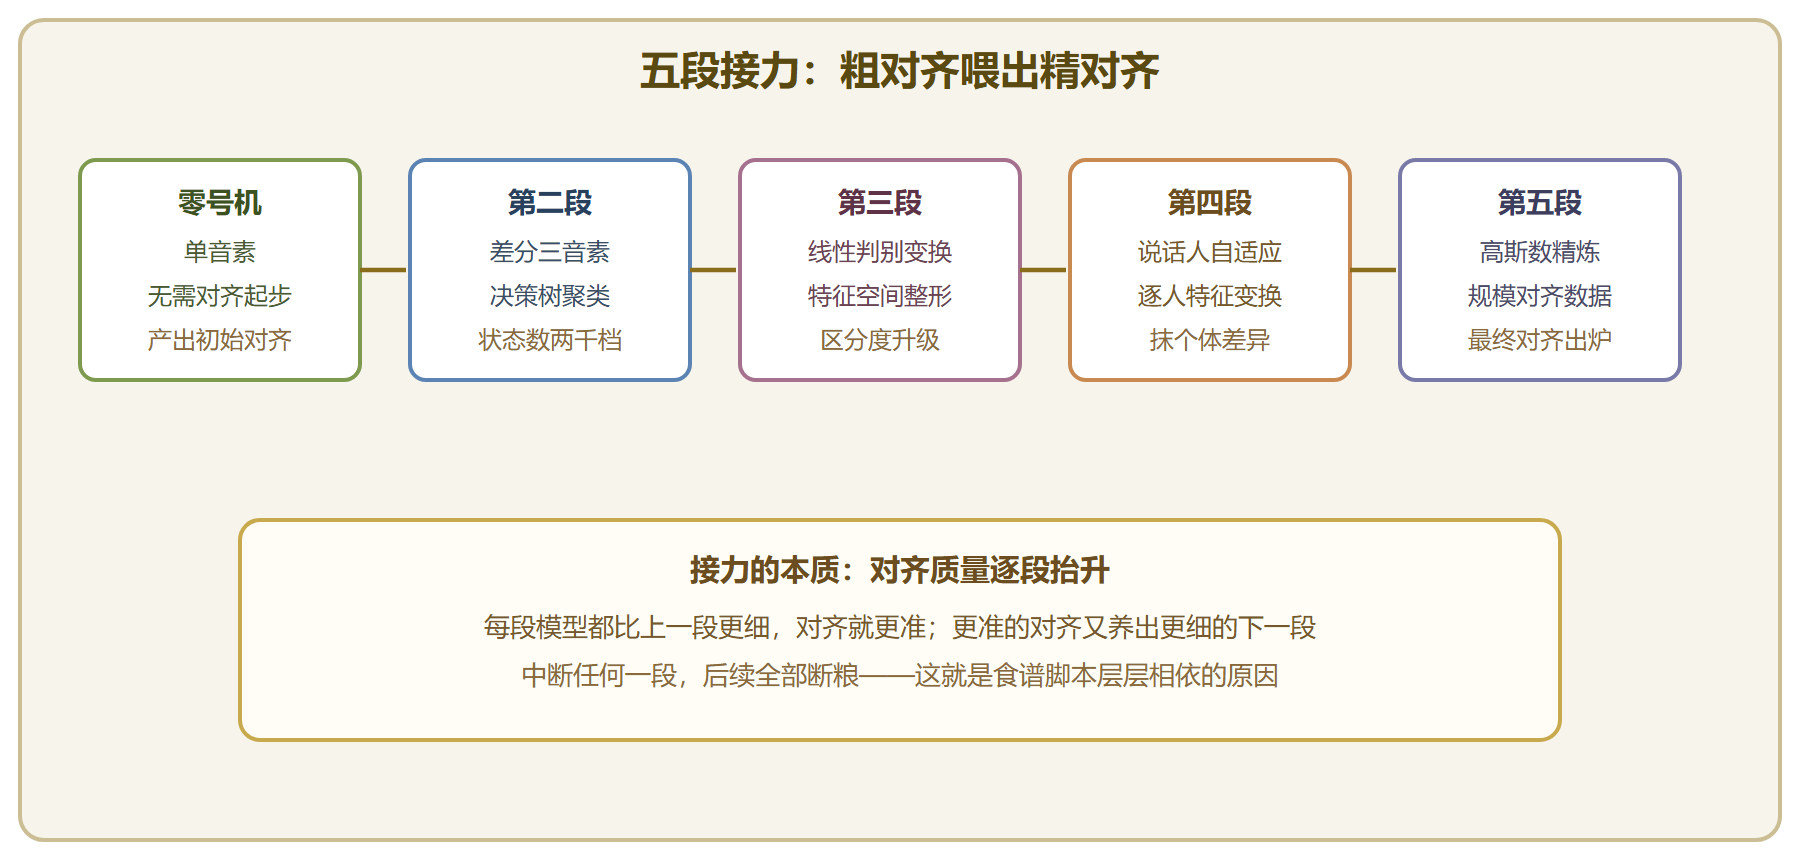
第二段三音素训练接棒。它要建模"左邻右里影响下的音素",参数量暴增,必须靠上一段的对齐来初始化决策树聚类与状态分布——没有对齐,三音素的几百种组合无从统计。特征也从静态十三维升级为拼上差分的三十九维,时间动态信息入场。
# 第二段:差分特征三音素 steps/train_deltas.sh --nj 4 \ 2000 10000 data/my_train data/lang exp/mono_ali exp/tri1 # 前两个数字是本段的核心参数: # 聚类后的状态数约两千、高斯分量总数约一万 # 数据量越大,这两个数越往上加,比例经验是三到五倍
第三段与第四段是特征空间的两次升级。线性判别分析先把拼接的差分特征投影到一个更有区分力的低维空间(类间散开、类内收紧),最大似然线性变换再让投影后的分布更适配对角协方差的高斯假设。第四段说话人自适应训练为每个说话人估计一组特征变换,抹掉嗓音条件的个体差异,训练与解码时都能受益。第五段在部分食谱里体现为更高高斯数的精炼轮,参数规模与数据量对齐。
图 五段接力:每段吃对齐、吐对齐
参数与日志:车间里的仪表盘
五段训练里你要打交道的参数集中在三处:状态数与高斯数(控制模型容量)、迭代轮数(训练步数)、对齐轮安排(隔多少轮重新对齐一次)。容量参数的黄金法则是"数据定容量":十小时语料撑两千状态,一百小时可到一万往上,盲目翻倍只会过拟合。
日志是仪表盘,重点盯两个表。似然值表逐轮打印平均对数似然,健康曲线是前几轮猛涨、后面趋平;如果到中段还在大幅波动,先查数据与特征的一致性。每段结束前的"每状态帧数"统计同样关键——若有状态只分到个位数帧,说明容量超了或数据太偏,决策树会自动把它们并到亲戚状态去。
# 训练日志片段(节选,数值为示意) # 第 12 轮迭代结束:平均对数似然 -68.3,每帧 # 第 16 轮迭代结束:平均对数似然 -66.1,每帧 # 第 20 轮迭代结束:平均对数似然 -65.4,每帧 # 增速放缓:模型接近收敛,继续加轮数收益有限
对齐质量有个便宜的体检法:抽几句话把对齐结果按时间画出来,人工看音素边界是否落在听感的音变处。对齐错得离谱(比如把整句都标成静音),后面神经网络学的就是错标签——垃圾进垃圾出在产线上是字面意思。
静音建模是五段训练里容易被忽视的暗线。静音条目通常建两类:长停顿与短停顿,前者管句间与首尾的大段安静,后者管词与词之间的微小间隙。训练脚本会接受一份"静音走哪些音素"的参数,默认从语言目录读。两类静音的分工不是洁癖——把短停顿并进长停顿,词边界会发糊,插入错误随之变多;5.3 节讲报表病灶时会再次遇到这条线索。
解码验收与常见病灶
每段训练完都该在开发集上解码一次,错误率应该逐段下降。若某一段不降反升,按段位查病灶:零号机就差,查数据与特征口径;第二段差,查对齐是否污染;第三四段差,查变换矩阵的估计轮数是否过少。逐段验收的好处是把大问题切成小问题,每段的搜索空间都不大。
容量参数随语料的放量有经验表可循,动手前先对号入座:
| 语料规模 | 状态数量级 | 高斯数量级 | 备注 |
|---|---|---|---|
| 十小时级 | 一两千 | 五千到一万 | 小任务两段就够 |
| 百小时级 | 五千到一万 | 四万到十万 | 五段全开 |
| 千小时级 | 一两万 | 十万到几十万 | 还要加区分性训练 |
再展开一个完整的排错案例。背景:某次十小时语料的第二段训练,似然值在第八轮后横盘,开发集错误率比零号机还差两个点。操作:先抽对齐人工听看,发现十来句话整段被标成静音;顺藤摸瓜查到这几句的音频采样率登记错了,特征提取时被当成了错误口径。结果:修数据目录、重提特征、从零号机重跑,第二段似然恢复爬升。解读:症状出现在第二段,病根在备矿——对齐是"上游数据的放大镜",上游一点小错,对齐环节放大成整句错标。变式:若似然从第一轮就不动,优先怀疑特征与清单不一致;若似然正常但错误率不动,检查解码图是否用了旧模型生成。
⚠️ 常见坑一:中断后续跑时不重新对齐,新旧对齐混用,似然曲线会出现台阶。坑二:并行度开太高撞内存上限,表现为随机某路任务被杀,日志看似玄学实则资源问题。坑三:拿训练集错误率当验收指标,五段全绿,一上开发集就现形。
💡 关键直觉:五段接力的每一"段"都是"容量加一档、上下文多一层、先验强一点"的组合拳。记住这个模式,你在任何食谱里看到新的段名(不同食谱的段名略有出入),都能猜出它在加什么。
炉前记录
- 零号机破鸡生蛋:期望最大化让参数与对齐交替逼近,无需先验标签。
- 容量跟着数据走:状态与高斯数按语料小时数上量,过拟合的信号在开发集上。
- 对齐是硬通货:每段的核心产物是更精的对齐,它决定下一代的地基。
- 逐段验收:开发集错误率逐段下降是唯一健康的形态。
接力棒交给神经网络:五段磨出来的高质量对齐,正是新式选矿机的监督标签。下一节看打分器换代。