4.2 新式选矿机:nnet 三代框架与 TDNN 训练
4.2 新式选矿机:nnet 三代框架与 TDNN 训练
本节摘要:Kaldi 的神经网络框架经历三代演进,共性是"网络接管打分器、对齐充当标签"。本节讲清三代框架的设计差异、时延神经网络的时间上下文思想、帧级交叉熵训练的完整流程与关键参数,并顺带一瞥模型融合。承接 4.1 的五段对齐,是通往 4.3 链式模型的台阶。
选矿机换代史
神经网络进场的方式很克制:框架不动,只换心脏。隐马尔可夫骨架、词典、语言模型、解码流程全部保留,网络只干一件事——给每一帧输出"属于每个状态的概率"。这个定位决定了三代框架的演进方向:怎么把网络训得更快、更稳、更能吃上下文。
第一代框架是"组件串":网络是线性堆叠的层,逐层定义、逐层训练,适合中小数据。第二代框架主打"数据并行":多张显卡各训一个副本再平均参数,海量小任务的在线场景是它的主场。第三代框架是"计算图":网络不再假定是串,任意的连接模式都能描述,时延网络、卷积、记忆网络一图通吃,现代食谱几乎全部跑在它上面。三代并存不是历史遗留,而是各有生态位:小语料用第二代能快速出活,大任务必然第三代。
| 维度 | 第一代 | 第二代 | 第三代 |
|---|---|---|---|
| 网络形态 | 组件线性串 | 串加并行副本 | 通用计算图 |
| 上下文 | 固定拼帧 | 固定拼帧 | 逐层自定义 |
| 训练规模 | 单机单卡 | 多卡数据并行 | 多卡加图优化 |
| 典型场景 | 早期食谱 | 小任务快速出活 | 现代主流 |
| 配置方式 | 逐组件脚本 | 逐组件脚本 | 配置文件描述图 |
TDNN:时间感受野的层叠
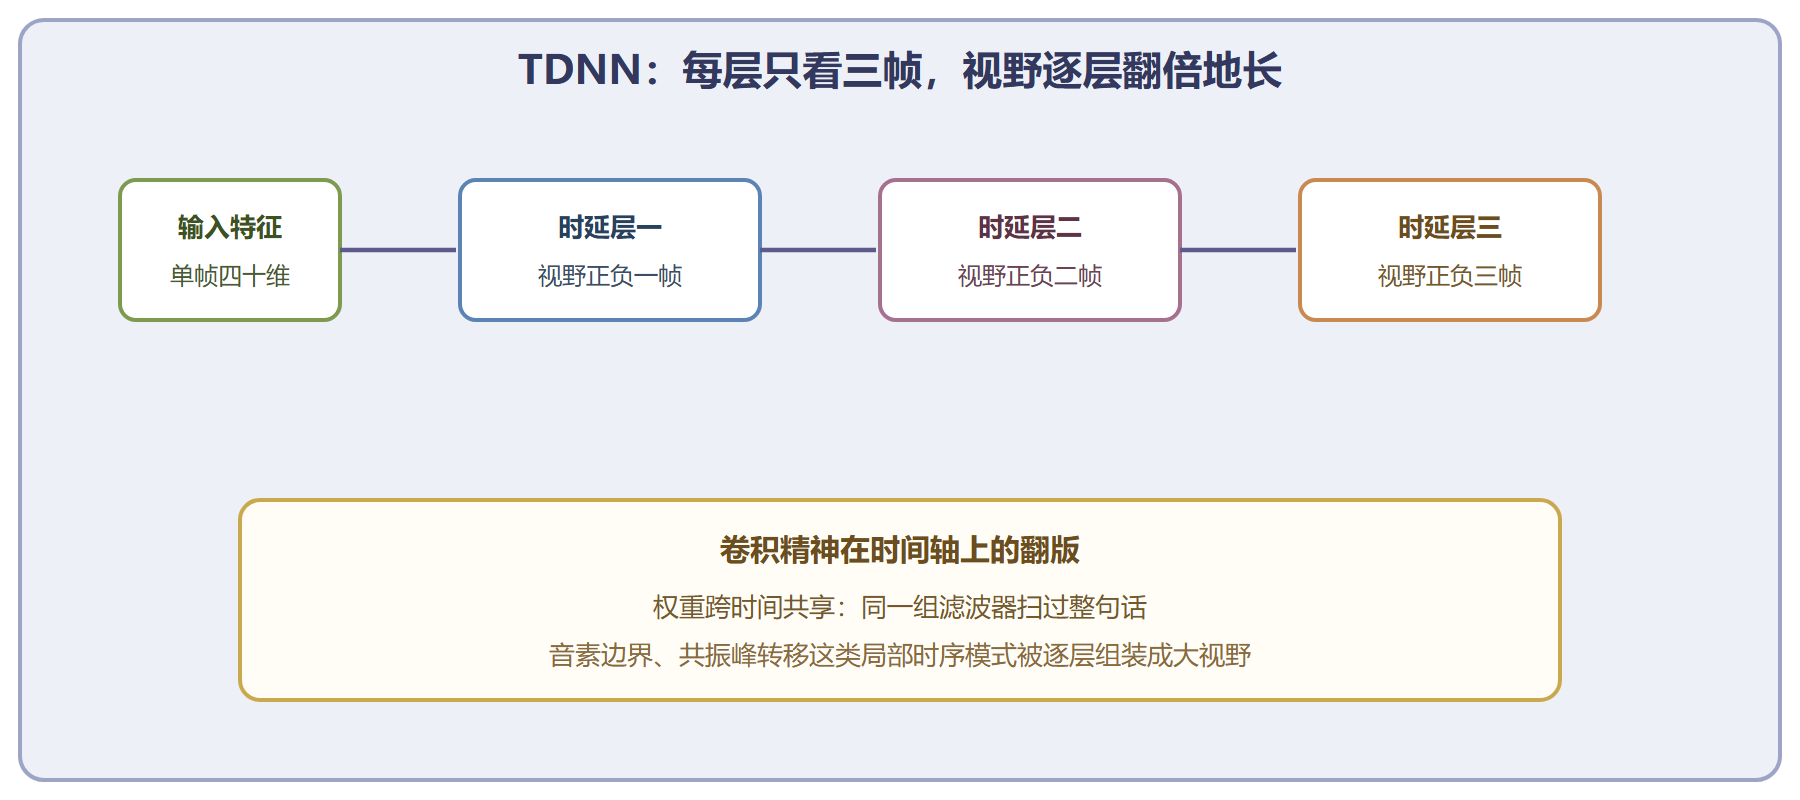
时延神经网络的核心思想一图胜千言:第一层只看当前帧加左右各一帧,第二层在第一层的输出上再看左右各一帧——等效时间窗变宽了,但参数是逐层共享的。对比"一次拼十帧喂给全连接层"的老做法,时延网络用少得多的参数达到同样宽的视野,还顺带学会了"局部模式在时间上平移不变"这个有用的先验。
# 算一笔参数账:宽视野的两种实现 import numpy as np feat_dim, hidden = 40, 512 wide_context = 11 # 一次拼十一帧 # 方案一:全连接一次吃十一帧 fc_params = feat_dim * wide_context * hidden # 方案二:时延式三层,每层只看三帧(左右各一) tdnn_params = sum(feat_dim * 3 * hidden for _ in range(3)) print(f"全连接方案参数量:{fc_params:,}") print(f"时延三层参数量:{tdnn_params:,}") print(f"压缩比:{fc_params / tdnn_params:.1f} 倍") # 输出(示例): # 全连接方案参数量:225,280 # 时延三层参数量:184,320 # 压缩比:1.2 倍 # 解读:视野相近时参数省一截; # 层数加深后时延方案的等效视野继续扩大,优势随之放大
感受野是逐层扩大的:每加一层时延层,网络能"看见"的时间宽度加两帧,而参数只加这一层的量。深度的价值在此体现——不是玄学的"更深更强",是视野与参数效率的同向优化。
图 TDNN 逐层扩大的时间感受野
训练流程:从对齐到模型
帧级交叉熵训练的流程环环相扣:先固定上一代模型的对齐当标签,把标签转成"每帧的状态编号",再按训练轮次把特征与标签打包成样例送进网络。看一段第三代框架的典型配置:
# 网络配置(示意):三明治结构 # 输入:拼接正负两帧共五帧 component name=input type=NaturalGradientAffineComponent input-dim=200 output-dim=512 component name=relu1 type=RectifiedLinearComponent dim=512 component name=bn1 type=BatchNormComponent dim=512 component name=relu2 type=RectifiedLinearComponent dim=512 # 输出层:维度等于状态绑定后的状态总数 component name=output type=SoftmaxComponent input-dim=512 output-dim=3168 # 解读:仿射加激活加归一化逐层堆叠, # 输出层维度由决策树聚类的状态数决定
# 训练入口(第三代框架,示意调用) steps/nnet3/train_dnn.py --stage=0 \ --num-epochs=8 --num-jobs-initial=1 --num-jobs-final=4 \ --hidden-num-layers=5 --hidden-dim=1024 \ --egs-dir=exp/tdnn_egs --dir=exp/tdnn_xent # 参数解读: # 训练轮数八;显卡任务从一爬到四(随收敛减学习率时加并行) # 五个隐藏层、每层一千零二十四维 # 样例目录提前生成,可多模型共享 # 预期输出:每轮打印训练与验证目标函数值,逐轮下降
两个训练细节值得单独点出。其一,样例(成批的特征加标签)生成一次可反复用,多组超参数实验共享样例能省一大笔准备时间。其二,验证集目标函数是"何时停"的裁判:训练值还在降、验证值连着几轮回升,就是过拟合的信号,别恋战。
模型融合一瞥
训练成本高企时,融合是省钱的艺术。参数平均最简单:同结构网络从不同随机种子训几份,把权重逐层平均,常能白捡一点稳定增益;输出融合稍重:多个模型各自打分,分数按权平均后再送解码。融合的收益在中小数据上明显,数据大了增益摊薄,性价比要自己算。别把它当主力手段——它是锦上添花的最后一手。
⚠️ 常见坑一:网络输出维度与对齐的状态数对不上,训练一启动就报维度不匹配,回查决策树是否换过。坑二:样例目录是用旧对齐生成的,模型换代后忘了重生成,标签系统性错位。坑三:显卡内存不够还硬开大层宽,报错信息常是含糊的连接错误,先减批量与层宽再排查。
💡 关键直觉:三代框架都在回答同一道题——如何高效地给"帧到状态"这个打分器喂上下文。第一代拼帧、第二代并行、第三代图化加时延,答案不同,题目从未变过。
换代启示录
- 定位决定形态:网络只是打分器,框架兼容性让它可以平滑换代。
- 时延即效率:逐层共享的窄窗口,用更少参数换更宽视野。
- 样例与对齐是两份共享资产:生成一次,多组实验复用。
- 融合是末技:先榨干单模型的潜力,再谈平均与组合。
交叉熵训练的目标是"每帧贴对标签",但识别的成败在整句。下一节点火高炉:链式模型直接拿句子级目标训练,把"逐帧模仿"升级为"整句竞争"。