4.3 高炉冶炼:链式模型与 LF-MMI 序列判别训练
4.3 高炉冶炼:链式模型与 LF-MMI 序列判别训练
本节摘要:链式模型用两个改动把传统流水线推到效率顶点——训练目标从帧级交叉熵换成序列级判别目标(免词格最大互信息),建模粒度从逐帧三状态换成跳帧单状态。本节讲清两个改动的动机与机制、训练流程与关键参数、与交叉熵路线的量化对比,并给出选型建议。
为什么还需要一座高炉
交叉熵训练有个内在错位:目标函数在优化"每一帧贴对标签",但产品指标是"整句识别对错"。帧贴得准不等于句对——解码时的竞争路径是整句级别的,训练时却从未让模型在句级竞争过。老办法是训练完再做一次"词格判别训练"补救:用第一遍解码的词格当反例集合,教模型"正确句子赢过竞争句"。有效,但要多一遍解码、多一堆词格存储,工序繁重。
链式模型把这座补炉并进了主炉。它的判别目标(免词格最大互信息)直接在句级竞争:分子项要求"正确转写的路径"分数尽量高,分母项是"解码图里所有可能路径"的总分——优化方向就是让正确路径从全体竞争者中脱颖而出。分母不用真词格,直接在一张固定的解码图上用前向算法算出来,省掉了生成与存储词格的全部开销。这座高炉的名字"链式",来自它把声学建模串联成一条精简的链。
第二个改动更工程化:跳帧。传统模型每十毫秒一帧都要出分,链式模型默认每三十毫秒出一个输出——中间两帧的分数不算了。识别所需的时间分辨率本来就到不了十毫秒,砍掉冗余输出后,训练与解码的计算量齐降三成上下,还几乎不掉指标。
图 两代训练目标的对照
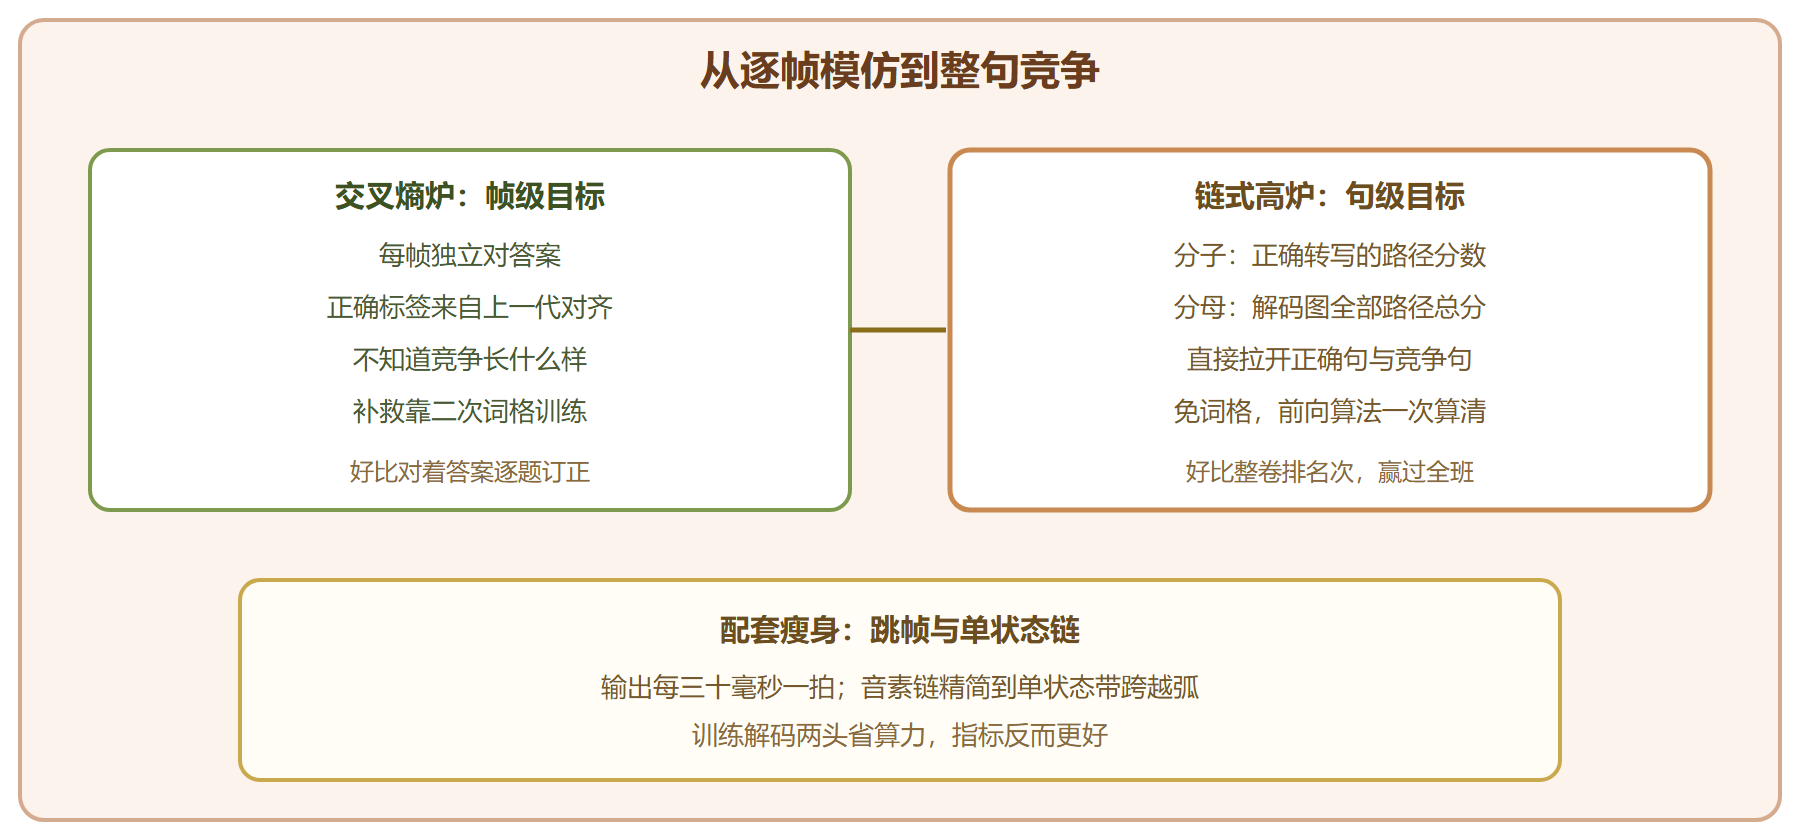
建模粒度的瘦身
链式模型的隐马尔可夫骨架也做了减法:每个音素从"三状态自环"改成"一个状态加一条跨越弧",跨越弧允许一步跳过约三帧。配合跳帧输出,整条链的节奏与三十毫秒一拍的输出口径对齐。瘦身的收益直接体现在解码速度上——状态数少了、每秒要打的分少了,实时率显著改善。
粒度瘦身后,特征节奏也变:输入仍是十毫秒一帧的滤波器组特征,网络内部逐层汇聚,到输出层降到三十分之一千秒一拍。时间对齐关系由网络自己学,不再需要人工设计的状态拓扑去精细对帧。
顺带一提边界处理。跳帧输出意味着句子首尾可能出现"不满一拍"的余数帧,链式框架的做法是在句边界补齐并对边界帧降权,训练代码内部处理完毕,使用者无感。但自己动手改跳帧因子或句边界逻辑时,这套机制要跟着检查——边界帧的分数权重错了,短句(指令词、口令类任务)的识别会系统性变差,而日志不会给你任何提示。
训练流程与参数
链式训练仍然依赖第 4.1 节的高斯混合对齐——分子项的"正确路径"从对齐导出,这是很多初学者意外的事实:最现代的训练,地基仍是那台老式选矿机。流程是:先用对齐生成分子图与标签,再构建分母用的固定解码图,然后把两样打包成样例送训练。
# 链式模型训练入口(示意调用) steps/nnet3/chain/build_tree.sh \ 3500 data/my_train data/lang exp/tri3_ali exp/chain_tree # 先为链式模型重新聚一棵更粗的树:三千五百个叶子状态 steps/nnet3/chain/train.py --stage=0 \ --xent-regularize=0.1 --l2-regularize=0.0000001 \ --leaky-hmm-coefficient=0.1 \ --egs-dir=exp/chain_egs --dir=exp/chain_model # 参数解读: # 交叉熵正则项防止训练早期不稳 # 泄漏系数控制跨越弧的软约束强度 # 预期输出:逐轮打印验证集的目标函数值,稳步上升
# 训练日志的关键行(节选,数值为示意) # 第 4 轮:验证目标函数 -0.089 # 第 8 轮:验证目标函数 -0.076 # 第 12 轮:验证目标函数 -0.071 # 目标函数越接近零,正确路径与全体竞争的差距拉得越开
量化对比与选型
同一个任务、同一批语料,两条路线的典型量级对比(数值为常见经验区间,具体任务有出入):
| 维度 | 交叉熵加二次判别 | 链式模型 |
|---|---|---|
| 训练目标 | 帧级,后补句级 | 句级一步到位 |
| 训练时间 | 两阶段,更久 | 单阶段,较短 |
| 解码速度 | 基准 | 快三到四成 |
| 同数据错误率 | 基准 | 低一到三成 |
| 依赖 | 需词格存储 | 免词格,磁盘友好 |
| 对对齐质量 | 敏感 | 同样敏感(分子来源) |
选型建议简单直接:有显卡、语料超过几十小时,默认链式模型,这是现代食谱的主力配置;无显卡或语料极小,老路线虽慢但能跑。两条路线共享备矿产线与对齐资产,切换成本主要是重训,不动数据。
实操案例:百小时语料切换链式路线
背景:一个五十小时的任务原先跑交叉熵加二次判别两阶段,单轮实验要一天半,调参周期拖成了周报节奏。操作:保留全部备矿与对齐资产,按三步切换——先为链式模型重聚一棵粗树(叶子状态三千出头),再生成链式样例(分母图构建包含在内),最后启动训练,交叉熵正则与泄漏系数用食谱默认值起步。结果:训练单阶段约七小时跑完,开发集错误率比旧路线低两成,解码实时率从零点九降到零点六。解读:收益来自三处叠加——句级目标直接优化产品指标、跳帧降低解码计算、免词格省下二次训练;其中句级目标贡献最大。变式:若错误率反而变差,第一嫌疑是样例的分母图与音素表不一致(换树后忘重建),第二嫌疑是学习量级照搬旧路线。
两个高频疑问也顺带回答。其一,链式模型还要不要二次判别训练?不要,句级竞争已经内建,再叠一次属于重复用药。其二,链式模型与交叉熵模型能混用吗?可以但没必要,融合的增益通常小于直接把链式模型调好;真要混,确保两者的输出粒度与状态空间一致,否则分数没法对齐。
⚠️ 常见坑一:把链式模型当"免对齐"方案跳过高斯混合阶段,分子图无从生成,训练直接报错。坑二:跳帧参数改了却没重生成样例,输入输出节拍错位,损失函数停在随机水平。坑三:学习率沿用交叉熵的量级,链式目标对学习率更敏感,开局过大直接发散,按食谱默认值起步最稳。
💡 关键直觉:链式模型的成功不在某个单点创新,而在"目标、粒度、节奏"三处协同减负。识别任务真正需要的时间分辨率与句级竞争,都被它对齐到了该有的粒度——省下来的算力花在了刀刃上。
出炉前的话
- 目标对齐任务:产品按句考核,训练就该按句竞争。
- 免词格是真省钱:分母前向一遍算清,工序与磁盘双省。
- 老机器仍是地基:分子来自高斯混合对齐,接力棒一直没换手。
- 跳帧不丢精度:时间分辨率的天花板由语音本身决定,不由帧移决定。
三代机器都开过了,下一章把它们的产出装进解码图,开炉放料、称重评级——整条产线的成绩单在那里揭晓。