5.4 副产品的价值:词格的抽取、重打分与置信度
5.4 副产品的价值:词格的抽取、重打分与置信度
本节摘要:词格是解码过程顺手留下的压缩候选图,每条弧上挂着声学分与语言分。本节讲词格的数据结构、最优路径与候选列表的抽取、语言模型重打分的完整流程、后验置信度的计算,以及词格的日常维护操作。承接 5.3 的打分,为第 6 章的增产手段备料。
尾矿里还有金子
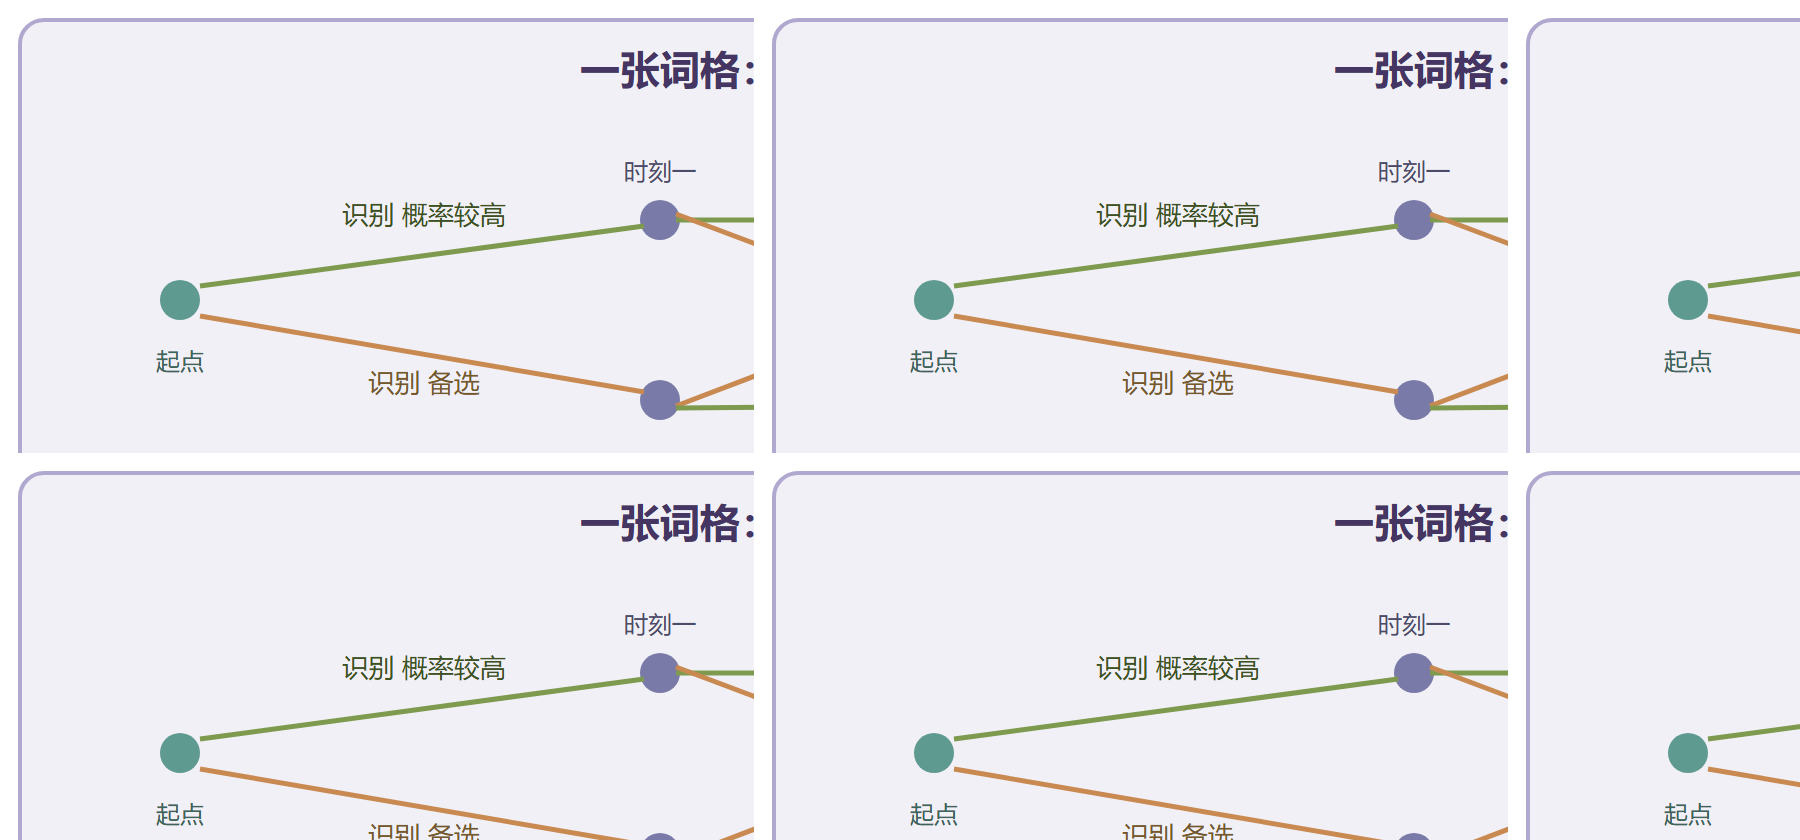
第一遍出炉只取了词格里分数最高的一条路径,剩下的候选全都沉在尾矿里。词格长什么样?它是一张有向无环图:节点是时间点,弧上带词与两类分数(声学对数分、语言对数分),从起点到终点的每条路都是一个"曾被认真考虑过的句子"。好句子未必是第一名的句子——语言模型换个口径,第二名可能翻身。词格的全部价值就在这里:它把"再想想"的成本降到最低。
抽取:从图到句子
两类抽取最常用。最优路径抽取给出第一名句子,等价于解码时直接输出;候选列表抽取按路径分数排序给出前若干名,供人工审校或下游系统挑选。命令族都以词格开头,看一遍就能举一反三:
# 最优路径:词格压成单句 lattice-best-path --word-symbol-table=graph/words.txt \ ark:"gunzip -c lat.1.gz|" ark,t:- # 预期输出:逐句打印词序列 # speakerB_0007 识别 语音 的 准确率 # 候选列表:抽前五名 lattice-to-nbest --n=5 ark:"gunzip -c lat.1.gz|" ark,t:nbest.txt # 预期输出文件:每句话连续五行,第一名到第五名 # 通常第一名与第二名只差一两个词,越往后差异越大 # 词格体检:看规模与密度 lattice-copy ark:"gunzip -c lat.1.gz|" ark:/dev/null 2>&1 | grep -c "" # 或用信息类工具查看节点数与弧数,密度异常往往预示解码参数问题
重打分:换个裁判再排一遍
重打分的动机来自一个错位:进解码图的语言模型必须小而快(第 2 章讲过),但评判句子的语言模型最好大而准。词格重打分补上这一刀:取出候选路径,用大语言模型或神经语言模型重新计算语言分,替换旧分,再选一次第一名。
# 神经语言模型重打分的骨架流程(在食谱目录内) # 第一步:把词格的词换成语言模型词表编号 # 第二步:用神经模型逐路径打新语言分 # 第三步:新旧分数按配比融合后重选最优 local/rescore_rnnlm_lat.sh \ data/my_dev exp/tri1/decode_my_dev exp/rnnlm # 预期输出:新的解码目录生成,错误率通常降零点几到一个点 # 降幅取决于原语言模型与任务领域的匹配度
重打分的收益有个朴素的判断法:看错误样本里"第二名才是对的"占比。这个占比越高,重打分的空间越大;如果第一名总是对的、错也错在第一名,那病灶在声学侧,重打分救不了。
图 词格拓扑与后验置信度
置信度:给每个词标个把握
把词格里所有路径的分数归一化(后向-前向算法一遍算清),每个词在所有路径上被选中的概率加起来,就是它的后验置信度。这个数字的用处直接而广泛:字幕系统可以给低置信词标灰提示人工确认;转录系统可以只把低置信片段送人工复核,省下一大半审校量;语音助手可以拿它决定"要不要反问用户"。
# 后验置信度的玩具计算(两候选世界) import math paths = { # 路径 对数总分 "识别 语音": -6.2, "识别 雨": -7.4, } # 第一步:指数化并归一化 weights = {p: math.exp(s) for p, s in paths.items()} z = sum(weights.values()) post = {p: w / z for p, w in weights.items()} # 第二步:逐词累加后验 conf = {} for p, pr in post.items(): for w in set(p.split()): conf[w] = conf.get(w, 0) + pr print({k: round(v, 3) for k, v in sorted(conf.items())}) # 输出:{'识别': 1.0, '语音': 0.769, '雨': 0.231} # 解读:'识别' 稳如泰山;'语音' 把握约七成七, # 若阈值定在八成,这个词就该进人工复核队列
日常维护:词格的库房管理
词格文件比单句结果大一个量级,库房管理有三招。压缩存储是默认动作,磁盘占用可降一半以上;剪枝只留每节点分数最高的若干条弧,牺牲一点候选丰富度换体积;按需生成则是终极方案——磁盘紧张时只存解码中间产物,词格用完即弃。还有一手反向操作叫词格合并:把不同模型或不同参数产出的词格并成一张,取长补短,常用于多系统融合。
再介绍一个进阶玩法:混淆网络。把词格按时间对齐压扁成一条串行的"槽",每个槽里堆着当年在此竞争过的候选词,同一槽内候选互斥、槽间顺序固定。它损失了词格的部分结构,换来一个直观的副产品——每个槽的后验分布直接可读,人工审校界面、词级统计、错误模式挖掘都爱用它。从词格生成混淆网络的工具同样在词格工具族里,输入词格、输出网络,一步到位。
词格与时间信息的组合还有个常见消费方式:转成时间标记文本(每个词带起止时间),供字幕对轴、媒体检索这类下游使用。词格天生带时间节点,抽取工具会把词的时间戳一并算出,字幕场景几乎是零成本接入。
⚠️ 常见坑一:重打分用的语言模型词表与词格词表不一致,替换词对不上,错误率反而上升。坑二:置信度拿去跨句子比较,不同句子的竞争激烈度不同,后验分布天然不同,阈值只能按句内或按全局校准。坑三:词格剪过头还指望重打分翻盘,第一名都排不进候选的句子,换裁判也没用。
💡 关键直觉:词格是"延迟决策"思想的产物——不急着在解码那一刻定终身,把候选世界压缩存档,等更多证据(更好的语言模型、领域知识、用户反馈)到位再裁决。产线上所有"二次加工"类手段,地基都是它。
尾矿台账
- 词格即候选世界:最优路径只是它的一个切面,扔掉词格等于扔掉反悔权。
- 重打分换裁判不换证据:声学账不动,语言账重算,成本远低于重解码。
- 后验是置信度:低置信词定位人工复核区,审校成本立减。
- 库房三招:压缩、剪枝、按需生成,磁盘与灵活性的权衡自选。
出炉工序全部走完。下一章进入增产篇:自适应、数据增强、实时化、工具改造与运营排障,让这座矿场在既有家底上多出金子。