5.3 出厂检验:词错误率的计算、报表与病灶解读
5.3 出厂检验:词错误率的计算、报表与病灶解读
本节摘要:词错误率用编辑距离把识别结果与参考转写对齐,统计替换、删除、插入三类错误之和占参考词数的比例。本节从定义算起,讲清打分管线、报表逐列读法、调参网格的选择纪律与指标的公平性陷阱,最后给出从错误类型反推病灶的方法。承接 5.2 的解码产物,是出炉的质检关。
学习目标
阅读完本节,你应当能够:
- 手工计算一段识别结果的词错误率,分清三类错误
- 跑通打分流程并解释报表文件名里的两个数字
- 在开发集上用网格搜索选打分参数,并守住不碰测试集的纪律
- 从替换、删除、插入的分布反推词典、静音、语言模型哪环有病
- 说明词错误率的局限与中文任务按字评测的差异
一、错误率是编辑距离的账
识别结果与参考转写是两个词序列,评分类似拼写检查:求把识别序列改成参考序列的最小编辑步数,每步是替换、删除或插入一个词。错误率等于三步数之和除以参考词数。注意分母是参考的长度——识别多吐了词,分母不变,所以错误率理论上可以超过百分之百(识别出一堆幻听词时真的会发生)。
# 手算一遍编辑距离与错误率(含对齐路径) import numpy as np ref = "识别 语音 的 准确率".split() hyp = "识别 雨 的 准确 了".split() R, H = len(ref), len(hyp) dp = np.zeros((R + 1, H + 1), dtype=int) dp[:, 0] = np.arange(R + 1) # 全删除 dp[0, :] = np.arange(H + 1) # 全插入 for i in range(1, R + 1): for j in range(1, H + 1): cost = 0 if ref[i-1] == hyp[j-1] else 1 dp[i, j] = min(dp[i-1, j-1] + cost, # 替换或保持 dp[i-1, j] + 1, # 删除 dp[i, j-1] + 1) # 插入 wer = dp[R, H] / R print(f"参考 {R} 词,假设 {H} 词,编辑距离 {dp[R, H]}") print(f"词错误率:{wer:.0%}") # 输出: # 参考 4 词,假设 5 词,编辑距离 3 # 词错误率:75% # 解读:语音→雨(替换),的→的(对),准确率→准确 了(替换加插入)
把对齐画出来,三类错误各就各位:替换是近音词打架,删除是识别器吞了词,插入是识别器多吐了词。三类的比例分布就是病历首页——下一节会看到它们各自指向哪道工序。
二、打分管线与报表逐列
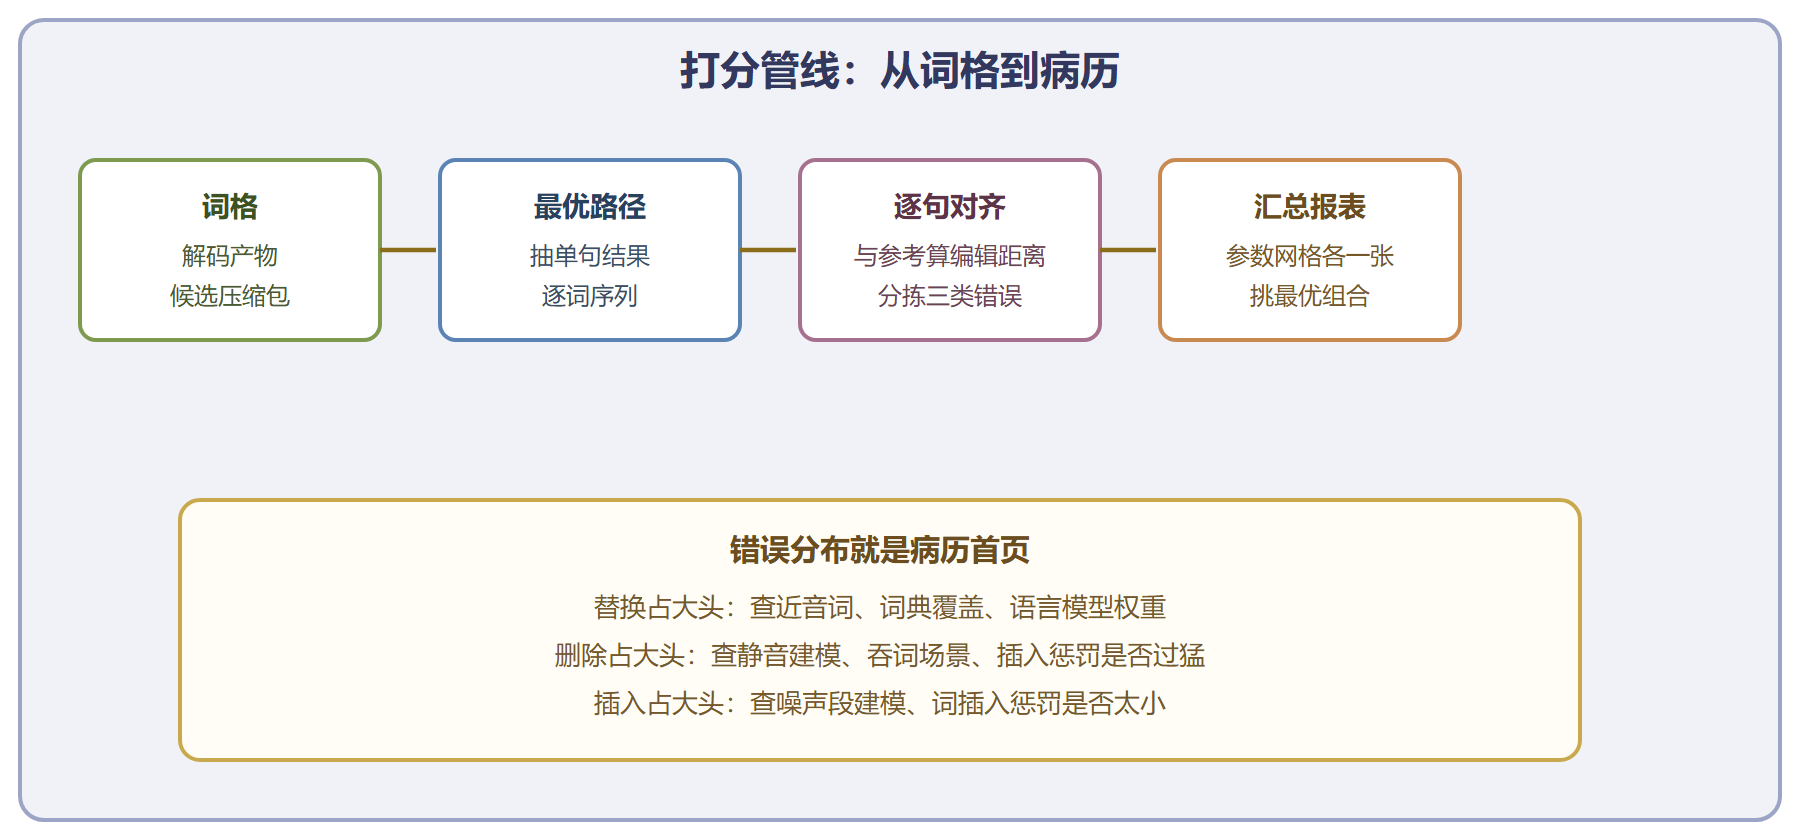
打分脚本把词格里的最优路径抽出来,与参考逐句对齐,汇总成报表。管线三步:抽句子、对齐、汇总。报表文件名藏着两个参数:语言模型权重与词插入惩罚,打分脚本会扫一片网格,每个组合各出一张报表。
# 打分(在解码输出目录的上一级执行) local/score.sh data/my_dev exp/tri1/graph exp/tri1/decode_my_dev # 预期输出:扫描参数网格后,挑出错误率最低的组合并打印 # 打开最优报表 cat exp/tri1/decode_my_dev/wer_10_0.0 # 预期输出: # %WER 12.50 [ 25 / 200, 3 ins, 4 del, 18 sub ] # 首行解读:错误率十二点五; # 两百个参考词;插入三、删除四、替换十八 # 后续逐行列出错句,格式为:误识序列 与 参考序列 的对照
报表正文每行一个错句,误识与参考成对出现,肉眼扫一遍错句的模式,比单看汇总数字收获大得多:错的全是近音词,查词典与语言模型;错的集中在句尾,查静音建模;整句被吞,查解码图与特征口径。
逐句细看还有个升级玩法:把错句按场景分组统计。按说话人分组,看错误是否集中在某几个人(口音或录音条件问题);按音频时长分组,看长句是否系统性变差(静音与吞词问题);按信噪比分组,看抗噪能力(前端处理或数据增强问题)。一张报表至少能切出这三个观察维度,每个维度都可能把"平均错误率"这个粗指标拆出一块可下嘴的病灶。
图 打分管线与报表解读要点
三、参数网格与评测纪律
打分参数(语言模型权重、词插入惩罚)不是模型的一部分,是"如何读分数"的口径。流程内定在开发集上扫网格选最优组合,把这个组合冻结,用于最终测试集。纪律红线:测试集只在最后跑一次,绝不参与任何参数选择——包括打分参数。见过太多团队在测试集上扫网格"再压一点错误率",那不是调优,是作弊,上线即打回原形。
网格的选择也有门道。两个参数各扫五档就是二十五次组合,报表文件铺满目录;实用做法是先粗扫定权重档位,再在档位附近细扫插入惩罚,十来张报表就够定位最优点。参数面通常是个浅碗,最优点附近差异在小数点后一位,不必为最后零点零几的错误率把网格加密到底——那是把评测噪音当信号。
中文任务还有个特殊议题:按词还是按字评。中文分词标准不统一,按词评的数字跨团队没法比;通行做法是按字算字符错误率,或者训练与评测都基于同一套分词。报告指标时务必写清口径,"错误率百分之五"不带口径等于没说。
指标家族再补两个常用成员。句错误率统计"整句全对的比例",产品视角比词错误率更贴近用户感受(一个词错,整句照样不可用);实时率在 5.2 节已经定义,与错误率构成质量-速度的二维评估。汇报时三件套一起上,比单报一个词错误率诚实得多。
⚠️ 常见坑一:参考转写没做与训练同源的归一化(大小写、数字读法、标点残留),对齐时整句报废,错误率虚高。坑二:报表文件名里的参数组合没记录就换目录,两周后复盘时不知道当时用的哪张报表。坑三:小测试集上的波动当趋势,一两百个词的测试集,一两个词的变化就能晃动一个百分点,结论要配合显著性常识。
💡 关键直觉:词错误率是"编辑距离账",不是"百分比正确率"。识别器多说的每个词都记账,少说的每个词也记账——所以它能超过一百,也正是这种严格,让它成为跨系统可比的硬通货。
本节要点回顾
- 三类错误三本账:替换、删除、插入各有典型病灶,先看分布再动手。
- 参数在开发集选:打分口径也是参数,测试集只许最后碰一次。
- 口径决定可比性:分词方案、归一化规则、按词按字,写进报告才作数。
- 错句比汇总值钱:逐句看错例的模式,是定位问题最快的路。
报表读完,别急着扔掉词格——里面还压着候选与分数。下一节淘最后一遍尾矿。