6.2 人造富矿:速度扰动与谱面掩蔽的数据增强
6.2 人造富矿:速度扰动与谱面掩蔽的数据增强
本节摘要:数据增强不采集新音频,凭空造出更多训练料:速度扰动在时间轴拉伸压缩,谱面掩蔽在特征上遮挡频段与时段,加噪混响把干净语音拖进真实声学环境。本节讲清三类操作的机理与参数、增强在训练管线中的接入位置、过量反噬的识别与一个完整案例。承接 6.1 的自适应,是花算力换指标的头号手段。
贫矿变富矿
模型见过的变化越多,遇新声音越稳——这条经验规律是增强的全部理由。训练语料是有限的采样:说话人有限、信道干净、语速正常。真实世界的语音却在另一头:电话窄带、远场混响、背景人声、快慢不一。增强做的就是在训练数据里"预演"这些变化,让模型提前见过风浪。
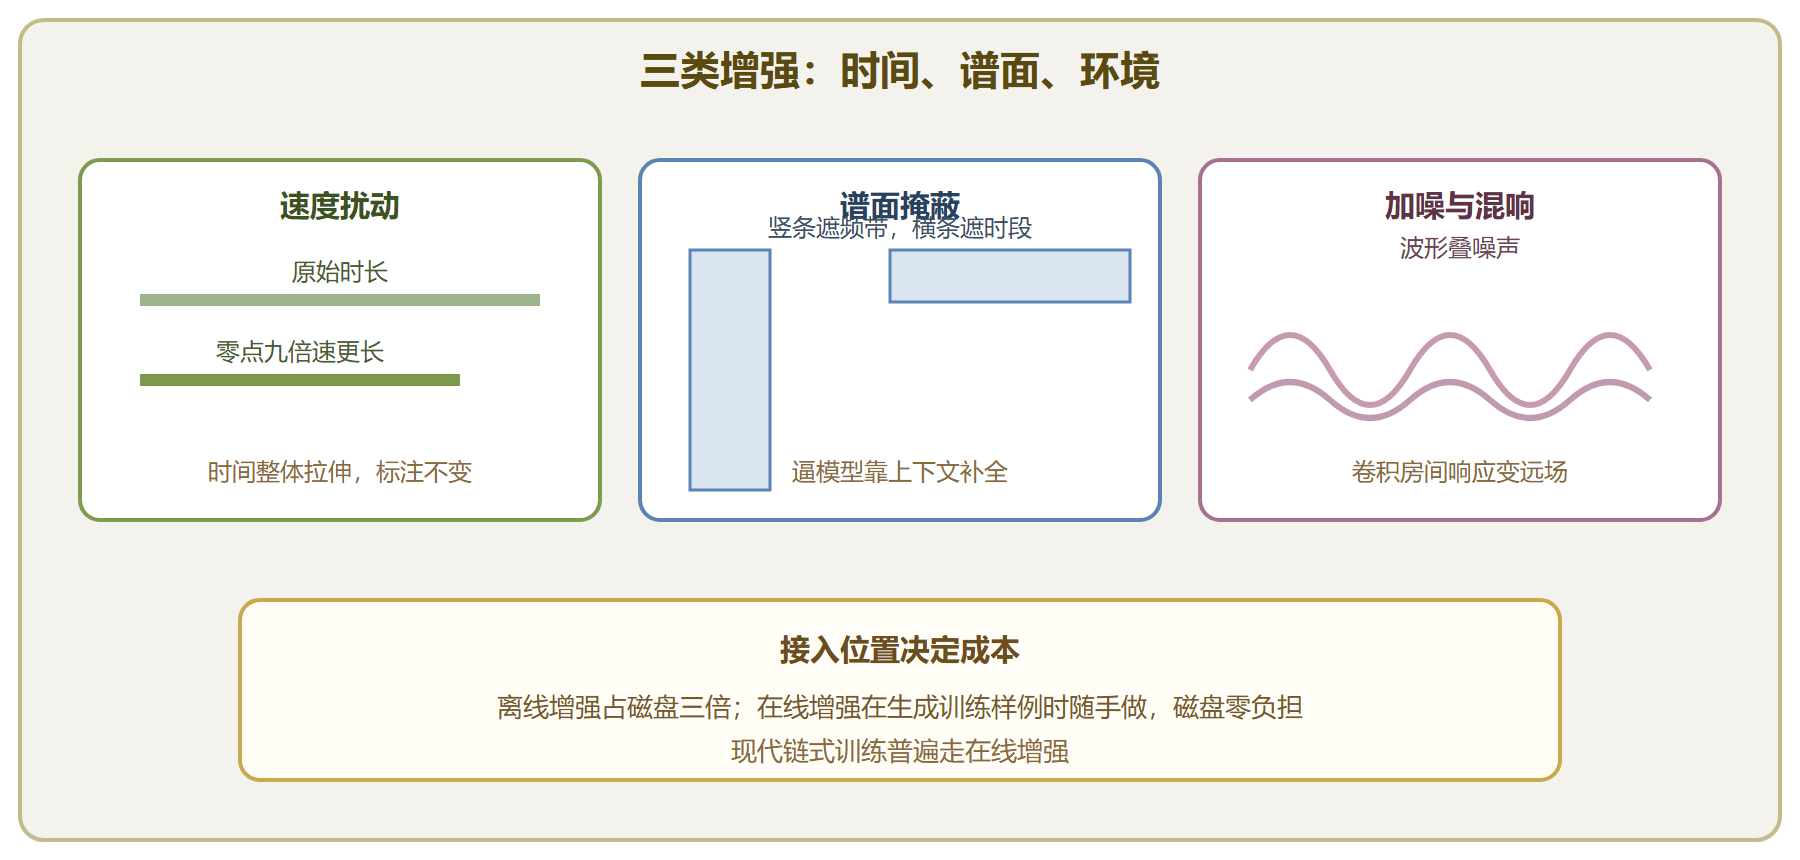
三大类操作各管一个维度。速度扰动管时间:把音频按零点九、一点零、一点一倍速各出一份,一句话变三句,语速变化与轻微音高变化免费到手。谱面掩蔽管内容:在特征谱上随机遮掉几段频带、几段时间,逼模型别死磕局部线索——一段频带没了还能靠上下文认字,就像矿工眯起一只眼照样能分辨矿脉。加噪混响管环境:把干净语音与噪声库混合、与房间冲激响应卷积,模拟真实录音条件。
# 速度扰动:一句话变三句(通用音频工具实现) for rate in 0.9 1.0 1.1; do tag=$(echo $rate | tr -d ".") sox input.wav sp${tag}.wav speed $rate done # 预期产物:三份不同语速的音频 # 速度扰动后的音频要重新提特征,标注文本不变 # 说话人标识建议加后缀区分,归一化按各自统计
图 三类增强操作在谱面上的落点
接入管线:离线扩容与在线随手做
增强有两种接入姿势。离线增强把扰动后的音频当新数据登记入册,训练管线毫无感知——简单粗暴,磁盘翻倍。在线增强在生成训练样例的那一步动态施加:每个轮次、每份样例随机决定掩蔽位置与噪声选择,同样的音频每轮"长得都不一样"。在线姿势磁盘零成本、变化更丰富,是链式模型时代的默认选项。
# 在线增强的配置片段(示意,注释为后加) # 频带掩蔽:最多两道,每道最宽二十六个滤波器组 freq_mask_count = 2 freq_mask_width = 26 # 时段掩蔽:最多两道,每道最宽约一秒 time_mask_count = 2 time_mask_max_frames = 100 # 加噪:按信噪比在若干档位随机 noise_snr_options = 10,15,20 # 解读:参数量级取自公开食谱的常用配置, # 掩蔽强度按任务数据量与模型容量微调
# 加噪的信噪比计算(演示混合的账怎么算) import numpy as np rng = np.random.default_rng(3) speech = rng.normal(0, 0.3, 48000) # 一句语音(示意) noise = rng.normal(0, 1.0, 48000) # 一段噪声 target_snr_db = 15.0 # 目标:噪声功率调到 语音功率按信噪比折算后的水平 sp = (speech ** 2).mean() scale = np.sqrt(sp / (10 ** (target_snr_db / 10))) mixed = speech + scale * noise print(f"缩放后混合信噪比约 {10 * np.log10(sp / ((scale * noise) ** 2).mean()):.1f} 分贝") # 输出:缩放后混合信噪比约 15.0 分贝 # 解读:信噪比是增强强度的秤, # 档位太低等于往矿里掺土,模型学一嘴噪声
案例与反噬
背景:五十小时客服语料,全是干净近讲录音,上线后电话信道错误率比测试集高出一截。操作:训练管线开在线增强——速度三档扰动、双频带加双时段掩蔽、十五到二十分贝加噪,训练轮数比原先多两轮。结果:开发集错误率持平略降,真实电话测试集错误率降了四分之一。解读:开发集本来是"干净世界",增强对它没有可挖的余量;收益全部兑现到分布外的真实信道——增强的本质是花钱买泛化,不是买开发集分数。
增强会过量,症状有三:训练目标函数迟迟压不下去(遮挡太狠,模型学不到完整线索);识别结果出现幻听插入(噪声档位太低,模型把噪声当语音);某些频段相关的词系统性错认(频带掩蔽过宽)。处方是对症减档:掩蔽道数与宽度减半、信噪比档位抬高、速度扰动收窄。增强参数与学习率类似,改一档跑一轮看曲线,别一次全调。
增强问答三则
问:增强能不能替代采数据? 不能,只能延缓采数据的紧迫感。增强制造的是"已知变化的变体",造不出新说话人、新口音、新词汇的真实信息。数据不足时增强是止痛药,不是抗生素;预算允许时,真实语料的单位收益永远更高。
问:增强数据要不要单独划分验证集? 验证与测试必须保持原始口径,增强只发生在训练侧。有人把增强后的音频混进开发集"看增强效果",测出来的其实是"模型对增强分布的适应度",与真实指标是两回事。
问:三类操作一起上还是逐项加? 逐项加,每加一类跑一轮对比。三类增强的交互不是简单相加,谱面掩蔽加强后,加噪的最佳信噪比档位可能要整体抬高。一次全开再出问题,你分不清是哪类在作祟——这与调参纪律完全同源。
与既有工序的联动
增强不是孤立开关,它与前几章的工序有三处联动值得记住。其一,与 6.1 节的自适应互补:增强拉近训练分布与目标分布的宏观距离,自适应处理剩余的个体差异,先用增强降低错配、再用自适应精修,是目标域迁移的标准组合拳。其二,与 4.3 节的链式训练天然契合:链式样例生成阶段就是在线增强的挂载点,现代食谱把两者捆在一起调。其三,与 3.2 节的特征口径联动:速度扰动后的音频必须重新提特征、重新算归一化统计,图省事沿用旧特征等于白增强。
⚠️ 常见坑一:增强后的数据忘了重新做归一化统计,特征口径混乱。坑二:测试集也顺手增强了——增强只属于训练侧,评估必须用原始口径。坑三:噪声库与训练语料有说话人重叠(拿测试说话人的录音当噪声源),指标虚好,上线露馅。
💡 关键直觉:把增强理解为"给模型的疫苗"——小剂量、多类型、循序渐进。剂量过大不是免疫是感染,这个分寸感比记住任何一组具体参数都重要。
增富台账
- 三类操作三个维度:时间扰动、谱面掩蔽、环境加噪,组合使用别单押。
- 在线增强是默认姿势:样例生成时随手做,磁盘零负担、变化更丰富。
- 收益兑现在分布外:开发集不涨不代表没用,真实信道才是考场。
- 过量有症状:训练不收敛、幻听插入、频段错认,逐档回退。
料更足了,下一节把火燎向速度:怎么让这条产线快到能跟人实时对话。