6.3 产线提速:在线识别的实时性优化三板斧
6.3 产线提速:在线识别的实时性优化三板斧
本节摘要:在线识别的提速是系统工程:模型层瘦身(小模型、蒸馏、量化、跳帧)、搜索层设防(束宽与活跃路径上限、图规模控制)、系统层榨干硬件(多路复用批处理、线程与内存管理)。本节给出延迟预算的拆解方法、三层手段的落地细节、监控指标的正确姿势与一个完整的提速案例。承接 6.2 的增强语料,与 5.2 的在线架构呼应。
产线要转得快
先立靶子。"快"要拆成三个可测的数:实时率(处理耗时对音频时长的比值,必须稳定小于一)、首字延迟(开口到出第一个字的等待,决定手感)、尾延迟(完句到最终结果的等待)。三者常常互相牵制——压首字延迟要小模型快出字,压整体质量又要大模型重打分,工程的艺术就是在预算内摆平三者。
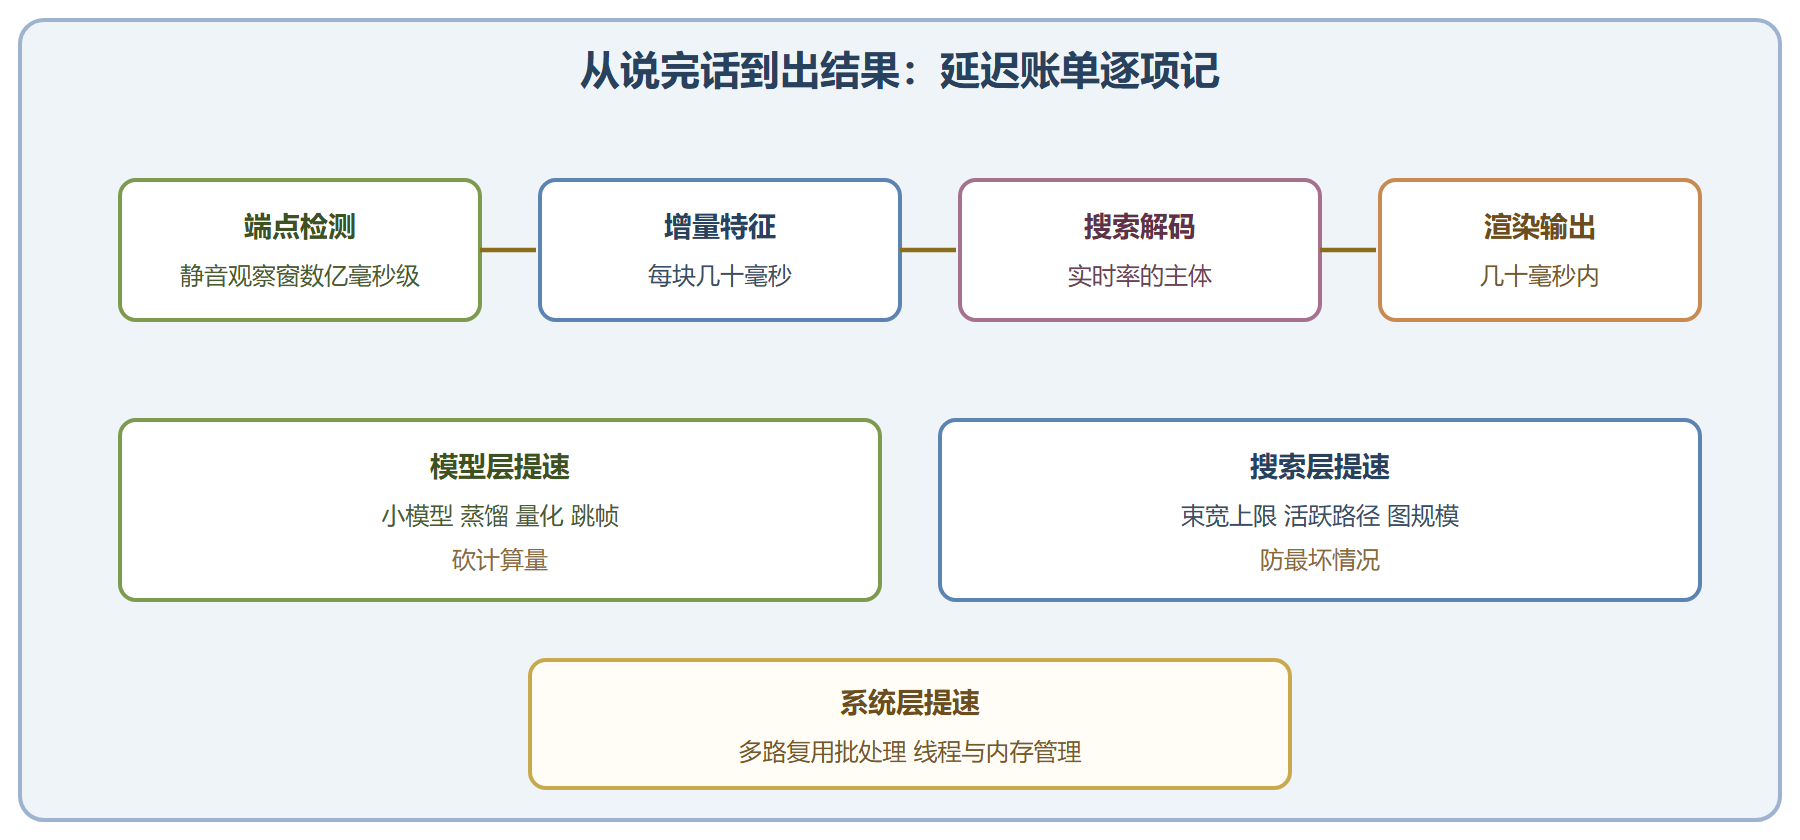
预算怎么拆?拿"用户说完到出结果"这条链路记账:端点检测判定完毕约需几百毫秒的静音观察窗,特征与搜索的耗时按实时率折算,渲染输出几十毫秒。每一环都写进预算表,超标环节一目了然。没做过预算拆解的优化是盲目的——你不知道时间花哪了,就只能到处乱试。
记账本身用十几行脚本就能自动化,账目摆出来才知道斧头该往哪挥:
# 延迟预算记账:把"说完到出结果"这条链路拆成可核对的账目 budget = { "端点检测观察窗": 480, # 毫秒:判定用户说完所需的最坏静音等待 "特征提取": 35, # 一句话的增量特征耗时 "解码搜索": 210, # 打分、扩弧、剪枝三小段合计 "模型前向": 90, # 网络推理耗时(已含量化收益) "后处理渲染": 45, # 结果整理与格式化输出 } total = sum(budget.values()) for name, ms in budget.items(): bar = "#" * round(ms / total * 30) # 条形长度按占比折算 print(f"{name} {ms}ms {bar}") print("合计尾延迟:", total, "ms") # 输出: # 端点检测观察窗 480ms ################# # 特征提取 35ms # # 解码搜索 210ms ####### # 模型前向 90ms ### # 后处理渲染 45ms ## # 合计尾延迟: 860 ms # 解读:观察窗独占过半预算——这时候先去压解码搜索是白费斧头, # 该动的是观察窗策略(容忍更早截断)或改流式出字绕开它
图 一句话的延迟账单
模型层:给引擎瘦身
三板斧的第一斧砍计算量。小模型是直接路线:层数减半、层宽收窄,配 6.2 节的增强语料补泛化——小模型加大数据,常能追平大模型加小数据。蒸馏是曲线救国:让大模型当老师、小模型当学生,学生学老师的软标签,同样的参数量能多榨几个点。量化把浮点权重压成低精度整数,推理速度与内存占用齐降,精度损失通常在小数点后。跳帧在 4.3 节已经见过:输出每三十毫秒一拍,计算量先砍三分之二。四招可叠加,叠加后的精度回退要在真实测试集上验收,别只看开发集。
搜索层:为最坏情况设防
第二斧砍搜索开销。在线解码的束宽、活跃路径数、词格深度都要设上限,理由在 5.2 节讲过:平均快不算快,长句噪音频段把延迟拖爆才是事故。上限的定法是压测:用最长的句子、最差的信噪比、最高的并发去打,看延迟尖峰,调到尖峰落在红线内为止。图规模也归这层管——5.1 节的瘦身手段(限词表、子词化)在这里兑现成搜索速度。
搜索层还有个进阶武器值得认识:延迟优先的搜索策略。传统解码器假设整句已知,可以把计算摊匀;在线解码器必须"边到边算",算力分配向已到达的音频倾斜,同时为未到的后文保留搜索余地。实现上常用"浅层快路径加深层慢路径"的双队列——快路径只维持窄束保证实时出字,慢路径在算力空闲时回补更宽的搜索。这类改造多数在内核层完成(呼应 6.4 节的改与不改),脚本层能做的是选对解码器版本与参数档位。
特征侧的增量计算是常被忽略的暗账。分帧、加窗天然可增量,但归一化统计是"整句的账",在线时只能滚动估计:用已到达的音频先算一个临时统计量,随音频推进不断修正。头几秒的统计量噪声大,识别质量偏低是流式的固有代价——好在多数任务的语义重心不在头几秒。理解这笔账,你就明白为什么在线系统的开头几个字常需要"后文确认"机制来回改。
系统层:榨干硬件
第三斧砍浪费。单路推理喂不饱现代硬件,批处理多路复用是标配:把多路用户的同一段音频块攒成一批喂给显卡,吞吐翻着涨。批的粒度与延迟是一对矛盾——攒批要等齐,等齐就添延迟,常用策略是"凑够或超时二选一先触发"。线程侧给解码线程绑核、避免锁竞争;内存侧预分配池化,别在解码热路径上现申请现释放。
# 吞吐压测骨架:并发路数逐级上调,记录延迟分布 for clients in 1 4 8 16; do echo "== 并发 $clients 路 ==" bench_client --concurrency $clients --audio-set noisy_long \ --report p50,p95,p99,rtf done # 预期输出(示例形态): # == 并发 1 路 == 实时率 0.31 P95延迟 420ms # == 并发 8 路 == 实时率 0.09 P95延迟 460ms # == 并发 16 路 == 实时率 0.19 P95延迟 540ms # 解读:批处理红利在并发八路时最肥; # 十六路时开始互相踩脚,P95 上抬,容量上限就在附近
监控指标的正确姿势:盯分位数不盯平均值。平均延迟三百毫秒的系统,可能每二十句就有一次两秒的卡顿——用户记住的是卡顿。上线看板至少摆三个数:实时率的九五分位、首字延迟的九五分位、超时句占比。平均值是给人看的,分位数是给系统看病的。
提速案例复盘
背景:语音助手后台实测实时率一点八,高峰期延迟毛刺两秒,用户抱怨"说完半天才出字"。操作分三步:先做预算拆解,发现七成耗时在解码搜索、两成在模型前向;搜索层把活跃路径上限从两万压到八千、词格深度减半,实时率降到一点一;模型层导出量化版本,配合批处理复用,实时率零点五五,毛刺消失。结果:九五分位首字延迟稳定在半秒内。解读:预算拆解决定了先砍哪斧——若先动手量化模型,搜索层的最大头纹丝不动,效果减半。变式:延迟要求更苛刻的场景(同传字幕),可以再上"边说边出"的增量输出策略,代价是后文修正率升高。
案例里还藏着一条容易被忽视的经验:每一步优化后都要复测错误率,而不只看速度。这套操作里搜索层收紧让错误率微升了零点几个点,模型量化又升了零点几个点,两步叠加仍在可接受带内;但如果当初一味压速度,加起来的回退就会悄悄越过产品红线。速度与质量的账要记在同一张表上,每一斧落下时两个数一起动——只记速度的优化日志,是给未来的自己埋雷。
再答一个高频疑问:预算做到什么粒度才够?经验是拆到"能指导动手"为止。三段式(端点、特征加搜索、输出)适合立项时评估;真正动手时要把"搜索"再拆成打分、扩弧、剪枝三小段,因为三者的提速手段完全不同——打分靠模型层、扩弧靠图与路径上限、剪枝靠调度策略。粒度不到,斧头就挥不准。
⚠️ 常见坑一:只测干净短音频的实时率,上线遇到长句噪声直接翻车,压测素材必须包含最坏情况。坑二:批处理攒批无超时,低峰期单路用户干等凑批,首字延迟莫名飙升。坑三:量化后的模型没重跑词错误率验收,速度上去了精度悄悄掉了。
💡 关键直觉:提速的三层是"计算量、搜索量、浪费量"三个不同的账。动手前先记账,每一毫秒都知道花在哪,优化才不是玄学。
提速交接
- 三个数立靶子:实时率、首字延迟、尾延迟,分别代表吞吐、手感、完整性。
- 预算先行:先记账后动斧,最大头不定就优化,等于闭眼射击。
- 三层按序排查:模型砍计算、搜索防最坏、系统挤浪费,各管一段。
- 监控看分位:平均值是化妆品,九五分位才是体检报告。
引擎转快了,下一节打开工具箱:别人的脚本怎么改、源码怎么扩,把这座矿场改造成你自己的。